2026-10-08 — Experiment
시뮬 게이트: 시도 히스토리 정책 vs 기억 없는 정책
try-and-suc | MuJoCo 퍽 밀기·공 굴리기, 숨은 마찰/질량/경사, K=5 시도
TL;DR
- 게이트 통과: 처음 보는 물성 범위(보간)에서 3차 누적 성공률 히스토리 정책 87.5%(퍽)·89.9%(공), 기억 없는 정책 0.0%·0.0%. 차이 +88.7%p [87.3, 90.1].
- 격차는 히스토리에서 온다: 히스토리 삭제 시 0.0%p, 다른 물성의 히스토리로 셔플 시 +8.2%p [7.0, 9.6].
- 과거 행동이 컨텍스트에 필요: 영상만 넣으면 보간 59.0%, 외삽 2.3% (영상+행동 88.7%, 52.9%).
- 차별점은 미입증: 수치 피드백 기준선(IRP식 83.5/84.1, LLM 82.0/88.0)이 비슷하고 외삽에서는 더 높다.
+88.7%p
보간 @3 격차
+50.6%p
외삽 @3 격차
+8.2%p
셔플 후 격차
1,000
조건당 에피소드
1 배경 / 목적
숨은 물성 때문에 정답 행동이 배타적(세게 vs 약하게)이고 그 정보가 시도 결과로만 드러나는 과제에서, 이전 시도들의 영상과 행동을 컨텍스트로 읽는 정책이 같은 데이터로 학습한 기억 없는 강인 정책보다 2~3차 성공률이 크게 높은지 확인한다. 가중치 업데이트 없이 컨텍스트만으로 적응해야 한다.
진행 기준: 처음 보는 물성 범위에서 3차 누적 성공률 차이 15%p 이상, 히스토리 셔플 시 차이 대부분 소멸.
2 작업 내용
MuJoCo 3.15에서 퍽 밀기(미끄럼 마찰)와 공 굴리기(구름 저항)를 만들었다. 경사는 중력 벡터를 기울여 구현해 탑다운 카메라에 보이지 않는다. 모든 학습 정책은 같은 에피소드와 같은 라벨(오라클 행동)로 회귀하고, 읽을 수 있는 컨텍스트만 다르다.
환경: 행동 (임펄스 J, 방향), 성공 = 목표 6cm 이내 정지, 실행 노이즈 1x = 임펄스 3% / 방향 1.5°
관측: 128x128 탑다운 RGB, 시도당 8프레임, 에피소드당 5시도
데이터: 과제당 30,000 에피소드 (컨텍스트 = 파티클 필터 교사 60% + 무작위 섭동 40%), 110GB
분할: 학습 범위 / 보간(학습에서 뺀 띠, 평균에서 벗어난 위치) / 외삽
정책: CNN + 4층 트랜스포머(d=256), 12k step, 검증 최고점 체크포인트
none(기억 없음) / V / VA(주 모델) / VAN / AN, 퍽+공 공동 학습
기준선: 오라클, PF 교사, 블라인드 스윕, IRP식, ICPI식 LLM 튜너(N=100)
평가: 조건당 1,000 에피소드, 정책 간 대응(같은 에피소드·같은 노이즈), 부트스트랩 95% CI
도중에 고친 것: (1) 질량 변경 후
mj_setConst 누락으로 접촉 불안정 → 수정 후 해석해 대비 1.5% 이내. (2) 보간 띠가 범위 중앙이면 평균 행동이 우연히 맞음 → 띠를 옮기고 데이터 재생성. (3) 이미지가 에피소드를 식별해 정답을 외움 → 검증 최고점 체크포인트 선택.3 결과
| 보간 범위, 누적 성공률(%) | 퍽 @2 | 퍽 @3 | 공 @2 | 공 @3 |
|---|---|---|---|---|
| 오라클(물성 앎) | 95.2 | 99.3 | 96.1 | 98.9 |
| 히스토리 정책 (영상+행동) | 61.9 | 87.5 | 66.9 | 89.9 |
| PF 교사(수치 궤적) | 58.2 | 85.1 | 61.8 | 86.5 |
| IRP식(과제 전용, 수치) | 60.8 | 83.5 | 63.7 | 84.1 |
| ICPI식 LLM 튜너(N=100) | 54.0 | 82.0 | 71.0 | 88.0 |
| 기억 없는 정책 | 0.0 | 0.0 | 0.0 | 0.0 |
| 기억 없는 정책 + 블라인드 스윕 (5차에 37.0/34.1) | 0.0 | 0.3 | 0.0 | 0.0 |
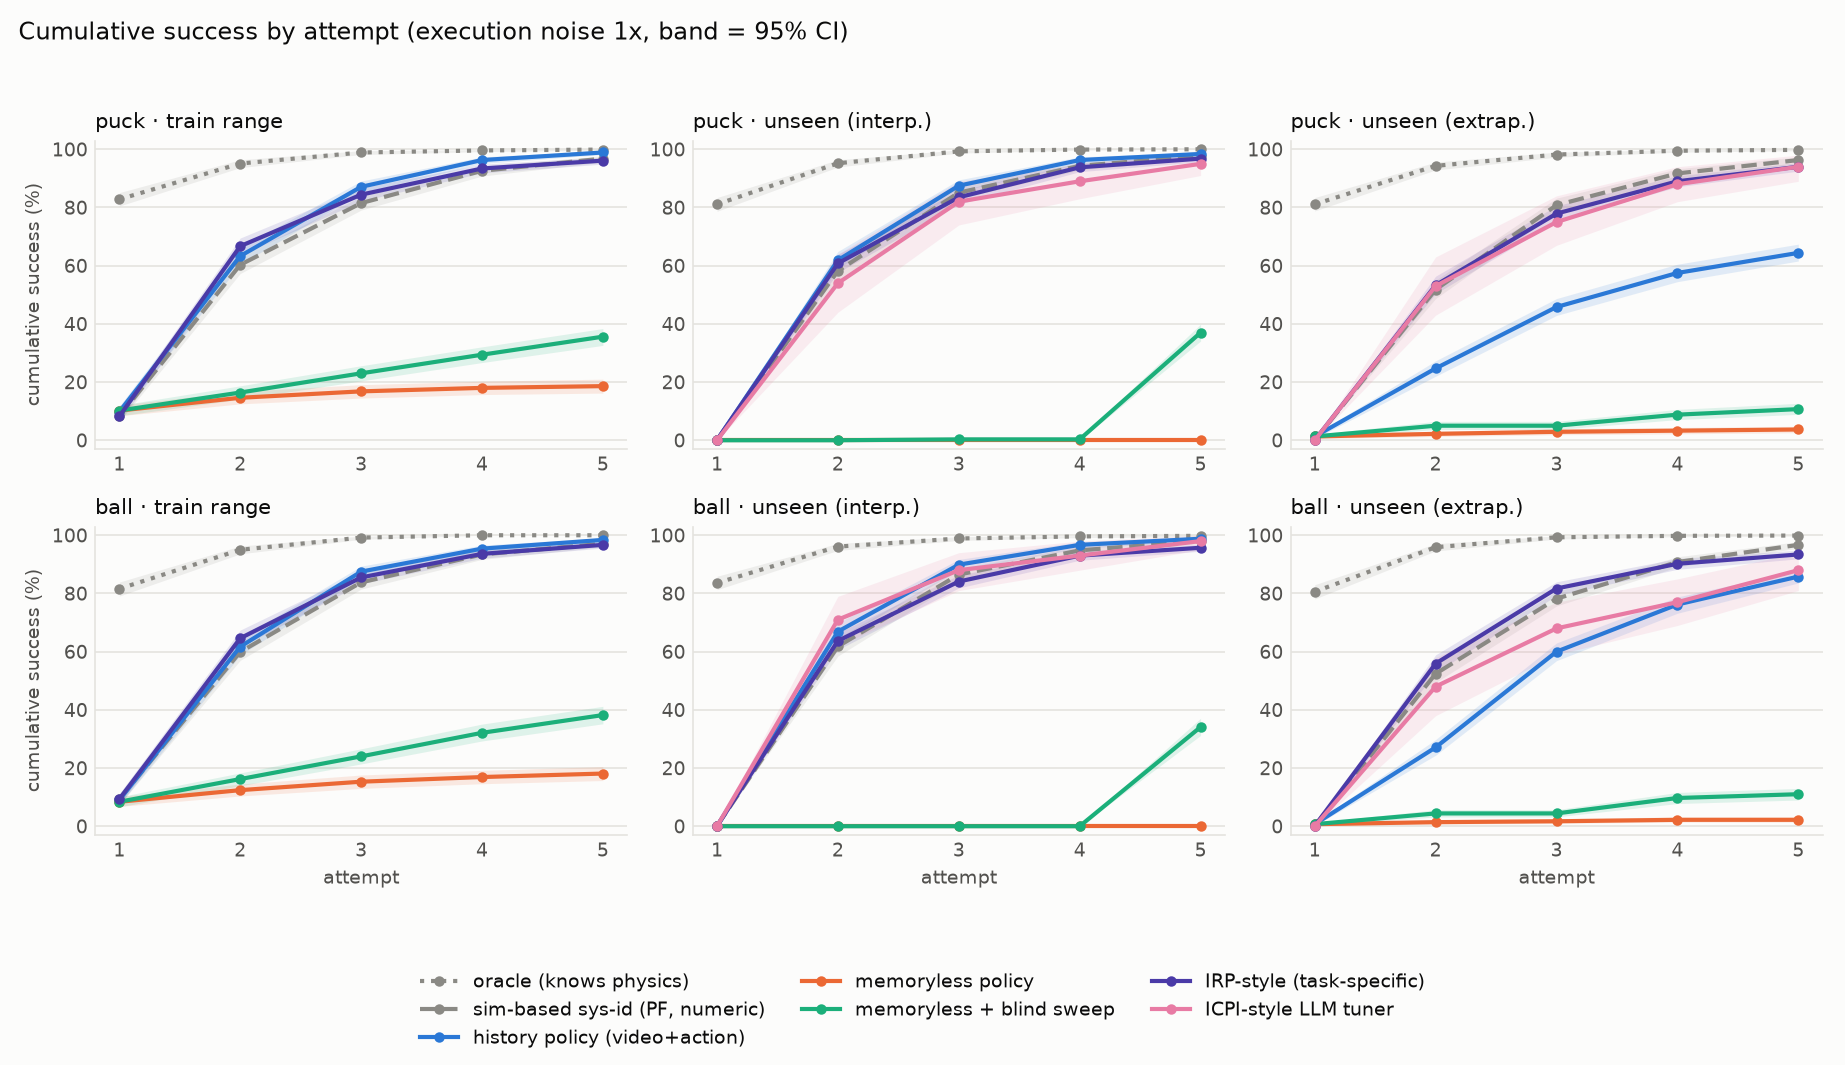
Figure 1: 시도 횟수별 누적 성공률 (정책별, 분할별). 띠는 95% 신뢰구간.
| 3차 누적 격차 (히스토리 − 기억 없음, %p) | 퍽 | 공 | 합산 |
|---|---|---|---|
| 학습 범위 | +70.3 [67.2, 73.5] | +72.2 [69.2, 75.1] | +71.2 [69.0, 73.4] |
| 보간 | +87.5 [85.3, 89.5] | +89.9 [87.8, 91.7] | +88.7 [87.3, 90.1] |
| 외삽 | +42.9 [39.8, 46.0] | +58.3 [55.4, 61.3] | +50.6 [48.5, 52.8] |
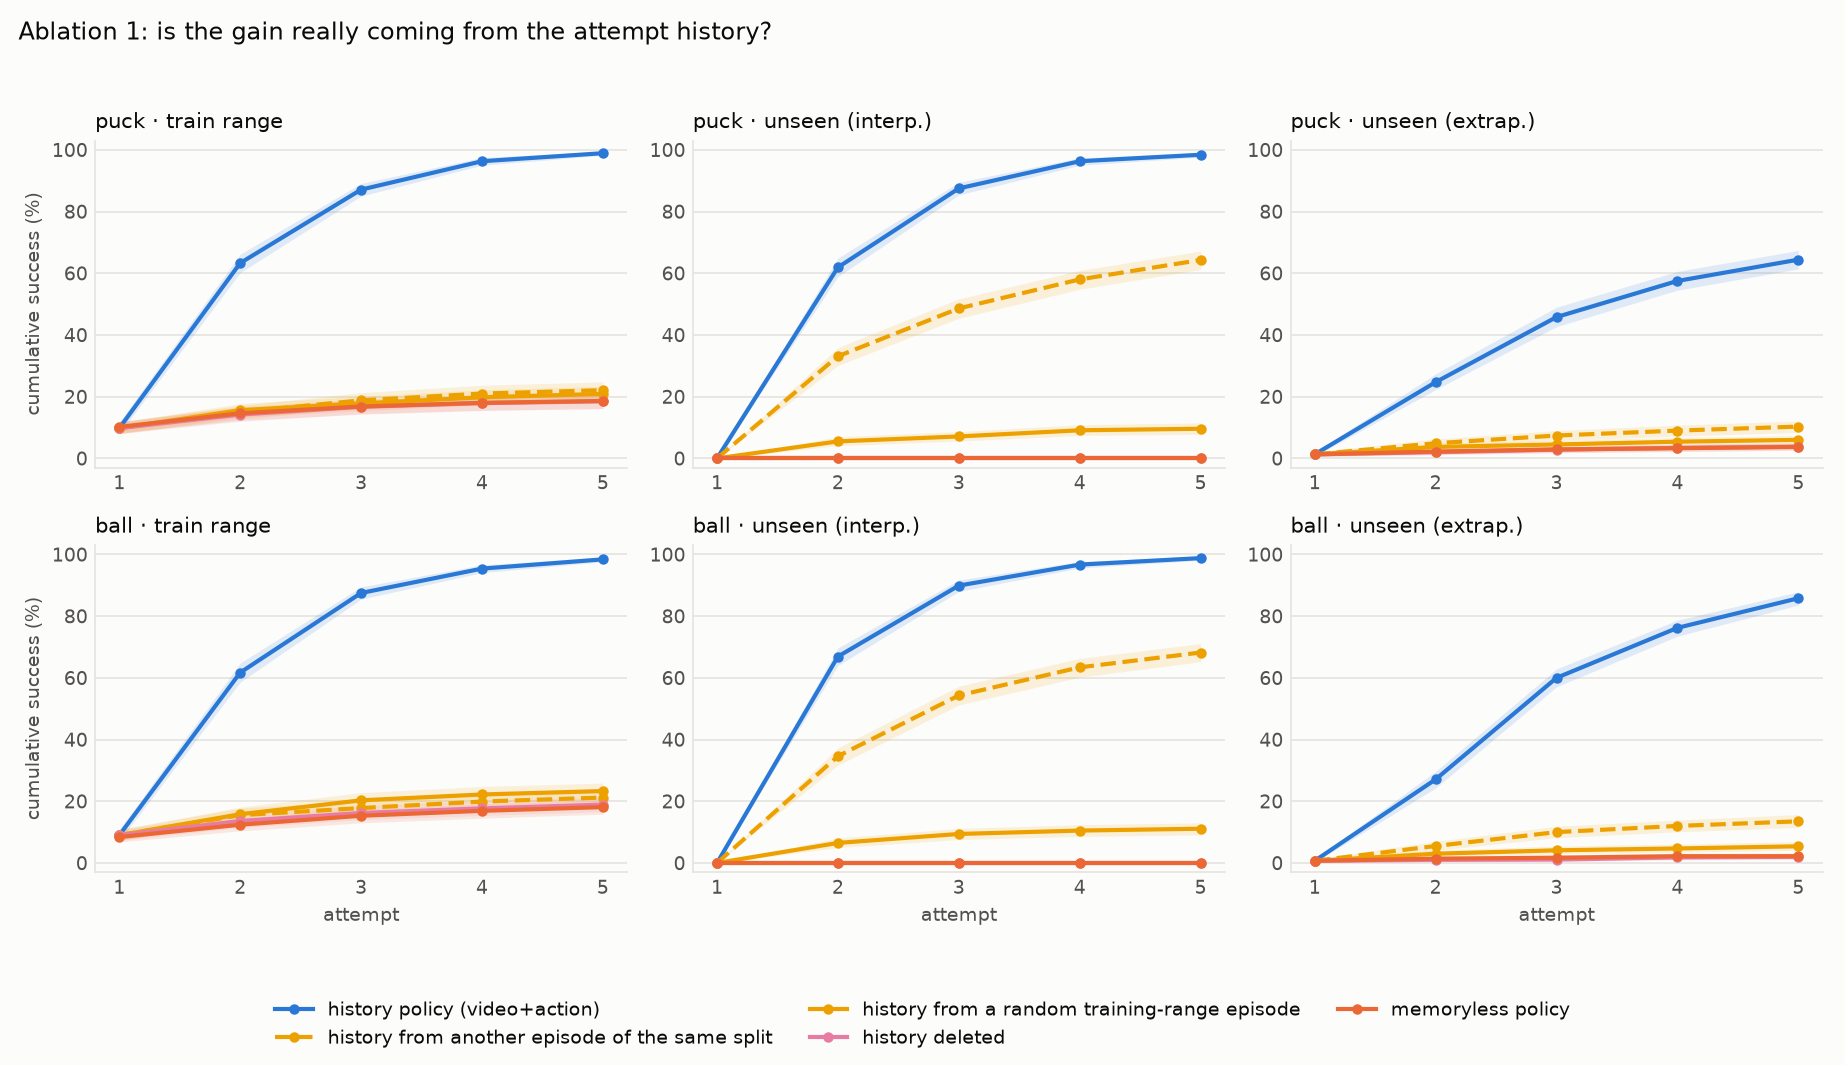
Figure 2: 절제 1. 히스토리 삭제 시 기억 없는 정책과 같아지고, 학습 범위의 임의 물성 에피소드 히스토리로 바꾸면 격차가 +8.2%p로 줄어든다. 같은 분할 내 셔플은 보간 띠가 좁아 +51.4%p가 남는다.
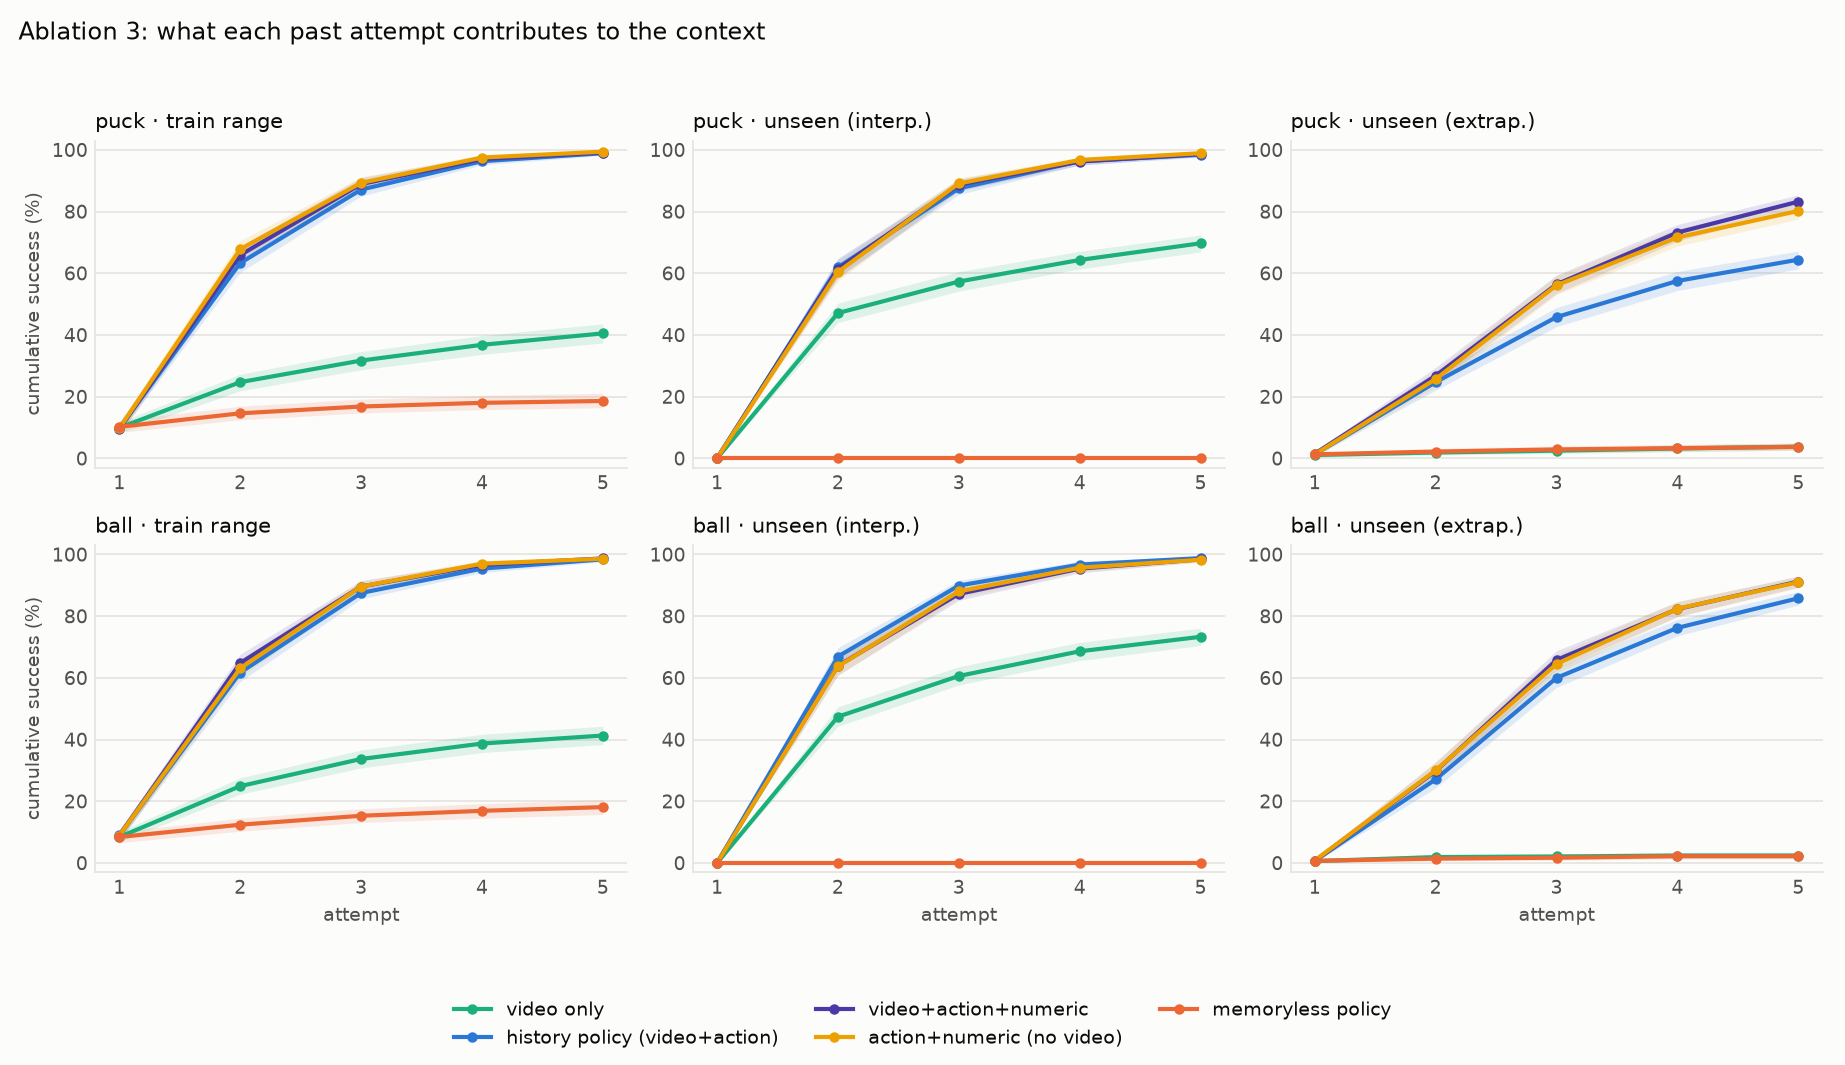
Figure 3: 절제 3. 영상만으로는 질량을 알 수 없어 실패. 영상+행동은 행동+수치와 같은 수준.
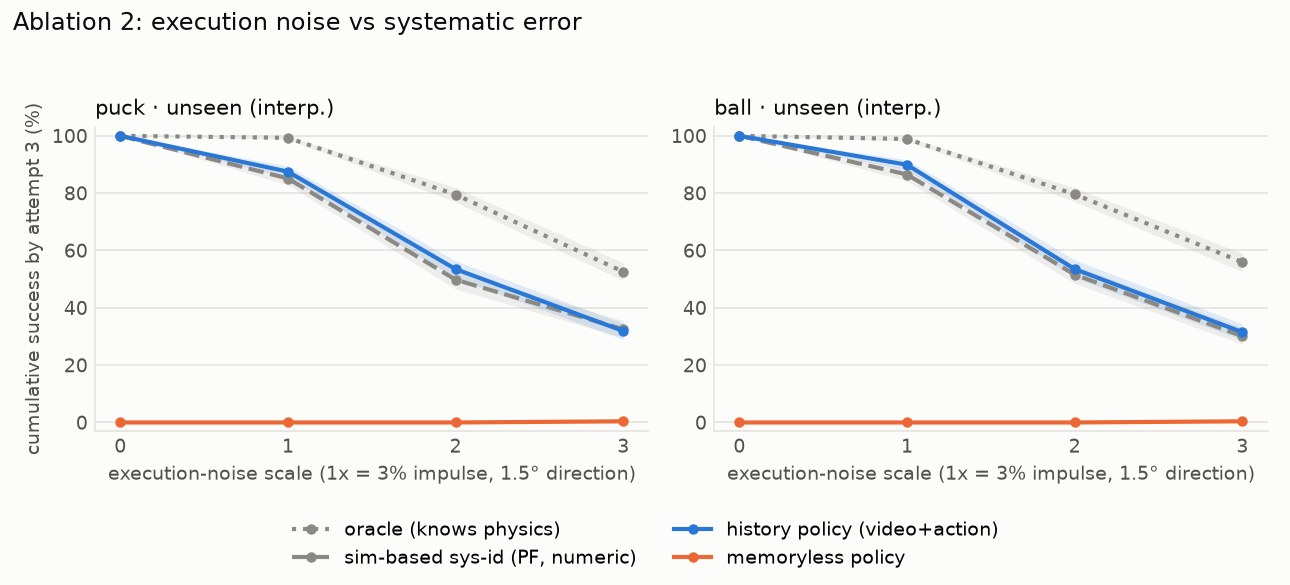
Figure 4: 절제 2. 보간 @3: 노이즈 0x 100/100, 1x 87.5/89.9, 2x 53.5/53.5, 3x 31.9/31.5 (퍽/공).
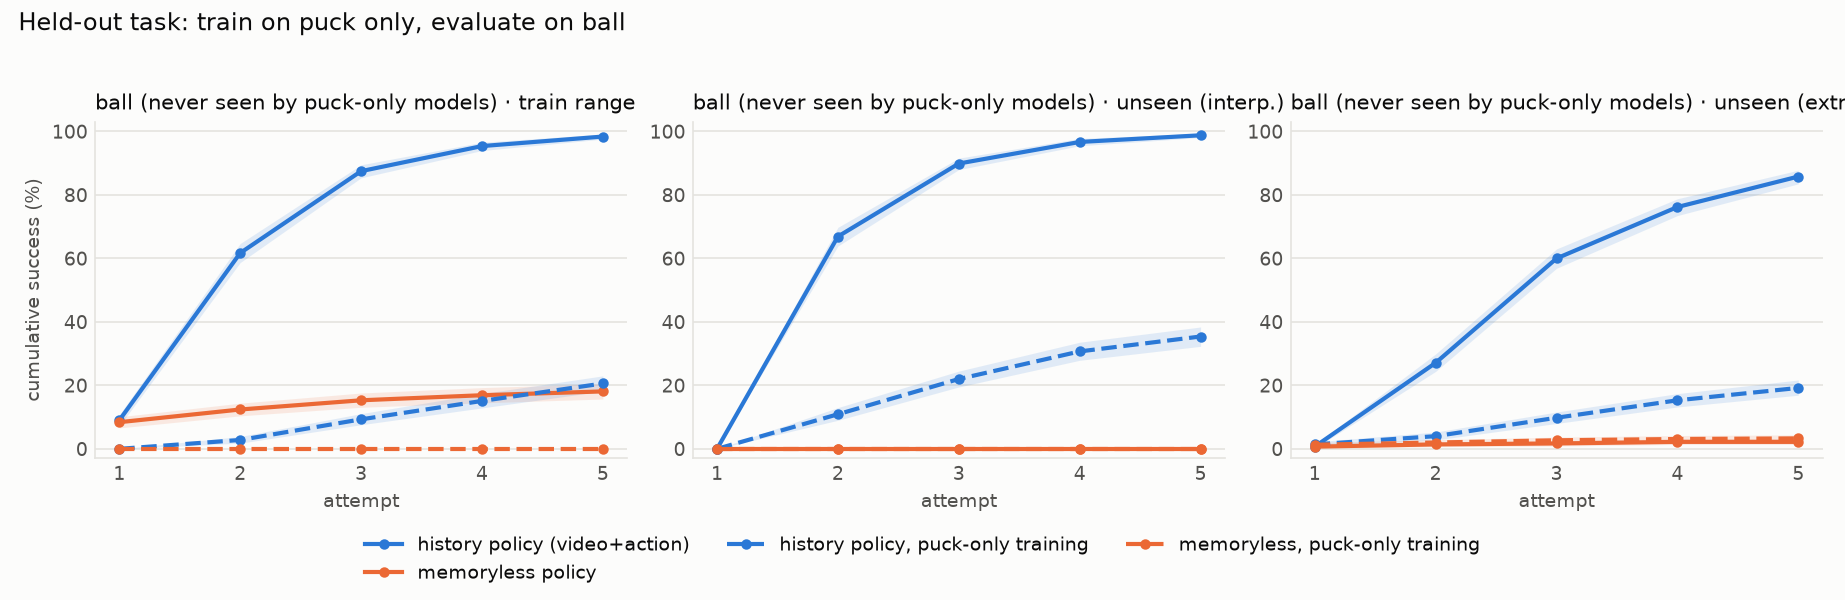
Figure 5: 퍽으로만 학습한 모델을 공에서 평가. 히스토리 정책 @3 9.3/22.0/9.8%, 기억 없는 정책 0.0/0.0/2.7% (학습/보간/외삽).
핵심 발견: 히스토리 1회로 임펄스 오차(log J RMSE) 0.251 → 0.047, 2회로 0.025. 노이즈가 없으면 3번 안에 100% 성공.
읽는 법: 보간 띠를 평균에서 벗어난 곳에 뒀기 때문에 기억 없는 정책은 거기서 구조적으로 0%다. 띠 위치에 덜 의존하는 수치는 학습 범위 격차 +71.2%p.
약한 부분: 외삽 @3 45.8/60.0% (PF 교사 80.8/78.2, IRP식 77.9/81.7). 과제 제외 일반화는 9~22%.
4 Takeaway
의미
기억 가설은 큰 폭으로 성립하고, 그 격차가 히스토리 내용에서 온다는 것도 확인됐다. 다만 2차원 타격 파라미터와 정지 위치로 요약되는 결과에서는 수치 피드백 방식(IRP, ICPI)이 이미 잘 된다. 이번 게이트가 보인 것은 "기억 > 기억 없음"이지 "영상 컨텍스트 정책 > 수치 튜너"가 아니다. 또 과거 실행 행동이 컨텍스트에 없으면 실패하므로, Long-WAM에서 과거 액션이 컨텍스트에 들어가는지가 선결 확인 사항이다.
5 Next Steps
미해결 한계와 다음 실험
- 게이트 2단계: 연속 엔드이펙터 속도 시퀀스 행동으로 확장하고 LLM/IRP 기준선과 재비교 (차별점 검증).
- 외삽 보강: 물성 범위 확대, 자기 정책이 만든 히스토리로 재학습.
- 과제 수를 5개 이상으로 늘려 과제 제외 일반화 재검증.
- 주 모델 2종 3시드 반복 (현재 학습 시드 1개).
- Long-WAM 코드에서 과거 액션 컨텍스트 여부 확인.