goal image Phase 0 — 결과 정리
그래서 place는 성공하나
| 질문 | 답 |
|---|---|
| place 단계까지 가긴 하나 | 6 / 12 — 나머지 6회는 그 전의 pick에서 실패 |
| 맞는 가구 위에 올려놓나 | 3 / 6 |
| 원래 그 자리(15 cm 이내)에 놓나 — 데이터셋의 실제 합격 기준 | 0 / 6 · 거리 0.36 / 0.37 / 0.61 / 0.68 / 0.76 / 0.99 m |
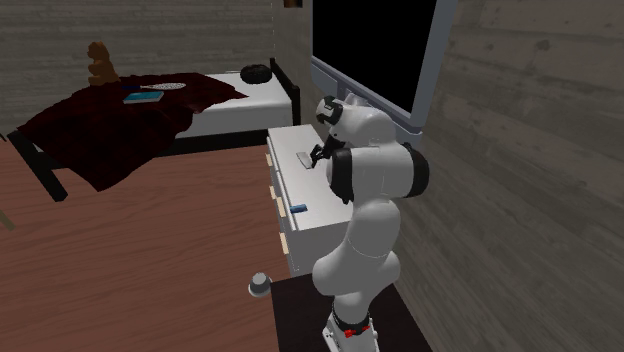
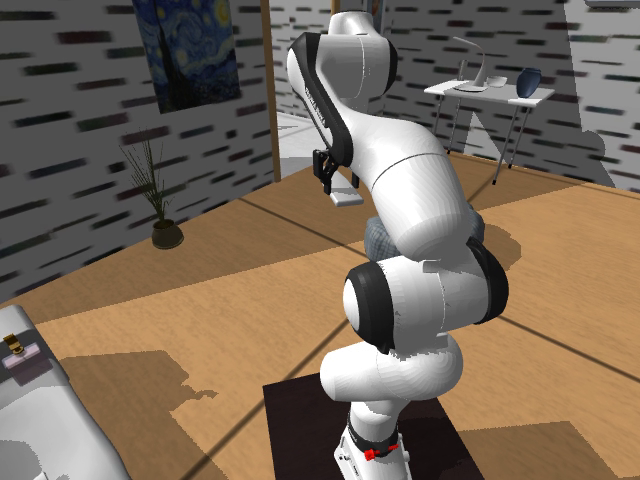
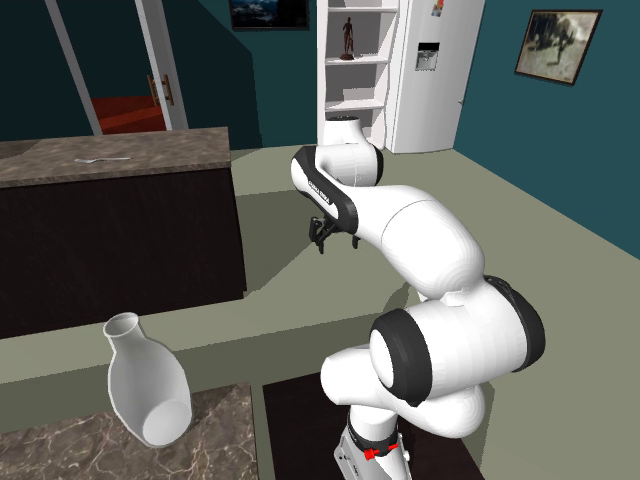
| goal 이미지가 도움이 되나 | 판정 불가 — place까지 간 칸은 goal 사진이 로봇 팔 사진이었고, goal 사진이 제대로인 칸은 pick에서 막혔다 |
성공 3회는 전부 5~12스텝 만에 그리퍼를 열고 끝(하네스가 팔을 가져다 놓은 자리에 그대로 놓음), 실패 3회는 전부 300스텝을 다 쓰고 물체를 떨어뜨림. 지금 VLA place는 “정밀 배치”가 아니라 “바로 놓거나, 헤매다 떨어뜨리거나”다.
성공·실패 예시 영상
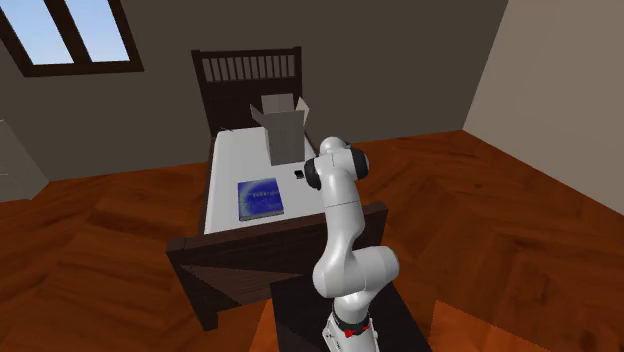
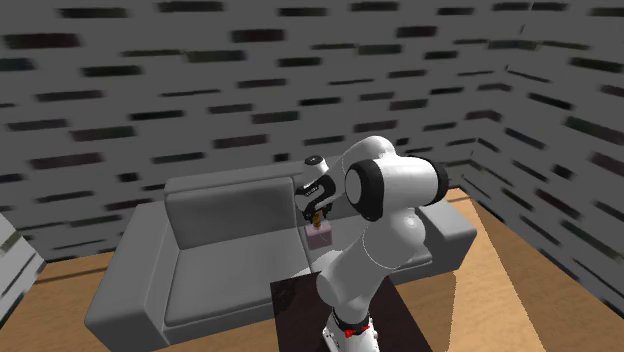
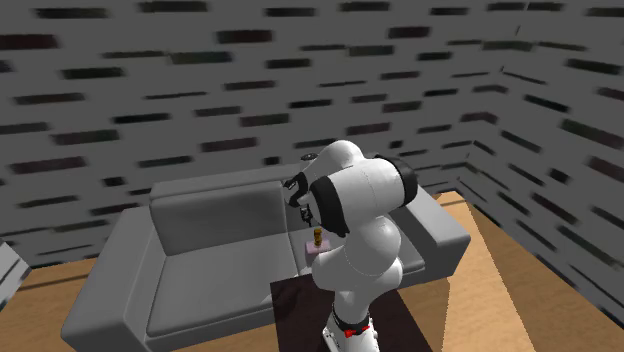
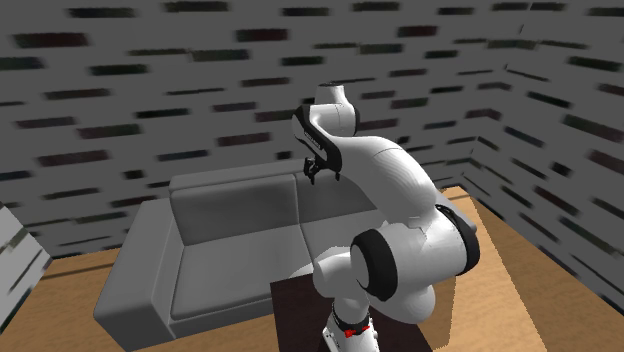
한 줄 = 한 롤아웃. 왼쪽부터 ① VLA pick → ② 하네스가 팔을 preplace로 → ③ VLA place → ④ 최종 상태.
remote control → bed · oracle 성공: 침대 위 · 5스텝 원위치까지 0.357 m
soap bottle → sofa · oracle 성공: 소파 위 · 12스텝 원위치까지 0.679 m
soap bottle → sofa · off 성공: 소파 위 · 11스텝 원위치까지 0.614 m
soap bottle → sofa · wrong 실패: 300스텝 후 떨어뜨림 원위치까지 0.759 m
bowl → chest of drawers · off 실패: 300스텝 후 떨어뜨림 원위치까지 0.368 m
1 무엇을 재려 했나
restore 질의(“원래 있던 자리에 되돌려 놔”)의 정답은 좌표다. 데이터셋 README가 채점을 state goal, 원위치에서 r_place = 0.15 m 이내로 규정해 놓고 채점기는 만들지 않았다. MolmoBot 쪽에는 goal-image 조건화가 학습·평가까지 끝나 있고 이득이 크다(hand-off 실측):
| 조건 | replace@5cm | @10cm | 거리 중앙값 |
|---|---|---|---|
| goal on | 35.4% | 63.8% | 6.7 cm |
| goal off | 4.6% | 13.8% | 25.6 cm |
| 틀린 goal | 2.3% | 7.7% | 43.2 cm |
질문: 그 goal을 기억에서 꺼낸 프레임으로 줘도 이득이 남는가. 세 조건(oracle / off / wrong)을
같은 칸에서 돌려 replace@{5,10,15}cm로 잰다. VLM을 부르지 않아 API $0.
2 결과 — 전 행
train_2853__2:q03 — soap bottle → sofa 전형 · goal 물체 0.49%
| 조건 | pick | place 진입 시 보유 | goal 도달 | place 스텝 | d_xy | 표면 판정 | |
|---|---|---|---|---|---|---|---|
| oracle | ✓ | ✓ | ✓ | 12 | 0.679 m | ✓ | |
| off | ✓ | ✓ | — | 11 | 0.614 m | ✓ | |
| wrong | ✓ | ✓ | ✓ | 300 | 0.759 m | ✗ |
train_7385__0:q00 — remote control → bed 전형 · goal 물체 0.30%
| 조건 | pick | place 진입 시 보유 | goal 도달 | place 스텝 | d_xy | 표면 판정 | |
|---|---|---|---|---|---|---|---|
| oracle | ✓ | ✓ | ✓ | 5 | 0.357 m | ✓ | |
| off | ✗ | ✗ | — | 300 | 4.573 m | ✗ | pick 실패 · 채점 불가 |
| wrong | ✓ | ✓ | ✓ | 300 | 0.987 m | ✗ |
train_6242__1:q05 — bottle → countertop goal 좋음 · goal 물체 2.70%
| 조건 | pick | place 진입 시 보유 | goal 도달 | place 스텝 | d_xy | 표면 판정 | |
|---|---|---|---|---|---|---|---|
| oracle | ✗ | ✗ | — | 300 | 7.193 m | ✗ | pick 실패 · 채점 불가 |
| off | ✗ | ✗ | — | 300 | 7.221 m | ✗ | pick 실패 · 채점 불가 |
| wrong | ✗ | ✗ | — | 300 | 7.191 m | ✗ | pick 실패 · 채점 불가 |
train_9026__1:q03 — bowl → chest of drawers goal 좋음 · goal 물체 1.62%
| 조건 | pick | place 진입 시 보유 | goal 도달 | place 스텝 | d_xy | 표면 판정 | |
|---|---|---|---|---|---|---|---|
| oracle | ✗ | ✗ | — | 300 | 4.633 m | ✗ | pick 실패 · 채점 불가 |
| off | ✓ | ✓ | — | 300 | 0.368 m | ✗ | |
| wrong | ✗ | ✗ | — | 300 | 4.470 m | ✗ | pick 실패 · 채점 불가 |
3 원인 ① — 영상에 goal로 쓸 프레임이 없다
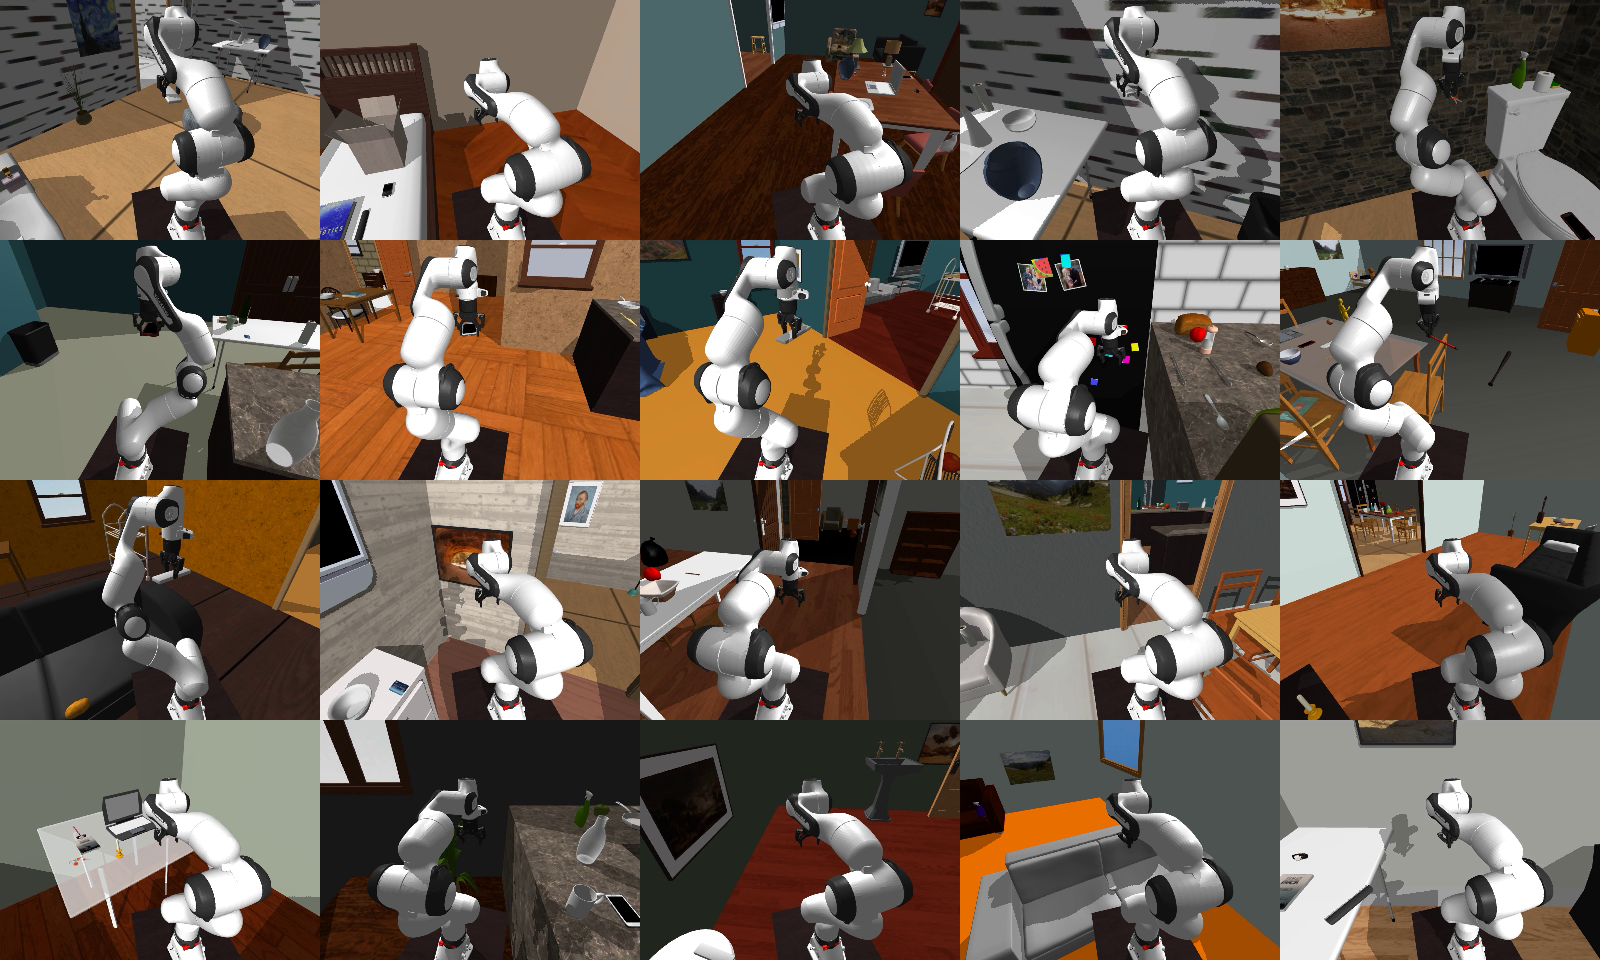
exo_camera_1의 월드 포즈(cam2world_gl)가 로봇 베이스와 상관계수 0.995다.
카메라가 방에 고정된 게 아니라 로봇에 실려 같이 움직인다. 그래서:
- 물체가 보이는 순간 = 로봇이 그 옆에 있는 순간 = 팔이 시야를 막는다
- 멀리서는 보이더라도 프레임의 0.1~0.5%(17~38픽셀)
| 최선 프레임의 물체 크기 | 칸 수 |
|---|---|
| 프레임의 1% 이상 | 2 |
| 0.5 ~ 1% | 5 |
| 0.5% 미만 | 13 |
학습 때 goal은 goal_source = clip_end, goal_camera = randomized_zed2_analogue_1 —
정책 자신의 관측 카메라로, 배치가 끝난 순간, 물체가 크게 잡힌 이미지였다. 종류 자체가 다르다.
4 원인 ② — goal이 좋은 칸은 pick이 실패한다
“영상이 문제라면 goal이 좋은 칸에서는 되겠지”를 확인하려고 20칸 중 goal 품질 상위 2칸을 골라 다시 돌렸다. 결과는 6회 중 5회가 pick 단계에서 실패였다(bottle 0/3, bowl 1/3). 유일하게 pick이 된 bowl·off 조건은 d_xy 0.368 m.
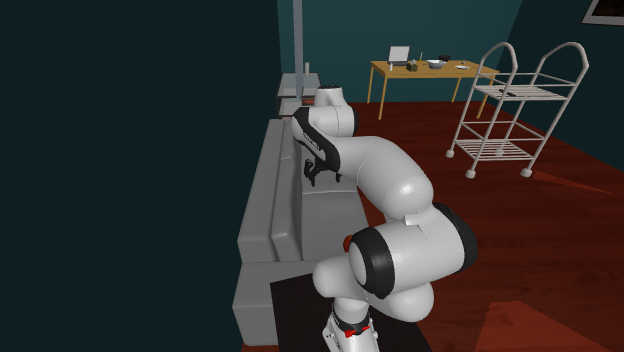
pick 실패는 navigation(선 자리) 때문인가 — 12회 대조
| pick 성공 6회 | pick 실패 6회 | |
|---|---|---|
| navigate 후 물체까지 거리 (중앙값) | 0.60 m | 0.53 m |
| 로봇 정면에서 벗어난 각도 (중앙값) | 25° | 11° |
실패한 쪽이 오히려 더 가깝고 더 정면이다. 가장 선명한 반례는 bowl 칸 — 3 cm 차이의 같은 자리에서 한 번은 105스텝에 성공, 한 번은 300스텝 실패. 반면 soap bottle은 제각각인 자리 3곳에서 3/3 성공, bottle은 어디서든 0/3. 지금 보이는 패턴은 “선 자리”보다 물체·배치 + VLA 자체의 확률성이다(n=12, 단정 불가).
navigate는 학습 분포 밖에 세우나 — 아니다
| 학습 datagen | 우리 navigate | |
|---|---|---|
| 물체로부터 거리 | 0.0 ~ 0.7 m | 0.0 ~ 0.7 m (nav0.py가 의도적으로 복사) |
| 안전 반경 | 0.15 | 0.15 |
| 물체 방향 기준 회전 | ±45° | 실측 −43° ~ +45° |
남는 차이는 분포 안에서 무작위로 서느냐, 정해진 자리에 서느냐다. 자리를 고정하면 조건 간 비교는 확실히 깨끗해지지만 (지금은 oracle과 off가 서로 다른 자리에서 시작한다), 성공률 자체가 오를지는 위 대조표상 불확실하다.
5 tagmem은 저장을 했나
했다. 다만 그 사진 속 물체가 너무 작다.
| 항목 | 값 |
|---|---|
| 편당 tagmem 저장 이미지 (중앙값) | 49장 |
| 그중 원위치 구간 안 | 20장 |
| 원위치 구간에 그 물체를 정확히 이름으로 태깅한 이미지가 있는 칸 | 11 / 20 |
| 그 11칸에서 물체 최대 크기 (중앙값) | 301 px = 0.10% |
나머지 9칸은 원위치 구간 이미지는 있으나 writer가 그 물체를 언급하지 않았다(soap bottle·spray bottle·ladle 등). 예외도 있다 — 6242__1:q05는 소스에 8,280px 프레임이 있는데 tagmem은 414px짜리를 저장했다. 일부 칸에선 저장·선택도 병목이다.
6 중간에 고친 내 진단
"remotecon" 부분문자열 검색 → 태그는 "remote control"이라 “0개”로 오보.
② "bottle" in "soapbottle"이 참 → 다른 물체를 target으로 세어 11칸을 13칸으로 부풀림.
③ obj 태그를 38자로 잘라 출력해 “태그에 없다”고 오독. 본 리포트의 수치는 정확 일치·전문 출력으로 재집계한 것이다.
7 만들어 둔 것 (전부 테스트·리뷰 통과)
| 산출물 | 상태 |
|---|---|
replace@r 채점기 — 데이터셋이 규정만 하고 안 만든 그것 | ✓ 8 tests |
오라클 goal 프레임 선택(tracked_obj_pixels 기반) | ✓ 6 tests + 실데이터 검증 |
정책 클라이언트 set_goal_image (uint8 검증 포함) | ✓ 20 tests |
| orchestrator 훅 — place 서브골에만 goal, 미도달 시 assert | ✓ 79 + 199 tests |
| MolmoBot goal 정책 websocket 서빙 분기 | ✓ hydra dry-run (실기동 미검증) |
프로브 러너 — VLM 미호출, 조건 간 qvel 영점화, --query-ids | ✓ 실기동 확인 |
사전 등록 판정(probe_verdict) | ✓ 7 tests |
전체 유닛 스위트 980 통과. 리뷰가 잡은 결함 6건은 전부 “크래시 없이 틀린 수치를 만드는” 부류였다
(조건 간 속도 이월, goal_image_used 거짓 기록, n=1에서 wrong 자기짝, dtype 미검증, resume 키 누락, 판정 테스트의 탈락 사유 미구별).
8 남은 선택지
| 방향 | 답하는 질문 | 비용 |
|---|---|---|
정책 카메라로 goal 렌더 — 물체를 원위치에 놓고 randomized_zed2_analogue_1로 찍음 |
“메커니즘이 우리 씬에서 작동하긴 하는가” (기억이 아니므로 진단용) | GPU만 |
| pick을 오라클로 — 물체를 그리퍼에 쥐여주고 place만 측정 | pick 실패를 분모에서 제거. hand-off와 같은 조건 | 구현 + GPU |
| 데이터셋에 고정 카메라 추가 | 근본 해결. 기억에 goal 품질 프레임이 생김 | 데이터 재생성 |
| 여기서 종결 | “현 데이터셋으로는 측정 불가”를 결론으로 | 0 |