goal image Phase 0 스모크
2026-09-17 · job 131979 · API $0
기억에서 꺼낸 사진을 VLA의 goal로 — 배선은 됐고, 측정은 안 된다
TL;DR — goal 이미지가 정책까지 도달하는 배선은 전부 작동했다(
goal_image_used=True).
그런데 세 조건의 결과가 같다. 원인은 모델도 도메인 갭도 아니다 —
놓을 좌표를 하네스가 이미 정한다(choose_place_xy, 로봇 위치를 표면 영역에 클램프).
팔이 그 지점 위 15cm로 옮겨진 뒤 VLA는 내려놓기만 한다. goal 이미지가 결과에 닿을 인과 경로가 없다.
0.61~0.76 m
세 조건 d_xy
0.15 m
데이터셋 r_place
True
goal 도달 확인
$0
API 비용
1 세팅 — 무엇을 어떻게 돌렸나
restore 질의 restore:train_2853__2:q03 — “soap bottle을 원래 있던 자리에 되돌려 놔”.
한 칸을 세 조건으로 반복한다. 조건 간 다른 것은 goal 이미지 내용 하나뿐이다.
# 제출 (sbm 래퍼, #SBATCH 헤더 없음)
POLICY_TAG=pi05_goal_v2 POLICY_SERVER_PORT=8796 N_CELLS=2 \
sbm "bash scripts/run_goal_probe_worker.sh" -J goalsmoke2_pi05 \
--gres=gpu:1 -c 8 --mem 200GB --time 3:00:00 --qos=own \
--container=docker.io/library/python:3.11
# 정책서버 (워커 안에서 기동)
MODEL_DIR=~/ckpts/molmobot_pi05_runs/pi05_mlspaces_finetune/pi05_mlspaces_place_oc_goal_v2
CKPT_STEP=10000 CAMERAS=sim_exo_random # = randomized_zed2_analogue_1 + wrist_camera_zed_mini
# (= train_config.data.goal_camera, goal 학습 카메라와 동일)
# 서브골 대본 (VLM 미호출 — ScriptedPlanner + done_mode="oracle" 이라 API $0)
navigate(soap bottle) → pick(soap bottle) → navigate(sofa) → pick_and_place(soap bottle, sofa) → done
place_mode="vla" prompt_profile="molmobot" subgoal_horizon=300
VLA가 실제로 하는 일은 pick과 place 둘뿐이다. navigate는 텔레포트(nav0.teleport_to)라 정책을 안 거친다.
프롬프트 검증 통과 — 정책이 받은 문장은
"Place the soap bottle on the sofa."
학습 형식(place_held = "Place the {} on the {}.")과 일치하고, 받침면 명사 “sofa”는
hand-off 벤치의 SUPPORT_VOCAB에 있는 낱말이다. 우려했던 "diningtable"류 붙임 표기가 아니다.
2 세 조건에 먹인 goal 이미지
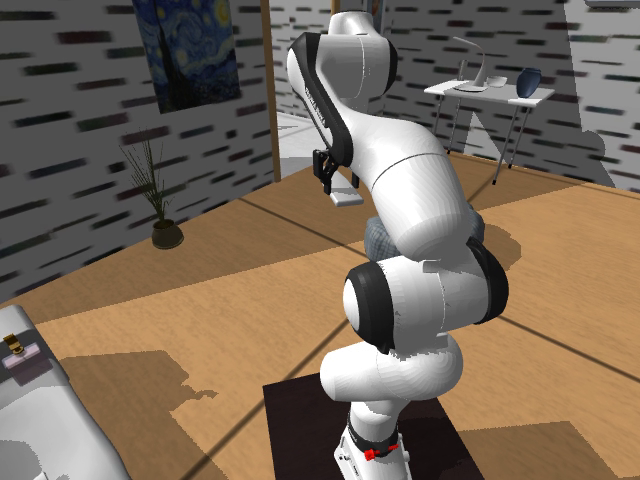
oracle — 물체가 원위치에 있던 프레임. 같은 편 exo_camera_1 frame 704, 물체 픽셀 1,507
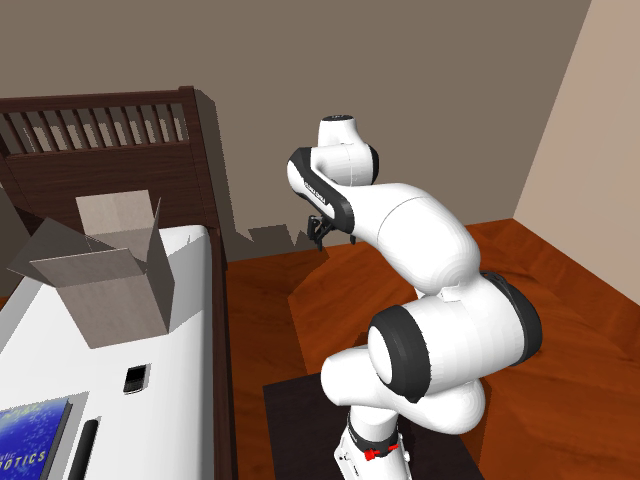
wrong — 다른 편(train_7385__0) frame 244. hand-off에서 이 조건은 goal-off보다 나빴다(43.2 vs 25.6 cm)
off 조건은 goal 키를 아예 싣지 않는다(goal_image_used=False).
3 동작 — 영상
각 조건의 preplace 접근(하네스가 팔을 옮기는 구간)과 VLA place(정책이 제어하는 구간)를 나눠 싣는다.
oracle (goal = 원위치 사진)
하네스가 팔을 preplace 자세로 — 목표 xy (11.614, 10.635), 표면 위 15cm
VLA place — 12스텝. 그리퍼를 열고 끝난다
off (goal 없음)
preplace 목표 xy (11.614, 10.561) — oracle과 7cm 차이
VLA place — 11스텝
wrong (goal = 다른 편 사진)
preplace 목표 xy (11.614, 10.659)
VLA place — 300스텝(전체 horizon). 오래 돌아도 결과는 같다
참고 — pick 구간 (정책이 실제로 잘 하는 부분)
pick 71스텝, 성공. VLA pick 자체는 문제없다
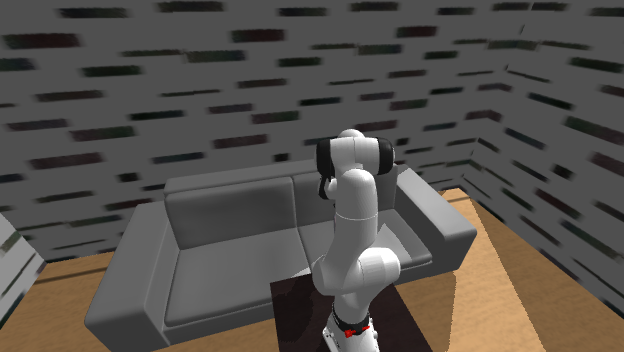
navigate(sofa) 직후 — 물체를 든 채 소파 옆에 섬
4 결과
| 조건 | goal 도달 | place 스텝 | d_xy | dz | 표면 판정 | replace@15cm |
|---|---|---|---|---|---|---|
| oracle | True | 12 | 0.679 m | −0.010 | ✓ | ✗ |
| off | False | 11 | 0.614 m | −0.012 | ✓ | ✗ |
| wrong | True | 300 | 0.759 m | — | — | ✗ |
goal 효과 0. oracle이 off보다 오히려 6.5cm 멀다. hand-off 벤치에서 같은 정책 계열이 낸
goal-on 15.1cm vs goal-off 44.2cm 같은 분리가 전혀 없다.
5 왜 — 배치 좌표를 하네스가 정한다
결정적인 숫자 하나로 설명된다.
원위치 (to.xyz) = (11.680, 9.945)
하네스가 고른 preplace = (11.614, 10.635) ← oracle
차이 = 0.693 m
실측 d_xy = 0.679 m ← 거의 일치
물체는 하네스가 정한 자리에 정확히 놓였다. 그 자리는 이렇게 정해진다:
src/sbench_online/place.py:160 (preplace_pose)
x, y = choose_place_xy(reg["xy_min"], reg["xy_max"], robot_xy)
# 로봇 위치를 표면 AABB 안으로 클램프 — 기억과 무관
조기 종료는 병목이 아니다. 처음엔 place 서브골이 표면 접촉 즉시 끝나는 것
(
subgoal_stop → is_placed_on)이 원인이라고 봤다. 그런데 wrong 조건은
300스텝 전체 horizon을 다 쓰고도 0.759m다. 오래 돌려도 정책은 팔이 놓인 자리 근처에 놓을 뿐,
goal 위치로 횡이동하지 않는다. 두 결함이 겹쳐 있지만 구속하는 쪽은 좌표 선택이다.
hand-off와 무엇이 다른가. MolmoBot의 place 평가에서는 scripted expert가
놓을 지점을 정해 그 위로 팔을 가져간 뒤 정책에 넘긴다 — 거기서 goal 이미지는 그 지점 주변의 정밀 조정을
안내한다. 우리 하네스도 preplace까지는 똑같이 하는데, 지점을 고르는 주체가 기억이 아니라 기하 휴리스틱이다.
즉 우리는 goal 이미지에게 “어디에 놓을지”를 물은 적이 없다.
6 부수적으로 확인된 것
- 배선은 전부 작동한다 —
goal_image_used가 oracle/wrong에서 True, off에서 False. 서버까지 키가 전달되고 학습과 같은 꼬리 블록으로 실린다. - VLA pick은 문제없다 — 71스텝에 성공,
held_at_place=True. - preplace 접근도 작동한다 — IK 성공,
final_l2 0.027, 물체를 떨어뜨리지 않는다. 이건 다른 세션이 오늘 넣은 미커밋 코드(preplace_approach, "260917 B안, 사용자 결정")다. - 데이터셋 채점 규격은 r_place = 0.15 m — 세 조건 전부 그 4~5배 밖이다.