human demo는 무엇을 고치는가 — 같은 장면 짝 비교 + 실패 원인 분류
TL;DR
- 같은 장면끼리 짝지으면 demo 효과가 더 선명하다: pooled +6.1pp, p=0.002이고, cup·stamp·microwave는 태스크별로도 유의하다.
- 뒤바뀜은 노이즈가 아니다: 같은 조건을 재실행하면 7%만 바뀌지만, lang과 ICL 사이에서는 37%가 바뀐다.
- demo 순이득의 88%는 잡기·놓기 개선이고, 대상 선택 개선은 10%다. held-out 장면에는 고를 대상이 사실상 하나뿐이다.
- demo는 성공을 더하지 않고 재배치한다: 순이득은 40개지만 결과가 뒤바뀐 에피소드는 162개(25%)다.
1 배경 / 목적
지금까지 demo 효과(32K: lang 20.67 → ICL 27.00)는 태스크 평균의 차이로만 쟀다. 이 분석은 같은 장면에서 demo가 결과를 얼마나 바꾸는지, 그리고 바뀐 에피소드에서 고치는 실패가 무엇을 할지(대상 선택)인지 어떻게 할지(잡기·놓기)인지를 본다.
2 방법
- 평가 로그에서 에피소드별 (seed, 성공, 지시문, 롤아웃 영상)을 복원했다. 31개 조합 모두
res.json집계와 정확히 일치한다. - 장면 동일성: 첫 프레임 MAE가 같은 seed에서 최대 0.30, 다른 seed에서 최소 0.90이라 명확히 갈린다. 즉 같은 seed는 같은 장면이다.
- 공유 seed로 2×2 표를 만들고 exact McNemar를 적용했다. 재실행 노이즈는 n=10 파일럿(같은 조건 재실행)으로 쟀다.
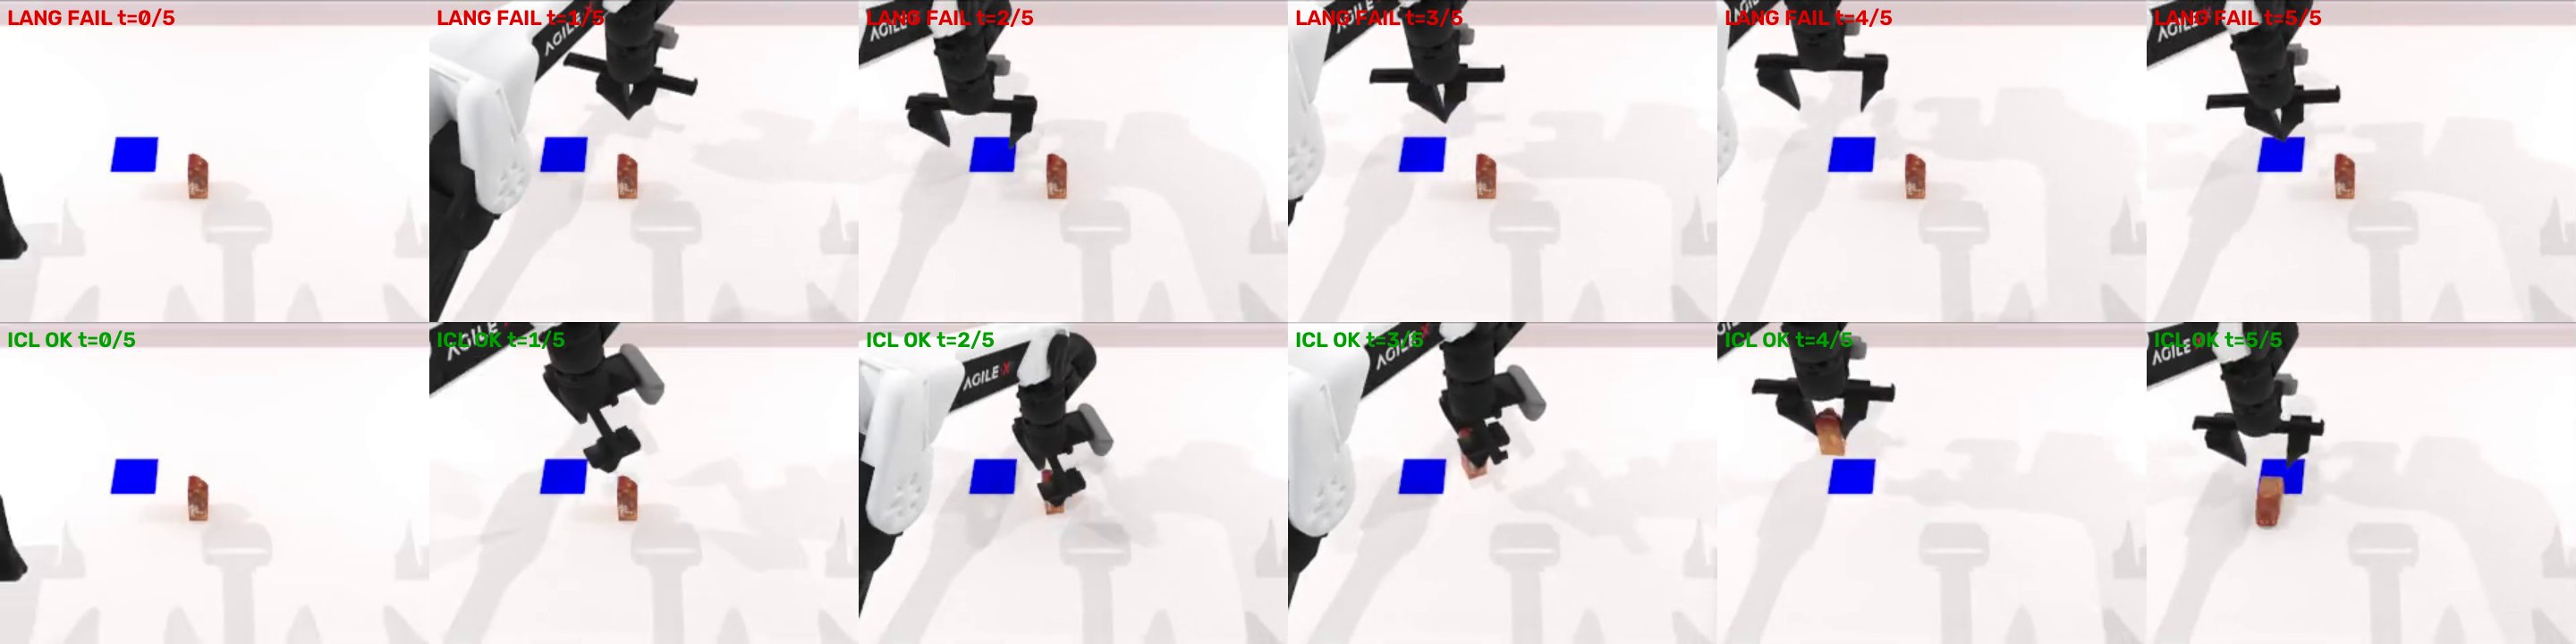
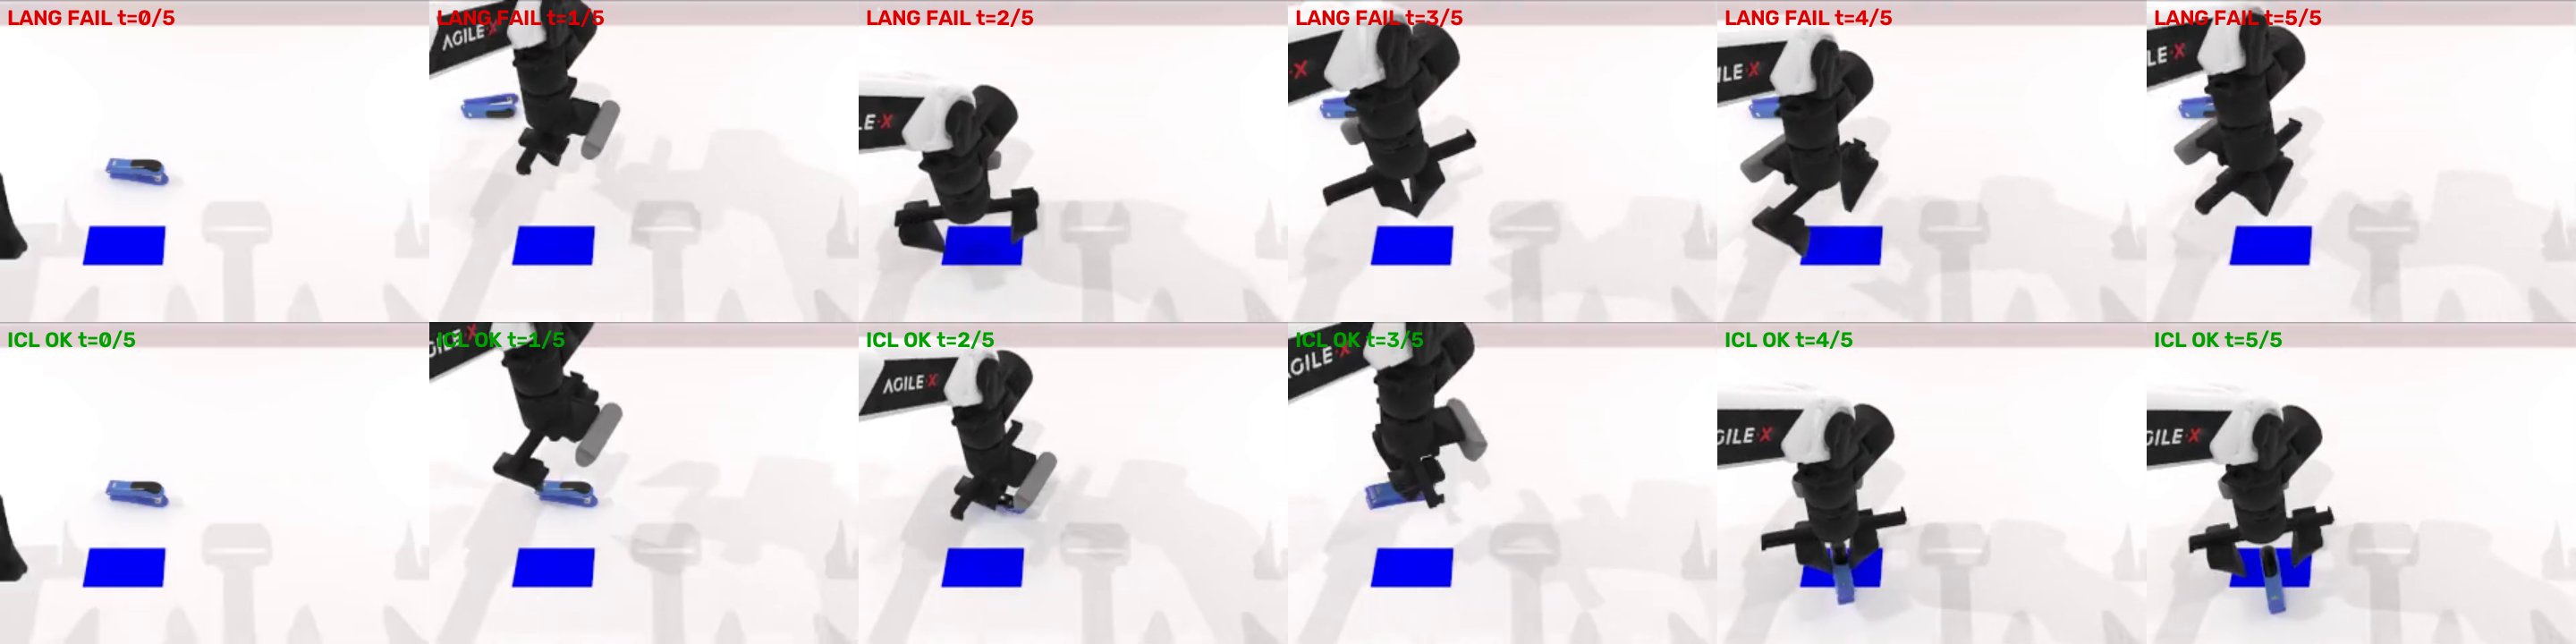
- 결과가 뒤바뀐 162개 에피소드마다 head cam 6프레임 시트를 만들고, 태스크별 에이전트 4개가 실패한 쪽의 원인을 라벨링했다. 무작위 3건은 직접 재확인해 3/3 일치했다.
3 결과 — 같은 장면 짝 비교
| task | n | lang만 성공 | ICL만 성공 | Δ | p |
|---|---|---|---|---|---|
| place_empty_cup | 100 | 4 | 22 | +18.0 | 0.0005 |
| stamp_seal | 97 | 13 | 29 | +16.5 | 0.020 |
| open_microwave | 75 | 5 | 16 | +14.7 | 0.027 |
| place_bread_basket | 95 | 6 | 11 | +5.3 | 0.33 |
| place_object_scale | 95 | 6 | 8 | +2.1 | 0.79 |
| move_stapler_pad | 98 | 27 | 15 | −12.2 | 0.088 |
| pooled | 660 | 61 | 101 | +6.1 | 0.0021 |
영상 교체 vs matched(3태스크): +13.3pp, p=0.0001. 32K vs 50K ICL: −4.1pp, p=0.034. stack_blocks_three는 양쪽 모두 0이라 표에서 뺐다.
4 결과 — 실패 원인 (뒤바뀐 162개)
| 실패 원인 | ICL이 실패 (61) | LANG이 실패 (101) | demo가 줄인 수 |
|---|---|---|---|
| 잡기 실패 (grasp_fail) | 35 | 51 | 16 |
| 놓기 위치 오차 (place_off) | 12 | 31 | 19 |
| 엉뚱한 대상 (wrong_target) | 7 | 11 | 4 |
| 시간 내 미완료 | 6 | 6 | 0 |
| 판단 불가 | 1 | 2 | 1 |
5 Takeaway
해석
RoboTwin에서 human demo는 무엇을 할지가 아니라 어떻게 할지를 바꾼다. 순이득 40개 중 35개가 잡기·놓기 개선이다. 대상 선택의 여지가 구조적으로 없는 장면들이라 명세 정보가 개입할 수 없다. 틀린 demo로도 25%가 나왔던 기존 결과와 같은 그림이다.
정책은 장면이 같으면 거의 같은 행동을 한다(재실행 시 7%만 바뀜). 그런데 demo를 넣으면 25%가 뒤바뀐다. demo는 궤적을 크게 흔들지만, 그 방향이 태스크마다 다르다. cup에서는 "물체를 확보하지 않고 목표로 가기"를 고치고, stapler에서는 오히려 그 실패를 만든다.
6 한계 / Next
- 라벨은 head cam 6프레임을 보고 에이전트가 1회 판정한 것이다. 사람 검증은 5건뿐이고 low confidence가 7건이다. "빈손으로 목표 이동"은 노트 키워드로 센 대략치다.
- 재실행 노이즈 추정은 n=29라 작다.
- P1 우선순위 갱신: 실행 개선이 어디서 오는지 가르는 조건을 먼저 돌린다. ① demo 없음 ③ 영상만 ⑥ 프레임 섞기 ⑤ 마지막 프레임. 명세 검증은 선택지가 있는 장면(P3)에서만 가능하다.
7 업데이트 — 학습 비중 교란 점검
language-only 모드는 학습 조건 분포의 6%뿐이고 ICL 모드는 36%다(drop_icl=0.1과 droptext_target=0.4가 독립). 그래서 같은 ICL 모드 안에서 영상 내용만 다른 맞는 demo vs 엉뚱한 demo로 같은 분석을 반복했다(뒤바뀐 97개 에피소드).
| 실패 원인 | 맞는 demo가 실패 (29) | 엉뚱한 demo가 실패 (68) | 맞는 demo가 줄인 수 |
|---|---|---|---|
| 잡기 실패 | 17 | 42 | 25 |
| 놓기 위치 오차 | 10 | 16 | 6 |
| 시간 내 미완료 | 2 | 6 | 4 |
| 엉뚱한 대상 | 0 | 4 | 4 |
해석
엉뚱한 demo를 주면 늘어나는 실패는 주로 "물체를 확보하지 않고 빈손으로 목표에 가기"다. 맞는 demo는 사람 손이 바로 그 물체를 잡는 장면을 보여준다. 그래서 demo는 태스크 정체성이 아니라 물체 grounding/affordance(무엇을 어디서 잡을지)를 제공한다는 해석과 맞는다.
language-only vs ICL의 효과 크기(+6pp) 자체는 덜 학습된 모드와의 비교라는 한계가 남는다. 공정한 인터페이스 비교는 텍스트 전용 쌍둥이 모델(job 169687)로 따로 한다.
8 영상 — 결과가 뒤바뀐 대표 에피소드
각 카드는 같은 seed(같은 장면)에서 조건만 다른 두 롤아웃이다. 왼쪽 위 패널이 head 카메라다. 라벨 파일에서 "빈손으로 목표 이동" 노트가 붙은 신뢰도 high 사례를 순서대로 골랐다. cup은 high 사례가 없어 medium을 썼다.