goal 없이 학습한 place+open/close 기준선: goal 모델의 "goal off"는 순수 언어 기준선이 맞다 — goal 이득 pi0.5 @10cm 6.8→27.4%, MolmoBot 17.7→63.8% 확정 · open은 백본 문제
TL;DR
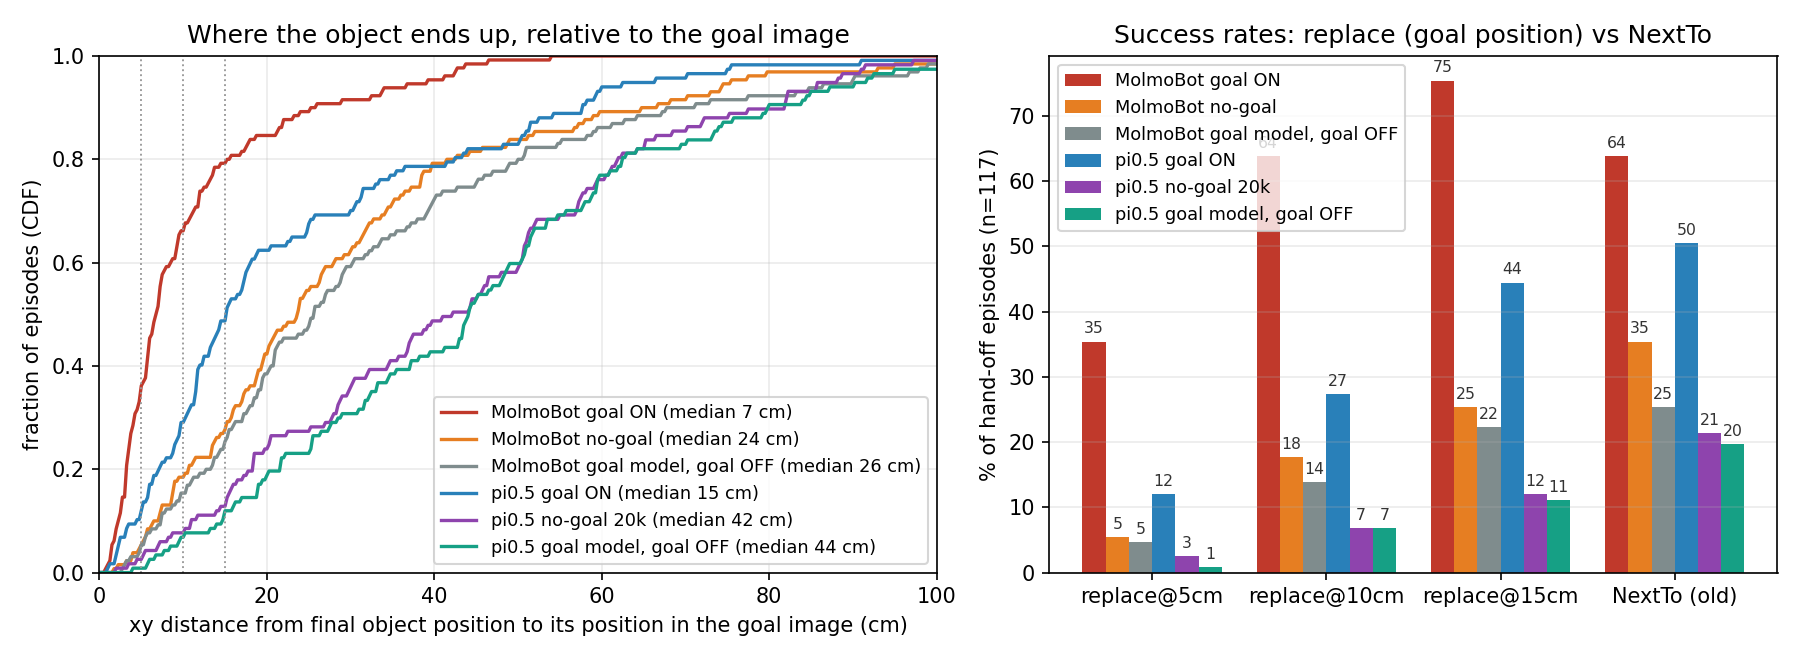
- 질문 "goal 안 주고 학습한 모델도 있나?" → 없어서 둘 다 학습(사용자 결정, own, pi0.5 먼저). 결과: 두 백본 모두 전용 no-goal 모델의 replace 정밀도·거리가 goal 모델 goal-off와 같다(pi0.5 42.0 vs 44.2 cm, MolmoBot 23.6 vs 25.6 cm, 전부 p≥0.36). 기존 goal-off 수치는 순수 언어 기준선으로 유효.
- goal-on 이득은 전용 기준선 대비로도 그대로. pi0.5 replace@10cm 6.8 → 27.4% (28:4, p=2e-5), 거리 42 → 15 cm; MolmoBot 17.7 → 63.8% (63:3, p=1e-15), 24 → 6.7 cm. 언어만으로는 20k step(pi0.5)이든 더 강한 백본(MolmoBot 18–24 cm)이든 5 cm 복원에 못 간다.
- open은 goal과 무관. pi0.5 no-goal 11.1%(서랍장 20.5%) = goal 모델(11.1% / 25.0%), MolmoBot no-goal 8.1%(9.1%) = goal 모델(5.6% / 9.1%). MolmoBot의 open 미습득은 백본/학습량 문제로 확정.
- Close: MolmoBot 42.0% 동일(19:19). pi0.5 no-goal 56.5% > goal 모델 45.5% (p=0.021) — 단 goal 모델은 open/close를 마지막 10k만 봐서 노출량 교란.
- 부수 발견: goal 없는 MolmoBot은 "next to Y" 프롬프트가 "on the {받침면}"보다 가깝고(18.1 vs 23.6 cm), goal-on 모델은 반대(11.4 vs 6.7 cm) — goal이 없으면 언어가 위치를 주고, 있으면 학습 형식 일치가 우선.
1 설정
2 hand-off "Place the X on the {받침면}." — replace 기준
pi0.5 (공통 117편)
| 모델 | replace@5cm | @10cm | @15cm | 거리 중앙값 | NextTo | off-surface |
|---|---|---|---|---|---|---|
| no-goal 20k | 2.6% (3) | 6.8% (8) | 12.0% (14) | 42.0 cm | 21.4% | 20 |
| no-goal 10k | 0.9% (1) | 4.3% (5) | 7.7% (9) | 44.5 cm | 11.1% | 19 |
| goal 모델, goal off | 0.9% (1) | 6.8% (8) | 11.1% (13) | 44.2 cm | 19.7% | 16 |
| goal 모델, goal on | 12.0% (14) | 27.4% (32) | 44.4% (52) | 15.1 cm | 50.4% | 20 |
no-goal 20k vs goal off: @5 1:3 (p=0.63), @10 5:5 (p=1), NextTo 12:14 (p=0.85), 거리 +0.7 cm (p=0.42). no-goal 20k vs goal on: @5 13:2 (p=0.0074), @10 28:4 (p=2e-5), 거리 −14.3 cm (p=8e-12). open-loop val: no-goal 20k 0.0895 / 10k 0.0989 vs goal on 0.0573 / off 0.0958 / wrong 0.1525.
MolmoBot (공통 130편)
| 모델 | replace@5cm | @10cm | @15cm | 거리 중앙값 | NextTo | off-surface |
|---|---|---|---|---|---|---|
| no-goal 10k | 5.4% (7) | 17.7% (23) | 25.4% (33) | 23.6 cm | 35.4% | 20 |
| goal 모델, goal off | 4.6% (6) | 13.8% (18) | 22.3% (29) | 25.6 cm | 25.4% | 24 |
| goal 모델, goal on | 35.4% (46) | 63.8% (83) | 75.4% (98) | 6.7 cm | 63.8% | 17 |
| 공식 MolmoBot zero-shot | 3.1% | 11.5% | — | 43.1 cm | 18.5% | — |
no-goal vs goal off: @5 3:4 (p=1), @10 7:12 (p=0.36), 거리 +0.8 cm (p=0.07); NextTo만 35 vs 25% (4:17, p=0.007). no-goal vs goal on: @5 42:3 (p=9e-10), @10 63:3 (p=1e-15), 거리 −13.6 cm (p=6e-18). no-goal vs zero-shot: 거리 43 → 24 cm (p=9e-9), replace@10 19:11 (p=0.2).
MolmoBot, "next to Y" 프롬프트 (공통 130편)
| 모델 | replace@5cm | @10cm | @15cm | 거리 중앙값 | NextTo |
|---|---|---|---|---|---|
| no-goal 10k | 8.5% (11) | 20.0% (26) | 36.2% (47) | 18.1 cm | 45.4% |
| goal 모델, goal on | 16.9% (22) | 42.3% (55) | 56.2% (73) | 11.4 cm | 59.2% |
| 공식 MolmoBot zero-shot | 5.1% | 19.0% | — | 18.5 cm | 41.6% |
| pi0.5 v2 goal off (참고) | 1.9% | 7.8% | 27.2% | 27.7 cm | 26.5% |
3 Open / Close HardBench (언어만)
| 모델 | Open 전체 | Open chestofdrawers | Close 전체 | Close chest / desk / fridge / stand / micro |
|---|---|---|---|---|
| pi0.5 no-goal 20k | 22/198 = 11.1% | 9/44 = 20.5% | 113/200 = 56.5% | 21/48 · 23/48 · 36/48 · 29/49 · 4/7 |
| pi0.5 no-goal 10k | 22/198 = 11.1% | 8/44 = 18.2% | — | — |
| pi0.5 goal 모델 | 22/198 = 11.1% | 11/44 = 25.0% | 91/200 = 45.5% | 18 · 17 · 32 · 23 · 1 |
| pi0.5 zero-shot (part1@15k) | 13/198 = 6.6% | 3/44 = 6.8% | 45–58% | — |
| MolmoBot no-goal 10k | 16/198 = 8.1% | 4/44 = 9.1% | 84/200 = 42.0% | 17 · 13 · 34 · 16 · 4 |
| MolmoBot goal 모델 | 11/198 = 5.6% | 4/44 = 9.1% | 84/200 = 42.0% | 18 · 13 · 31 · 18 · 4 |
4 Takeaway / Next
의미
세 질문 모두 "예". 기존 goal-off 수치는 순수 언어 기준선으로 써도 되고, goal 이미지의 이득(pi0.5 거리 42→15 cm, MolmoBot 24→7 cm)은 전용 기준선 대비로 확정됐다. 언어 배치 능력은 MolmoBot이 pi0.5보다 낫지만(24 vs 42 cm) goal 효과가 그 차이보다 훨씬 크다. open/close는 goal 학습과 무관하므로 2-stage 라우팅 결론(place = MolmoBot goal 모델, open = pi0.5)은 그대로.
다음
(1) pi0.5 Close 56.5 vs 45.5%의 노출량 교란 → no-goal 10k ckpt Close 1잡(≈4 h). (2) MolmoBot open: 비율 0.10→0.2 또는 20k step, 아니면 open만 pi0.5 라우팅. (3) MolmoBot goal 모델의 5–10 cm 구간(28%)·off-surface 17편·배포 교란 강건성. (4) sharded 원본 `molmobot_place_oc/step10000` 삭제는 사용자 확인 후.