Hand-off Place 실험 기록
2-stage(pick → navigation → place) 파이프라인의 low-level VLA가 물체를 든 채 넘겨받아 "Place the X next to the Y"만 듣고 잘 놓는가를 재기 위해 무엇을 넣었고, 어떤 이미지가 들어갔고, sim rollout이 어떻게 돌아가고, 무엇이 실패하고 무엇이 됐는지의 전체 기록.
open-loop에서는 goal이 크게 작용했지만, closed-loop hand-off 성공률은 어떤 조건에서도 움직이지 않았다
| 조건 (공통 117편) | 무엇이 다른가 | 성공률 | val L1 all | 판정 |
|---|---|---|---|---|
| mix20k | place 데이터 없음 (기존 5종 혼합, 20k step) | 23.1% | 0.1116 | 기준선 |
| place10k | + place 클립 (가중치 0.20), goal 없음 | 22.2% | 0.0870 | 무변화 |
| place_goal10k · goal off | goal로 학습(dropout 0.5), 평가 때 goal 안 줌 | 22.2% | 0.0898 | 무변화 |
| place_goal10k · goal on | expert가 놓은 장면(관측 카메라)을 goal로 | 23.9% | 0.0720 | p=0.86 |
| place_goal10k · goal on, 늦은 프레임 | 팔이 물체에서 떨어진 뒤(go_home +30 step)의 장면 | 23.9% | — | on과 12:12 |
| place_goal10k · 틀린 goal | 다른 에피소드의 goal 이미지 | 19.7% | 0.1285 | p=0.41 |
| scripted expert | 데이터 생성기가 직접 끝까지 수행 (pass 1) | 71.8% | — | 상한 |
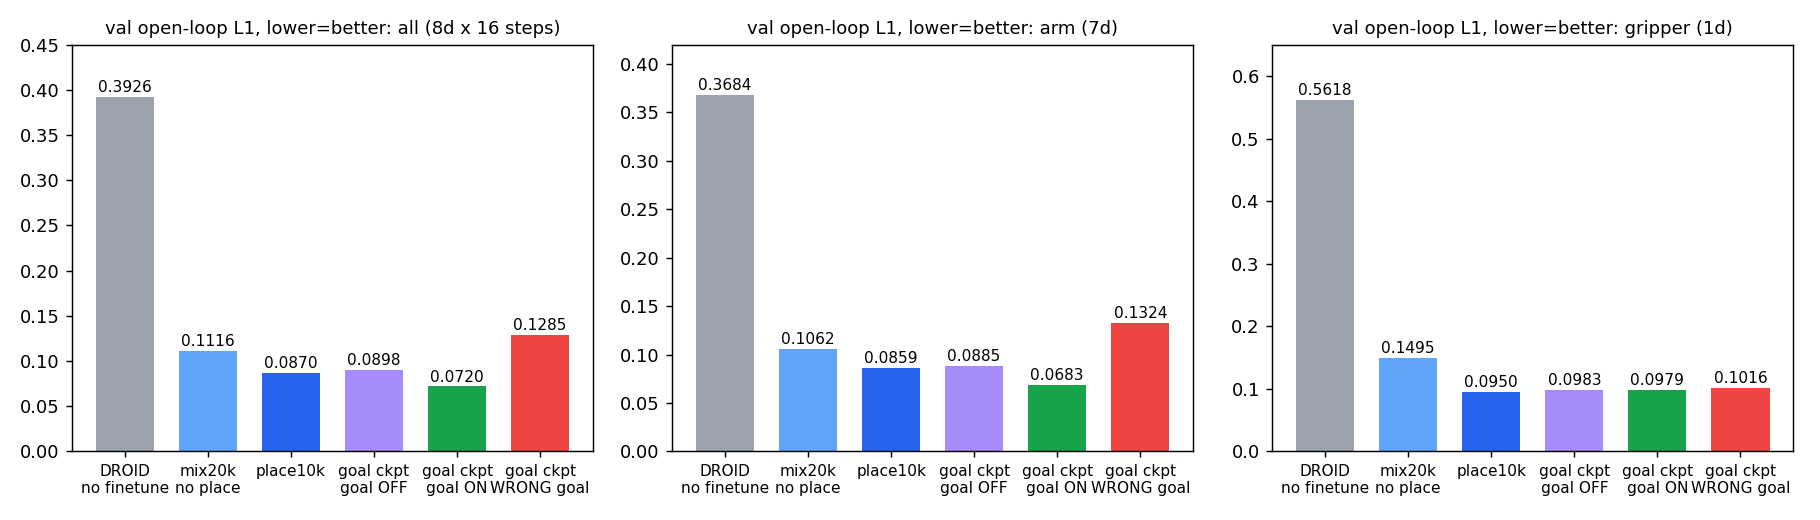
학습 분포(val)에서는 goal 이미지가 팔 궤적 오차를 23% 줄이고, 틀린 goal은 50% 늘린다 — 모델은 3번째 이미지 슬롯의 내용을 읽는다. 그런데 sim에서 물체를 든 채 넘겨받아 실제로 놓게 하면 place 데이터도, goal도, goal의 시점·프레임을 바꿔도 성공률은 21–24%에서 움직이지 않는다.
실패는 "놓지 못해서"가 아니다(97–100% 놓음). 참조 물체까지 마지막 15–40 cm를 못 맞춘다: 최종 표면거리 중앙값 0.17–0.24 m, 10 cm 이내는 25–32%뿐이다.
질문과 측정 정의
사용자의 2-stage 제어에서 pick과 navigation은 다른 모듈이 하고, pi0.5는 이미 물체를 든 상태에서 제어권을 받아 내려놓기만 한다. 그 hand-off 이후가 잘 안 된다. 두 질문:
- Q1 — place 구간만 잘라 만든 데이터(
Keh0t0/molmo-augment)로 추가 학습하면 잘 놓는가? - Q2 — 사전에 저장해 둔 "물체가 놓여 있던 장면" 이미지를 goal로 넣어 주면 큰 의미가 있는가?
처음에는 이를 val open-loop 오차와 기존 HardBench(Pick / PnP / NextTo, 깨끗한 초기 상태에서 pick부터)로 답했다. 사용자가 정정했다: 원하는 것은 "물체를 든 채 시작하고 Place 명령만 줬을 때"의 성공률이다. 기존 벤치는 pick부터 하고, val L1은 action 예측 오차일 뿐이다. 그래서 그 상황을 그대로 재현하는 closed-loop 벤치를 만들었다(§6).
데이터: molmo-augment place 트랙
goal_im/<ep>/{exo_camera_1, exo_camera_2, wrist_camera}.png, 480×640 — 클립 이후 구간(goal window: retreat~go_home, 약 5.5 s)의 완료 장면학습 goal 카메라로 exo_camera_2를 썼다. 이 카메라가 정확히 무엇인지는 이번 기록을 쓰면서 다시 확인했다: h5에 저장된 관측 센서 4종(randomized_zed2_analogue_1/2, randomized_gopro_analogue_1, droid_shoulder_light_randomization) 중 어느 것과도 일치하지 않는 별도 카메라이고, 에피소드마다 위치가 달라 관측 exo 시점과도 다르다.
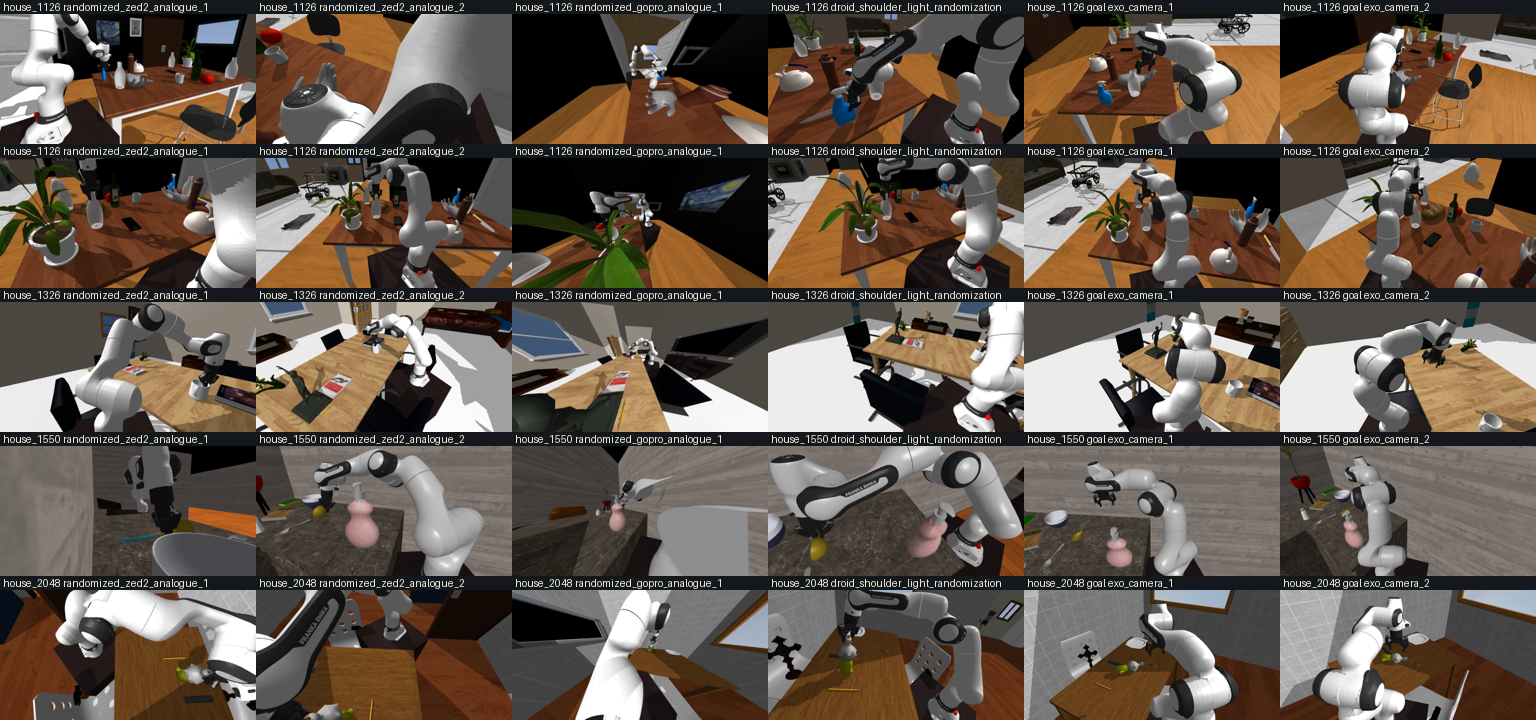
이 사실은 sim closed-loop 결과 해석에 영향을 준다. sim에서는 관측 카메라와 같은 카메라로 goal을 만들었다(§6). 학습 goal 분포(다른 시점)와 다른 시점 도메인이며, 이를 가르는 진단(goal 카메라 = randomized_zed2_analogue_2, job 107886)이 진행 중이다.
모델 입력과 goal 주입 방식
pi0.5(openpi PyTorch)의 입력은 이미지 슬롯 3개, 관절 상태, 언어 프롬프트다. 출력은 16 step × 32차원 action chunk이며 실제 의미 있는 차원은 8개(팔 관절 상대 위치 7 + 그리퍼 1). 평가에서는 이를 관절 속도 명령으로 실행한다.
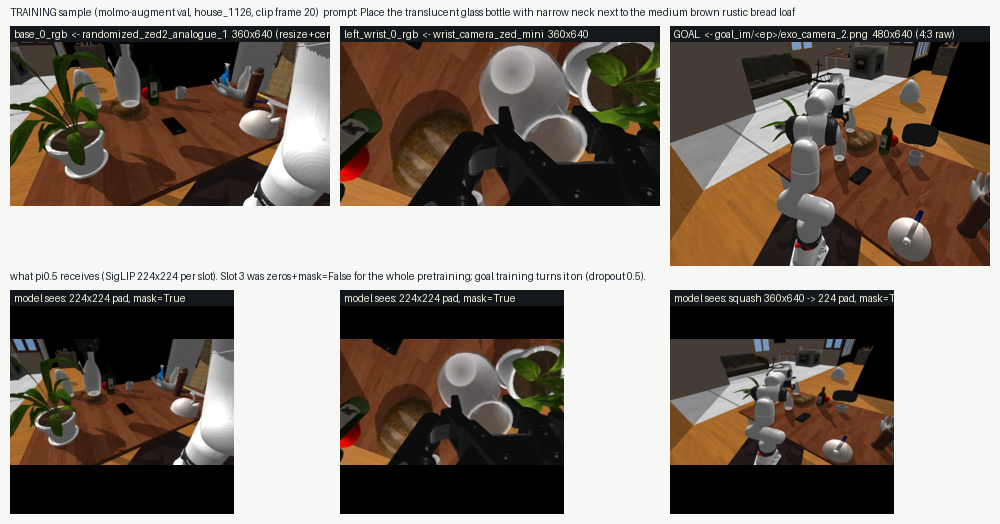
randomized_zed2_analogue_1 480×640 → resize + center-crop 360×640 → 224×224 pad. mask = Truewrist_camera_zed_mini, 같은 전처리. mask = Truegoal이 들어가는 경로 (molmobot_pi0/goal_image.py)
goal_im/<ep>/exo_camera_2.png 480×640을 PIL로 읽어(cv2.imread는 비디오 디코드 직후 libpng 오류) 샘플에 observation.goal_image(1,H,W,3) + observation.goal_valid(1,) 부착. goal이 없는 데이터셋 샘플에는 placeholder + valid=Falseright_wrist_0_rgb에 넣고 mask=True. dropout 0.5: 샘플의 state 합을 해시한 결정적 난수로 절반은 다시 zeros+mask=Falseresize_with_pad 224×224 → SigLIP. 정규화·토큰화는 기존과 동일dropout을 둔 이유는 두 가지다. 배포에서 goal을 못 만드는 상황에도 동작해야 하고, 한 번도 안 쓰던 슬롯을 켜면 attention 패턴이 바뀌어 기존 능력이 깎일 수 있어서다. 실제로 goal off 성능은 place10k와 3% 차이(0.0898 vs 0.0870)로 유지됐다.
배포 경로(pi.py)에서는 base가 이미 224×224로 들어오므로 goal에 같은 순서(squash → pad)를 재현하도록 obs_hw를 두었고, obs["goal_image"]를 넣으면 슬롯으로 가는 passthrough를 붙였다. 아래가 실제 학습 샘플 하나에서 모델이 받는 세 장이다.
학습
| run | init | 혼합 (샘플링 확률) | goal | step / batch | 시간 | 최종 loss | job |
|---|---|---|---|---|---|---|---|
| mix (v2) | pi05_droid | main 0.35 / Pick 0.20 / PnP-p0 0.10 / NextTo 0.20 / Color 0.15 | — | 20k / 256 | 11h35m | 0.0038 | 84260 |
| place | pi05_droid | main 0.30 / Pick 0.15 / PnP-p0 0.10 / NextTo 0.15 / Color 0.10 / place 0.20 | — | 10k / 256 | 7h13m | 0.0050 | 105831 |
| place_goal | pi05_droid | place와 동일 | exo_camera_2, dropout 0.5 | 10k / 256 | 7h19m | 0.0050 | 107382 |
place와 place_goal은 init·step·혼합비·지시문이 같고 goal 유무만 다르다(통제 A/B). place 클립은 전체 프레임의 0.7%지만 0.20 가중치로 약 28배 오버샘플링된다. 8×B200, 로그인 노드가 아닌 sbatch(own QOS). goal 학습은 세 번 죽고 네 번째에 돌았다(§8).
평가 ①: val open-loop L1
val 460궤적의 모든 프레임(39,040)에서 정규화 공간의 예측 chunk(16×8)와 GT의 L1. 모든 프레임이 "든 채 시작"한 분포이므로 hand-off 능력의 대리 지표로 썼다 — 나중에 이 가정이 틀렸음이 드러난다(§9). 네 가지 뷰: all, arm(7), gripper(1, 릴리즈 타이밍), step0(즉시 실행되는 첫 step). 조건은 --goal-camera(on), 없음(off), --goal-shuffle(다른 궤적의 goal, 460궤적 derangement), --goal-preproc crop(관측처럼 center-crop한 goal).
| 모델 · goal 조건 | all | arm | gripper | step0 | 읽기 |
|---|---|---|---|---|---|
| DROID (MolmoSpaces 학습 전) | 0.3926 | 0.3684 | 0.5618 | 0.4249 | zero 예측(0.2362)보다 나쁨 |
| mix20k | 0.1116 | 0.1062 | 0.1495 | 0.1097 | place 데이터 없는 기준선 |
| place10k | 0.0870 | 0.0859 | 0.0950 | 0.0856 | all −22%, gripper −36% vs mix20k |
| place_goal10k · off | 0.0898 | 0.0885 | 0.0983 | 0.0881 | goal 없어도 place10k 수준 유지 |
| place_goal10k · on | 0.0720 | 0.0683 | 0.0979 | 0.0732 | arm −22.8% vs off, gripper 불변 |
| place_goal10k · on, crop | 0.0768 | 0.0739 | 0.0978 | 0.0770 | 기하를 바꿔도 이득의 73% 유지 |
| place_goal10k · 틀린 goal | 0.1285 | 0.1324 | 0.1016 | 0.1263 | arm +50% vs off — 내용을 읽고, 틀리면 오도됨 |
평가 ②: closed-loop hand-off 벤치
사용자 정의 측정을 그대로 재현한다. 물체를 "든 채 시작"하는 상태를 만들려면 누군가 집어야 한다. h5에는 물체 포즈가 저장돼 있지 않아 저장 상태 복원은 불가능했고(EnvStateSensor가 비어 있음), 물체를 그리퍼에 용접하는 코드도 없다. 대신 molmo_spaces에 들어 있는 데이터 생성용 scripted expert(PickAndPlaceNextToPlannerPolicy)를 그대로 써서 집게 하고, 학습 클립이 잘린 바로 그 지점에서 정책에 넘긴다.
task.get_task_description을 덮어씀released_at_end 별도 기록PiPolicy가 전처리·추론sim rollout 절차
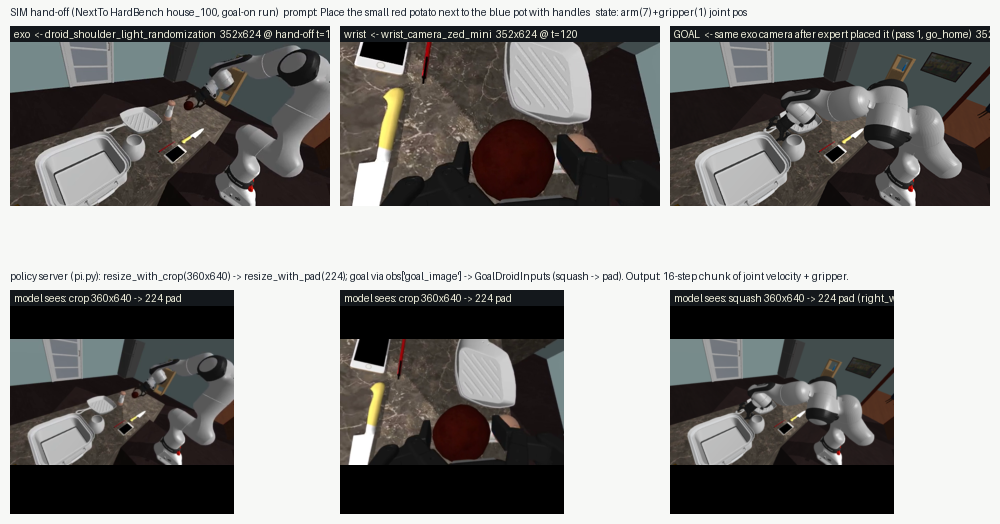
grasp_collision_*) 추가. expert 등록 → task.reset()에서 계획(grasp 샘플 + 배치 위치 샘플 + IK 검사)task.register_policy(policy); policy.reset(); episode_step_count = 0. 물체 파지 확인(grasp_state.held)정책이 매 step 받는 것은 아래와 같다. sim 관측 카메라는 droid_shoulder_light_randomization(352×624)로, 학습 관측 카메라와 다른 이름·랜덤화이지만 이 프로젝트의 모든 rollout 수치가 같은 설정이다.
goal-on 변형 (handoff_goal.py)
task.reset() 직후 MuJoCo 상태를 mj_getState(mjSTATE_INTEGRATION)로 저장mj_setState + forward, 캐시 무효화, 같은 시드로 task.reset() → 같은 계획. qpos drift 2e-16 assertgoal_image를 붙여 서버로 전송 → GoalDroidInputs변형 3종: 늦은 프레임(HANDOFF_GOAL_DELAY=30, 팔이 물체에서 떨어진 뒤), 틀린 goal(HANDOFF_GOAL_BANK, 다른 에피소드의 goal PNG), 다른 시점(HANDOFF_GOAL_CAMERA=randomized_zed2_analogue_2, 진행 중). goal 없이 학습한 ckpt는 이 키를 버리므로 같은 러너에서 goal-off와 동일하게 동작한다.
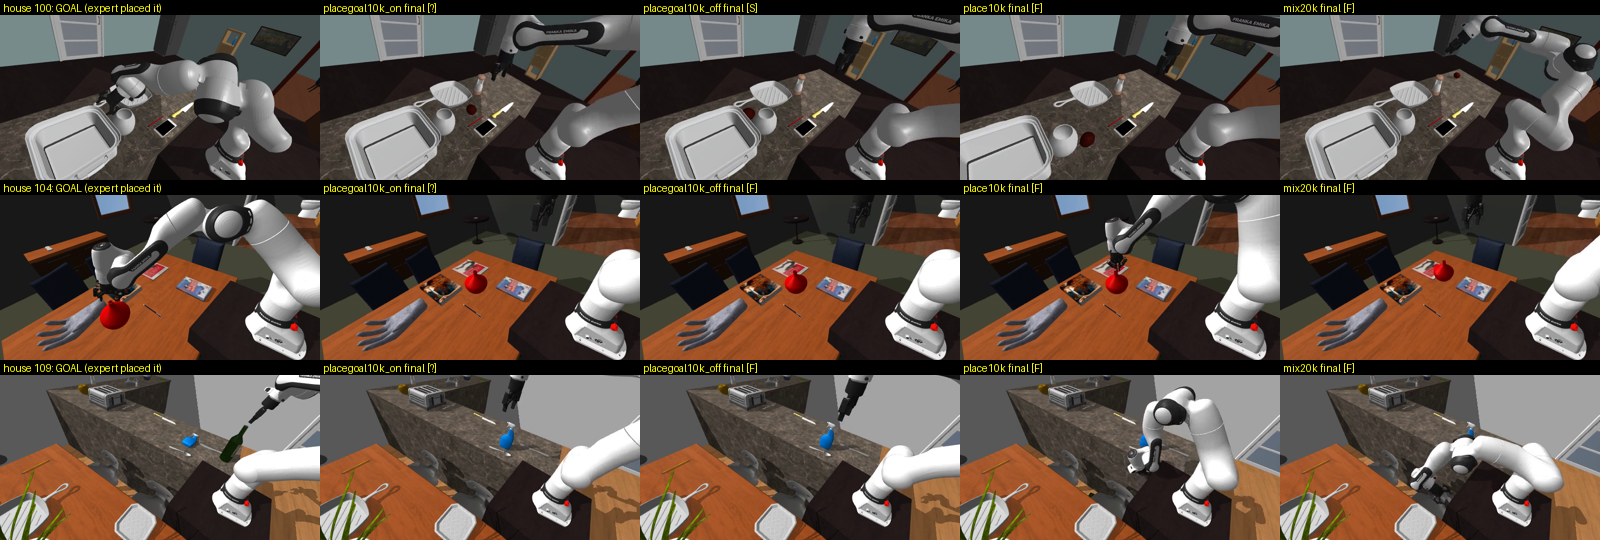
결과
분모: 200편 중 무엇이 평가됐나
| 단계 | goal-off 계열 (mix20k · place10k · goal off) | goal-on 계열 (on · 늦은 프레임 · 틀린 goal) | 이유 |
|---|---|---|---|
| 벤치 에피소드 | 200 | 200 | |
| expert 계획 예외 (h5 없음) | −45 | −58 | grasp 후보에 대해 preplace/place IK가 24×2회 재샘플로도 불가. goal-on은 pass 1 완주까지 필요해 더 많음 |
| hand-off 시 물체 미파지 / expert 포기 | −13 | −25 | grasp 실패·lift 중 낙하, pass 1의 place/retreat 타임아웃 9편 |
| 평가된 편수 | 142 | 117 | 시드 고정으로 계열 내 집합 동일. 비교는 공통 117편 |
성공률
| 조건 | 전체 | 공통 117편 | 놓음 | goal-on과 쌍별 (only-a : only-b, McNemar p) |
|---|---|---|---|---|
| mix20k | 30/142 = 21.1% | 27 = 23.1% | 96.5% | 19 : 18, p=1.00 |
| place10k | 30/142 = 21.1% | 26 = 22.2% | 99.3% | 16 : 14, p=0.86 |
| place_goal10k · off | 31/142 = 21.8% | 26 = 22.2% | 99.3% | 17 : 15, p=0.86 |
| place_goal10k · on | 28/117 = 23.9% | 28 = 23.9% | 100% | — |
| place_goal10k · on, 늦은 프레임 | 28/117 = 23.9% | 28 = 23.9% | 100% | 12 : 12, p=1.00 |
| place_goal10k · 틀린 goal | 23/117 = 19.7% | 23 = 19.7% | 99.1% | 14 : 9, p=0.41 |
| expert (pass 1) | 102/142 = 71.8% | 벤치의 현실적 상한 — 정책은 그 1/3 |
mix20k vs place10k는 142편에서 17:17로 완전 동률이다. goal 조건은 on > off > wrong의 방향은 있지만 어느 쌍도 유의하지 않다(n=117, 성공률 ~22%면 표준오차 ≈ 3.8%p).
에피소드별 일치도(공통 117편, 6조건): 어느 조건에서도 성공 못 한 편 55, 1조건만 19, 2조건 18, 3조건 8, 4조건 9, 5조건 5, 6조건 모두 3. 절반은 어떤 모델도 못 풀고, 나머지는 실행마다 성패가 갈린다 — 모델 차이보다 에피소드 난이도와 샘플링 분산이 크다.
실패 분해: 물체가 어디에 놓였나
| 마지막 프레임 분류 | mix20k | place10k | goal off | goal on | 늦은 프레임 | 틀린 goal |
|---|---|---|---|---|---|---|
| 성공 (≤5 cm, 같은 면) | 19.7% | 19.0% | 17.6% | 20.5% | 19.7% | 17.1% |
| 근접 실패 (≤15 cm, 같은 면) | 18.3% | 16.9% | 16.9% | 16.2% | 15.4% | 16.2% |
| 15–40 cm 벗어남 | 28.9% | 35.9% | 32.4% | 29.1% | 37.6% | 29.9% |
| > 40 cm | 23.2% | 18.3% | 22.5% | 18.8% | 15.4% | 23.9% |
| 다른 면 (바닥 등) | 8.5% | 8.5% | 9.9% | 11.1% | 11.1% | 12.8% |
| 수용체 밀림 | 1.4% | 1.4% | 0.7% | 4.3% | 0.9% | — |
| 최종 표면거리 중앙값 (hand-off 시 0.396 m) | 0.171 m | 0.204 m | 0.227 m | 0.240 m | 0.194 m | 0.208 m |
| 10 cm 이내 비율 | 32% | 27% | 29% | 32% | 25% | 29% |
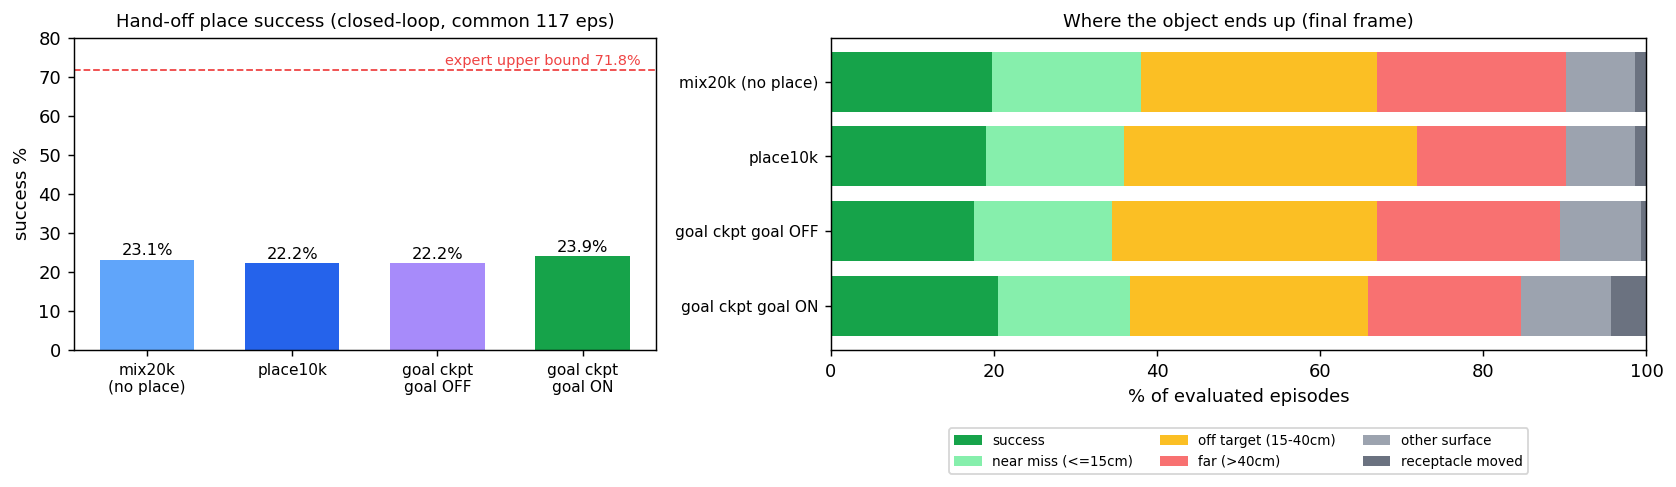
무엇이 실패하는가. 놓는 행동은 문제가 아니다(released 97–100%, 수용체 밀침 1–4%). 참조 물체 방향으로 가긴 하지만 마지막 15–40 cm를 못 맞춘다. place 데이터도, goal의 내용·시점·프레임도 이 분포를 바꾸지 못했다.
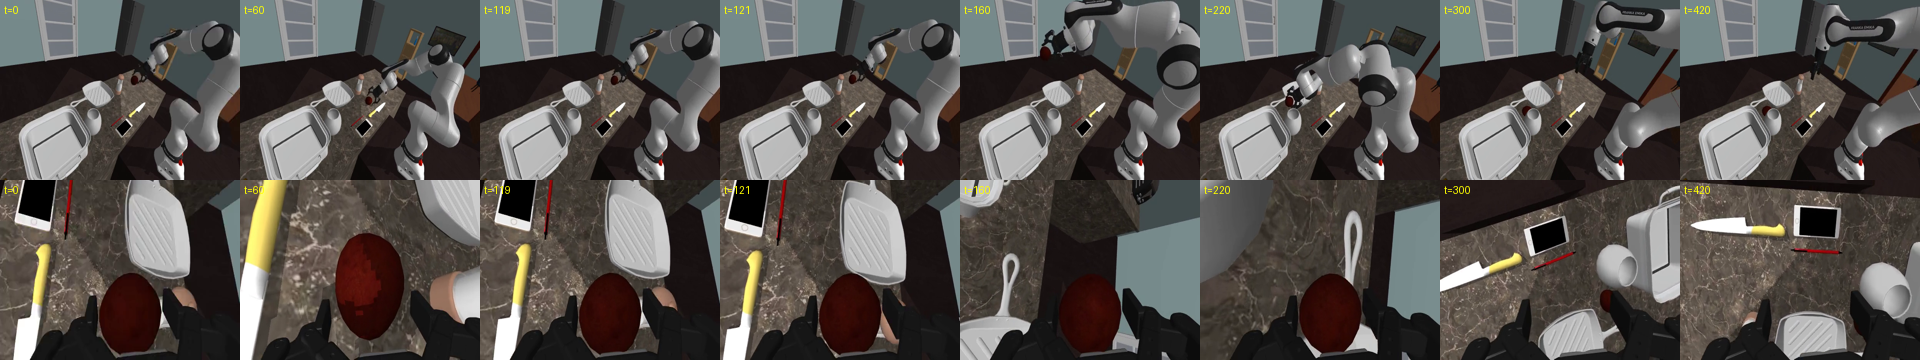
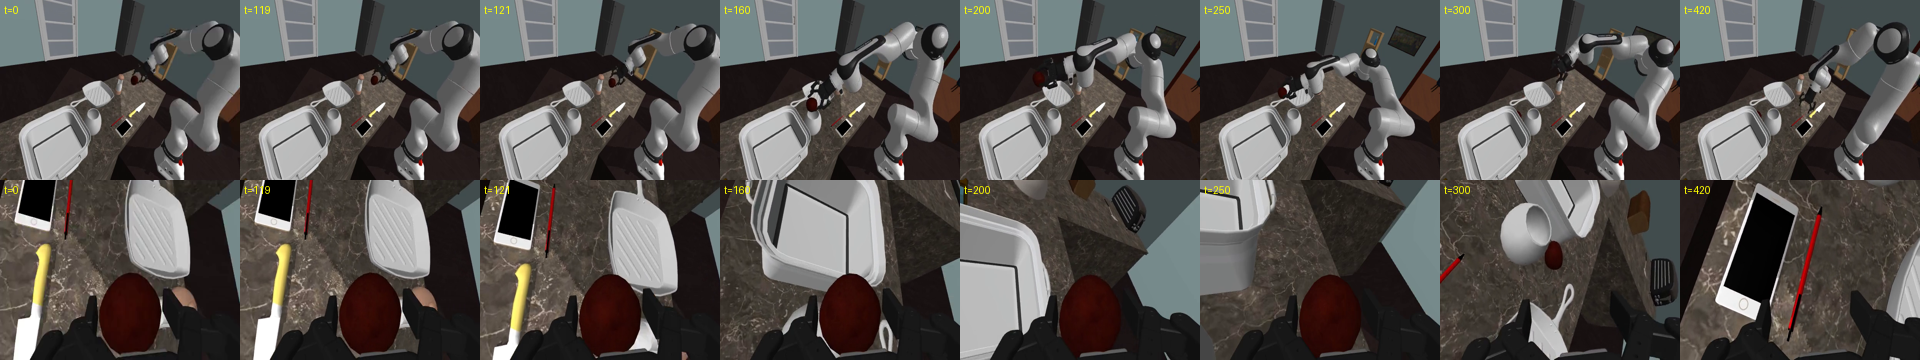
한 에피소드의 두 실행: 같은 house_100, 실패와 성공
rollout 영상: 같은 에피소드를 다섯 조건으로
각 영상은 행 = 조건(goal ON / goal OFF / 틀린 goal / place10k / mix20k), 열 = goal 이미지 | exo 카메라 | wrist 카메라. t=0이 hand-off 순간이다: scripted expert가 집어 올린 뒤(그 구간은 영상에서 뺐다) 물체를 든 상태에서 VLA가 제어를 넘겨받는 시점부터 303 step(20 s)을 15 fps 실시간으로 보여 준다. 첫 0.5 s의 노란 테두리가 hand-off 표시다. 라벨의 판정은 종료 시점 상태(성공 / 근접 실패 ≤15 cm / 15–40 cm / far / 다른 면)이고, 본문 집계의 성공은 0.5 s 지속 판정이라 드물게 다를 수 있다(house_117).
영상 8편(약 13 MB)은 대시보드 사본에 모두 들어 있다. 아티팩트 사본은 용량 제한으로 4편(두 실행 비교, house_116, house_100, house_104)만 내장했다.
무엇이 깨졌고 무엇이 됐나
학습 3회 실패, 벤치 스모크 11회. 각각 원인과 수정(모두 claude/context.md 함정 17–27로 기록).
goal 학습 (4차에 성공)
${VAR:-default} 우선순위 — EXP_NAME이 place/에 붙어 place/10000에서 auto-resume. 1분 만에 취소, 덮어써진 train_config.pkl은 ckpt assets에서 복구. resume 가드 추가KeyError 'observation.goal_image' — goal_im 없는 데이터셋(main·Pick…) 샘플에 키가 없는데 RepackTransform은 무조건 찾음. 단일 데이터셋 테스트로는 안 걸림 → placeholder + valid=False 항상 부착IndexError — UnchunkObservationTransform이 observation.* 전 키에 v[0]을 적용. 0-d valid가 터지고 이미지 첫 축이 잘릴 뻔 → 선두 horizon 차원(1) 추가. 로더·transform 단위 테스트가 아니라 전체 체인 + 이질 데이터셋 혼합으로만 잡힌다__getitem__ 안 비디오 디코드 직후 libpng error로 전부 실패(0/200) → PIL로 교체hand-off 벤치 스모크 (11회)
@hydra.main은 config_path를 패키지 경로로 해석 → 진입 파일에 main을 따로 두고 __wrapped__ 호출POLICY_SERVER_PORT로Invalid name 'grasp_collision_0' — JSON eval sampler는 policy의 add_auxiliary_objects를 부르지 않음 → sampler 서브클래스에서 planner 보조 body 추가float + None — bench JSON에 min/max_surface_to_surface_gap이 없음 → 태스크와 같은 fallback(0 / 0.05 m)으로 채움task_sampler_config.max_place_receptacle_sampling_attempts를 읽음 → expert config에 데이터 생성용 sampler 설정collect_info KeyError position_error — NextTo task_info는 xy_distance만 있음. Q1까지의 NextTo 17%도 이 KeyError 뒤 pipeline 요약에서 읽은 값(비교 유효). 키 fallback 패치IK failed for preplace pose — 원본 planner는 배치 위치를 1회만 샘플. 프로브: grasp는 시드 무관하게 같고 성공 배치는 x≈1.25–1.28 m의 좁은 영역, 시드 0은 8샘플 전부 밖 → 24회 × grasp 2회 재샘플(예외 대신 None 루프)확인된 것
- hand-off 상태는 학습 클립과 같은 phase에서 생성되고, 시드 고정으로 세 ckpt가 정확히 같은 142편을 평가했다(expert 불가 집합 동일).
- goal-on 변형의 상태 복원은 qpos drift 2e-16, 복원 후 재계획도 같은 지점(119 step)에서 hand-off.
- goal 주입 경로는 학습 경로 출력이 기존과 바이트 동일, 추론 경로(base 224×224)가 학습 goal의 224 pad와 정확히 일치.
- goal_shuffle(틀린 goal) 대조군은 460궤적 derangement, 같은 house로 떨어진 6편 제외 전부 다른 장면.
해석과 한계
open-loop vs closed-loop. val L1은 시연 상태 분포 위에서 "다음 16 step을 시연처럼 예측하는가"를 잰다. place 데이터와 goal은 이 예측을 확실히 좋게 했다. 그러나 closed-loop에서 정책은 자기 행동으로 만든 상태를 보게 되고, 그 상태에서의 마지막 15–40 cm 정밀 접근은 두 개입 모두 바꾸지 못했다. val open-loop L1은 이 질문의 대리 지표로 부족하다 — 이번에 −22%가 성공률 0%p였다.
goal 도메인. 기하(squash vs crop)는 crop 프로브로 대부분 기각됐다(이득의 73% 유지). 프레임 시점(팔이 위에 있느냐)도 무관했다. 남은 것은 시점이다: 학습 goal은 관측과 다른 제3 시점의 완료 장면인데 sim goal은 관측 카메라와 같은 시점이었다. 다른 랜덤 exo 카메라로 goal을 만드는 진단(107886)이 이를 가른다.
벤치 자체의 한계. (i) expert 불가 29%가 빠져 분모가 142/117편이고, 그 집합은 "expert가 풀 수 있는 쪽"으로 치우친다. (ii) 성공 판정 5 cm는 엄격하다 — 근접 실패(≤15 cm)까지 합치면 36–40%다. (iii) sim 관측 카메라(droid_shoulder)가 학습 관측 카메라와 다르다는 점은 모든 rollout 수치가 공유하는 조건이다. (iv) n=117에서 ±4%p 이하 효과는 검출되지 않는다.
사용자 파이프라인에 대해. 현재 ckpt 세 개(mix20k·place10k·place_goal10k) 중 어느 것을 hand-off에 써도 sim 기준 성공률은 같다. goal을 줄 거라면 저장된 사전 관측을 관측과 같은 전처리로 넣으면 되지만(pi.py passthrough), 이번 결과로는 그것이 성공률을 올린다는 근거가 없다.
다음
- 시점 진단(107886) 결과 확인. 효과가 있으면 goal을 "관측과 다른 고정 카메라"로 정의하고 그 조건으로 배포·재평가.
- 효과가 없으면 goal 재학습보다 정밀 배치 자체를 다룬다: 배치 직전 구간 오버샘플링, wrist 카메라 비중, place 지점을 명시하는 저수준 목표(좌표·마커) 조건화, NextTo 판정 거리별 커리큘럼.
- 벤치 보강: grasp 후보 다양화로 expert 불가 29%를 줄이고, 근접 실패(≤15 cm)를 보조 지표로 같이 보고.
- 지표: 이후 모든 hand-off 관련 판단은 이 벤치의 성공률 + 최종 표면거리 분포로 한다. val L1은 학습 진단용으로만.
경로와 잡
| 항목 | 위치 |
|---|---|
| 벤치 러너 | MolmoBot-Pi0/molmobot_pi0/eval/handoff.py, handoff_goal.py, 진입 eval_handoff*.py |
| 제출·집계 | scripts/rollout_handoff.sh (env: MODEL_DIR, CKPT_STEP, TAG, HANDOFF_GOAL, HANDOFF_GOAL_DELAY, HANDOFF_GOAL_BANK, HANDOFF_GOAL_CAMERA), scripts/summarize_handoff.py |
| val open-loop | scripts/eval_place_val.py, run_place_val.sh (GOAL_CAMERA, GOAL_SHUFFLE, GOAL_PREPROC) |
| goal 주입 | molmobot_pi0/goal_image.py (GoalImageLoader, GoalDroidInputs), dataset.py, dataset_openpi.py, eval/policies/pi.py |
| 데이터 | ~/Dataset/molmo_augment_place/{train,val} (변환 scripts/convert_molmo_augment.py, 분할 split_augment_val.py) |
| ckpt | ~/ckpts/molmobot_pi05_runs/pi05_mlspaces_finetune/{pi05_mlspaces_mix/20000, pi05_mlspaces_place/10000, pi05_mlspaces_place_goal/10000} |
| 결과 JSON | ~/ckpts/molmobot_pi05_runs/handoff_eval/results/*.json, ~/ckpts/molmobot_pi05_runs/place_val/*.json; 에피소드 h5·mp4·goal PNG는 handoff_eval/<tag>/step10000/eval_data/pi/10000/... |
| 잡 | 학습 105831(place) 107382(place_goal) · val 107310-12 107598-600 107743 · hand-off 107595-97 107603 107752 107753 107886 |
| 로그 | claude/260902/analysis-place_q1_results.md, progress-handoff_place_bench.md, analysis-handoff_closed_loop_q1q2.md, claude/context.md 함정 17–27 |