goal 조건화 v2 (late-attention + 배치 완료 프레임): hand-off replace 3.4% → 12.8%, goal까지 거리 31 → 13 cm
TL;DR
- 성공 기준을 replace로 보강: 놓았음 ∧ goal 이미지 속 물체 위치까지 xy ≤ 5 cm ∧ 높이 차 ≤ 5 cm(같은 면). 구 NextTo(참조물체 옆 어디든)는 replace를 재지 못했음 — v1 goal-on NextTo 성공 28편 중 replace는 3편.
- v2 = goal을 언어 뒤 별도 attention 블록으로, 관측과 같은 카메라의 "배치 완료 후" 프레임으로 (π0.7식 비대칭 attention, 존재 2/3). 같은 데이터·같은 10k step·같은 init.
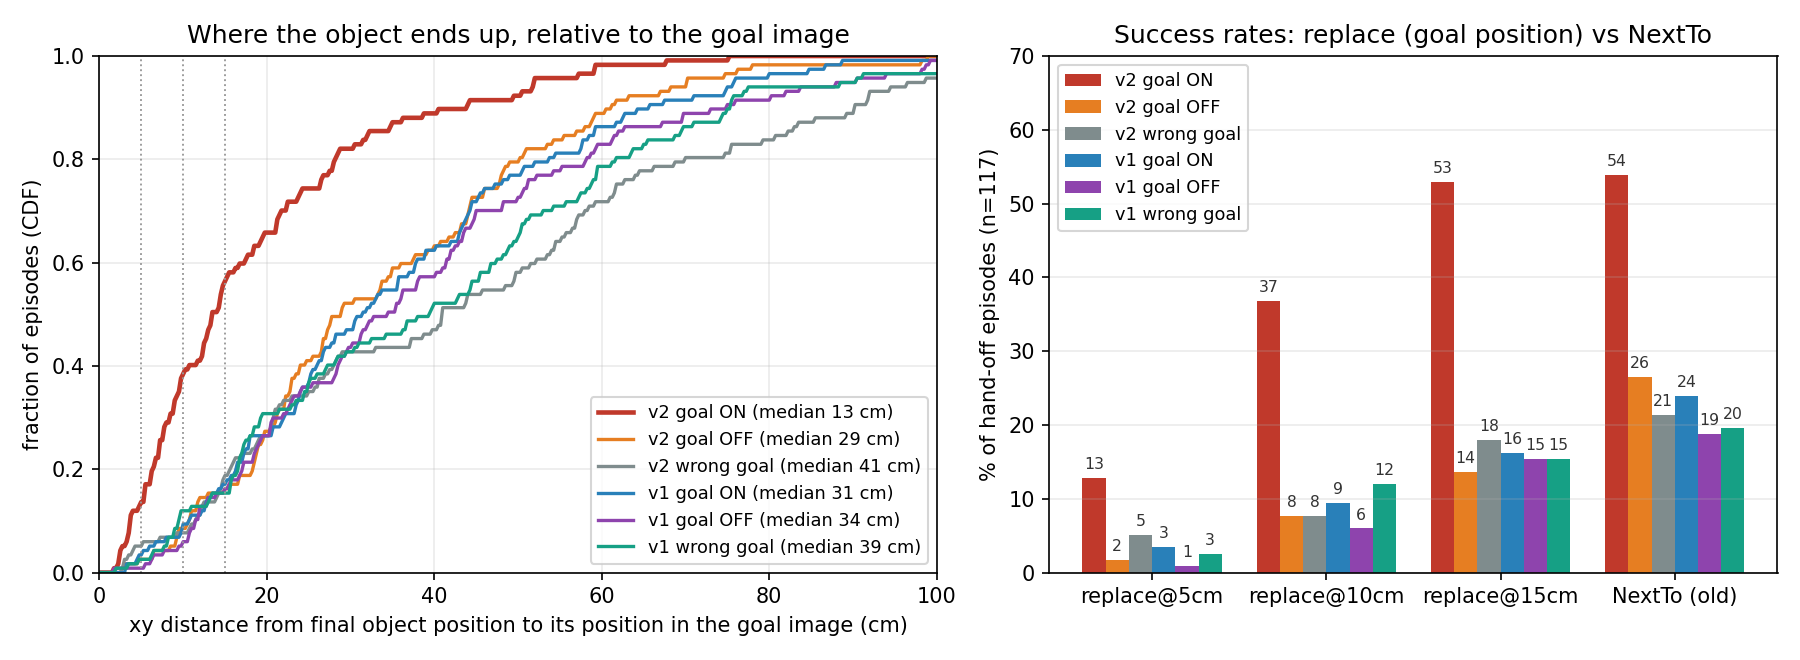
- closed-loop hand-off (117편): replace@5cm 12.8% (v1 3.4%, goal off 1.7%), @10cm 36.8% (9.4% / 7.7%), goal까지 거리 중앙값 13.4 cm (31.4 / 28.9), NextTo 53.8% (23.9 / 26.5). 쌍 비교 전부 p < 1e-5.
- goal 없이 돌리면 v2 = v1 = place10k → 향상은 전부 goal 내용. 틀린 goal이면 v2가 더 나빠짐(40.9 cm, off-surface 29편) — goal을 실제로 따라간다.
- 남은 병목: 5–15 cm 근접 실패 40%, off-surface(낙하·다른 물체 위·넘어짐) 15%, hand-off 직후 떨어뜨림 4편(벤치 측).
1 배경 / 목적
2-stage(pick → nav → place)의 low-level VLA(pi0.5)가 물체를 든 채 넘겨받아 "Place the X next to the Y"만 받고 goal 이미지 속 자리에 되돌려 놓아야 한다. v1(goal을 빈 3번째 이미지 슬롯에 넣고, 에피소드마다 시점이 다른 제3 카메라 goal_im 사용)은 open-loop L1이 −20% 좋아졌지만 closed-loop 성공률은 노이즈 범위였다.
2 작업 내용
2.1 성공 기준 보강 — replace
2.2 v2 goal 주입 방식 (π0.7 비교 후 사용자 결정)
| v1 | v2 | π0.7 (arXiv 2604.15483) | |
|---|---|---|---|
| goal 이미지 | goal_im exo_camera_2 — 관측과 다른 제3 시점(에피소드마다 다름), 480×640 squash | 관측 exo 카메라(randomized_zed2_analogue_1)의 에피소드 마지막 프레임(배치 완료 후 장면), 관측과 같은 전처리 | 같은 카메라 다중 뷰, 25% 세그먼트 끝 + 75% 0–4 s 미래 프레임(subgoal) |
| 토큰 위치·attention | 빈 3번째 이미지 슬롯(right_wrist), 관측·언어와 같은 블록(서로 다 봄) | 언어 뒤 새 블록: 관측·언어는 goal을 못 봄, goal은 관측·언어를 봄, action expert는 전부 봄 (install_late_goal_attention, openpi mask_ar 블록 시작 1) | 비대칭 attention(관측이 goal을 못 봄) |
| 존재 비율 | 50% | 2/3 (dropout 0.34) | 25% |
| 배포 시 형식 | 같음 | 같음 (배치 완료 장면 1장) | world model이 subgoal 생성 — 우리 세팅에서 불가 → 기각 |
2.3 평가
open-loop val: molmo-augment place val 39,040 프레임 L1 (goal on / off / wrong=shuffle). closed-loop hand-off: NextTo HardBench 200편, scripted expert가 집어 preplace까지 → 정책이 Place 지시문만 받음(20 s). goal-on 러너는 pass 1에서 expert를 끝까지 완주시켜 go_home 시점의 정책 base 카메라(droid_shoulder_light_randomization) 프레임을 goal로, 물체 실제 위치를 replace 기준으로 기록한 뒤 MuJoCo 상태를 복원하고 pass 2를 정책이 수행. off = 같은 pass 1 + goal 미주입(HANDOFF_GOAL_INJECT=0), wrong = 다른 에피소드의 goal(HANDOFF_GOAL_BANK). 시드 고정으로 6조건 모두 같은 117편.
3 결과
3.1 closed-loop hand-off — replace 기준 (117편; 쌍 비교는 공통 113편)
| 조건 | replace@5cm | @10cm | @15cm | goal까지 xy 중앙값 | NextTo(구) | off-surface | 놓음 |
|---|---|---|---|---|---|---|---|
| v2 goal on | 12.8% (15) | 36.8% (43) | 53.0% (62) | 13.4 cm | 53.8% (63) | 18 | 99.1% |
| v2 goal off | 1.7% (2) | 7.7% (9) | 13.7% (16) | 28.9 cm | 26.5% (31) | 17 | 98.3% |
| v2 틀린 goal | 5.1% (6) | 7.7% (9) | 17.9% (21) | 40.9 cm | 21.4% (25) | 29 | 95.7% |
| v1 goal on | 3.4% (4) | 9.4% (11) | 16.2% (19) | 31.4 cm | 23.9% (28) | 19 | 98.3% |
| v1 goal off | 0.9% (1) | 6.0% (7) | 15.4% (18) | 34.4 cm | 18.8% (22) | 18 | 98.3% |
| v1 틀린 goal | 2.6% (3) | 12.0% (14) | 15.4% (18) | 39.4 cm | 19.7% (23) | 22 | 99.1% |
3.2 물체 이동 진단 (hand-off 시 goal까지 중앙값 49.7 cm)
| 조건 | 최종→goal 중앙값 | 이동량 중앙값 | goal 방향 진행률 | 거의 안 움직임(<5 cm) | hand-off보다 가까워진 편 |
|---|---|---|---|---|---|
| v2 goal on | 14.3 cm | 44.4 cm | 0.69 | 4% | 95% |
| v2 goal off | 28.9 cm | 35.5 cm | 0.35 | 22% | 73% |
| v2 틀린 goal | 40.9 cm | 34.1 cm | 0.15 | 11% | 58% |
| v1 goal on | 31.9 cm | 32.0 cm | 0.29 | 23% | 74% |
3.3 open-loop val (L1, 39,040 프레임)
| ckpt | goal | all | arm | gripper |
|---|---|---|---|---|
| v2@10k | on | 0.0619 | 0.0579 | 0.0900 |
| v2@10k | off | 0.0871 | 0.0855 | 0.0980 |
| v2@10k | wrong | 0.1520 | 0.1575 | 0.1136 |
| v1@10k | on | 0.0720 | 0.0683 | 0.0979 |
| v1@10k | off | 0.0898 | 0.0885 | 0.0983 |
| place10k | — | 0.0870 | 0.0859 | 0.0950 |
goal 이득 v2 −28.9% (v1 −19.8%), 틀린 goal 손실 +74% (v1 +43%). goal off = place10k(0.0871 vs 0.0870) — goal 슬롯을 비워도 손해 없음.
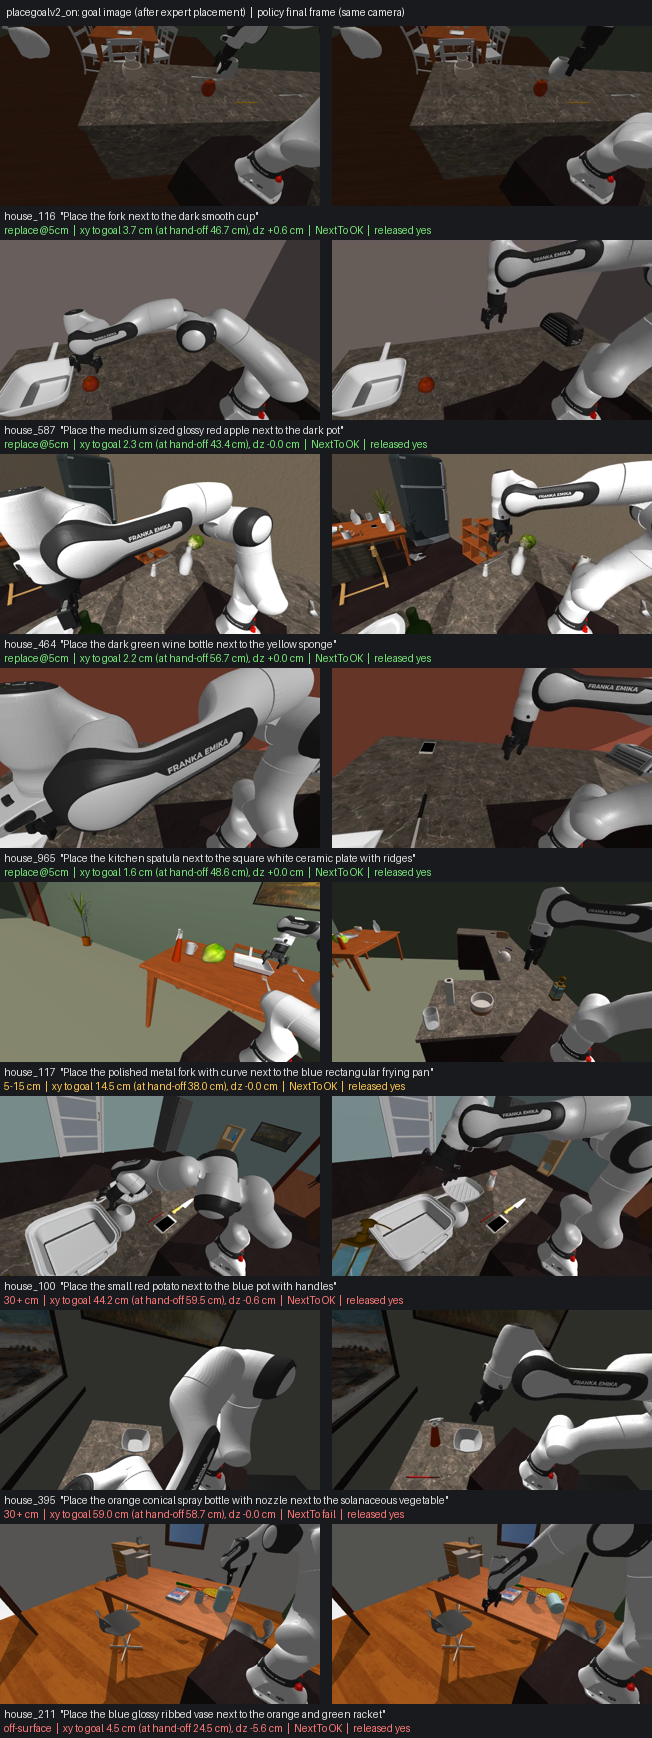
3.4 goal 이미지 vs 정책 최종 장면 (v2 goal on)
3.5 남은 실패 분해 (v2 goal on, 117편)
| 결과 | 편수 | 비율 | 설명 |
|---|---|---|---|
| replace@5cm 성공 | 15 | 12.8% | goal 자리 복원 |
| 근접 5–15 cm | 47 | 40.2% | 방향은 맞고 마지막 정밀도 부족 — 가장 큰 덩어리 |
| 15–30 cm | 16 | 13.7% | 잘못된 자리 |
| 30 cm+ | 20 | 17.1% | 이 중 4편은 네 조건 모두 이동 <2 cm(hand-off 직후 떨어뜨림, 벤치 측 문제 의심) |
| off-surface | 18 | 15.4% | 바닥 낙하 / 다른 물체 위 / 넘어짐 |
| 못 놓음 | 1 | 0.9% |
4 영상 (hand-off 시점 = VLA 제어 시작부터, 15 fps)
행: v2 goal ON / v2 goal OFF / v2 WRONG goal / v1 goal ON. 열: 모델이 받은 goal 이미지 | exo(정책 base 카메라) | wrist. 네 조건은 같은 시드로 expert가 만든 동일한 hand-off 상태에서 시작(노란 테두리 = 첫 8 프레임). 라벨의 거리 = 최종 물체 위치 → goal 이미지 속 위치.
house_116 — "Place the fork next to the dark smooth cup"
v2 goal ON만 replace 성공(3.7 cm). goal OFF 41.6 cm, 틀린 goal·v1은 다른 곳에 놓음.
v2 goal ON: REPLACE OK (3.7 cm from goal) · v2 goal OFF: FAIL: 42 cm from goal · v2 WRONG goal: FAIL: 49 cm from goal · v1 goal ON: FAIL: 57 cm from goal
house_587 — "Place the medium sized glossy red apple next to the dark pot"
v2 goal ON 2.3 cm. goal OFF 28.9 cm, v1 goal ON 43.0 cm — 같은 hand-off 상태에서 goal 주입 방식만 다름.
v2 goal ON: REPLACE OK (2.3 cm from goal) · v2 goal OFF: FAIL: 29 cm from goal · v2 WRONG goal: FAIL: 64 cm from goal · v1 goal ON: FAIL: 43 cm from goal
house_464 — "Place the dark green wine bottle next to the yellow sponge"
v2 goal ON 2.2 cm. goal OFF는 76 cm(다른 곳), v1 goal ON은 off-surface(80 cm).
v2 goal ON: REPLACE OK (2.2 cm from goal) · v2 goal OFF: FAIL: 76 cm from goal · v2 WRONG goal: FAIL: off-surface (xy 104 cm, dz -97 cm) · v1 goal ON: FAIL: off-surface (xy 80 cm, dz -12 cm)
house_965 — "Place the kitchen spatula next to the square white ceramic plate with ridges"
v2 goal ON 1.6 cm. goal 이미지가 로봇 팔로 크게 가려져 있는데도 위치를 복원. goal OFF 9.3 cm(근접), v1 17.9 cm.
v2 goal ON: REPLACE OK (1.6 cm from goal) · v2 goal OFF: near miss (9 cm from goal) · v2 WRONG goal: near miss (7 cm from goal) | NextTo OK · v1 goal ON: FAIL: 18 cm from goal | NextTo OK
house_117 — "Place the polished metal fork with curve next to the blue rectangular frying pan"
v2 goal ON 5.4 cm — 기준(5 cm) 바로 밖의 근접 실패(방향은 맞음). OFF 34.5 cm, v1 24.0 cm.
v2 goal ON: near miss (5 cm from goal) | NextTo OK · v2 goal OFF: FAIL: 34 cm from goal · v2 WRONG goal: FAIL: 19 cm from goal · v1 goal ON: FAIL: 24 cm from goal
house_100 — "Place the small red potato next to the blue pot with handles"
반례: v2 goal ON 44 cm 실패, goal OFF 10.5 cm, 틀린 goal이 오히려 3.8 cm(언어·장면만으로 자리가 정해지는 에피소드). goal이 항상 도움이 되진 않음.
v2 goal ON: FAIL: 44 cm from goal | NextTo OK · v2 goal OFF: near miss (10 cm from goal) | NextTo OK · v2 WRONG goal: REPLACE OK (3.8 cm from goal) · v1 goal ON: FAIL: 24 cm from goal
house_395 — "Place the orange conical spray bottle with nozzle next to the solanaceous vegetable"
공통 실패: 네 조건 모두 이동량 <2 cm — 넘겨받자마자 hand-off 지점 아래로 떨어뜨림(정책과 무관한 hand-off 상태 문제 의심).
v2 goal ON: FAIL: 59 cm from goal · v2 goal OFF: FAIL: 59 cm from goal · v2 WRONG goal: FAIL: 58 cm from goal · v1 goal ON: FAIL: 59 cm from goal
4b 추가 실험 (09-04): goal과 관측이 산만 물체에서 다를 때 — 책상 위 물체 추가/제거
벤치의 goal은 같은 장면·같은 카메라의 배치 후 프레임이라 관측과의 차이가 물체 위치·팔 자세뿐이다(base pose·카메라 파라미터 에피소드 내 변화 0 확인). 사용자 요청으로 hand-off 직후 책상 위 산만 물체를 추가(add:2)하거나 제거(remove:2)해 goal(원래 장면)과 관측이 산만 물체에서만 다른 조건을 만들었다(HANDOFF_PERTURB, molmobot_pi0/eval/scene_perturb.py). 추가 물체는 집 안의 다른 자유 물체를 참조 물체 주변 0.15–0.55 m의 상판(레이캐스트 검증)·카메라에 보이는 빈 자리로 옮기고, 제거는 보이는 상판 위 물체부터 50 m 밖으로 치운다. goal 자리·경로는 비워 둔다.
| 조건 (117편) | 실제 교란 | replace@5cm | @10cm | @15cm | goal까지 중앙값 | NextTo |
|---|---|---|---|---|---|---|
| v2 goal on (무교란) | — | 12.8% | 36.8% | 53.0% | 13.4 cm | 53.8% |
| v2 goal on + add:2 | 73편, 평균 1.12개 | 12.0% | 30.8% | 41.9% | 16.0 cm | 46.2% |
| v2 goal on + remove:2 | 107편, 평균 1.78개 | 7.7% | 26.5% | 45.3% | 15.9 cm | 39.3% |
| v2 goal on + add:2, remove:2 | 112편 | 11.1% | 23.9% | 41.9% | 16.9 cm | 49.6% |
| v2 goal off (무교란) | — | 1.7% | 7.7% | 13.7% | 28.9 cm | 26.5% |
| v2 goal off + add:2 | 73편 | 2.6% | 8.5% | 17.9% | 29.3 cm | 28.2% |
| v2 goal off + remove:2 | 107편 | 5.1% | 10.3% | 17.1% | 30.9 cm | 27.4% |
5 Takeaway
Q2 답: goal 이미지는 "어떻게 넣느냐"가 결정적
같은 데이터·같은 step·같은 init에서 goal을 언어 뒤 별도 블록으로, 관측과 같은 카메라의 배치 완료 프레임으로 주니 closed-loop replace@5cm 3.4% → 12.8%, @10cm 9.4% → 36.8%, goal까지 거리 31 → 13 cm, NextTo 24% → 54%(expert 상한 71.8%). v1처럼 빈 슬롯에 제3시점 goal을 넣으면 open-loop만 좋아지고 closed-loop는 못 바꿨다 — "pretrained 분포와 다른 자리" 우려가 맞았다.
goal 없이 돌리면 v2 = v1 = place10k(replace@5 1–2%). 즉 향상은 전부 goal 내용에서 오고, 모델은 틀린 goal도 따라간다(off-surface 17 → 29편). goal 의존이 강한 만큼 배포 시 goal 이미지의 품질(같은 장면·같은 카메라)이 성능을 좌우한다.
NextTo(구 기준)와 replace의 괴리는 여전히 크다(54% vs 13%). 최종 목표(5 cm 복원)까지의 병목은 마지막 5–15 cm 정밀도(40%).
6 Next Steps
정밀도 (근접 5–15 cm, 40%)
(a) inference에서 goal을 pass 1 프레임 하나로 고정하지 말고 매 step 같은 goal을 유지하되 존재 비율을 더 높여(2/3 → 1) 학습, (b) place 데이터 학습 step 10k → 20k, (c) 마지막 구간을 wrist 카메라 중심으로 보게 하는 정밀 배치 데이터 가중, (d) goal 해상도/크롭(현재 obs와 같은 224 pad) 상향.
off-surface 15%
놓는 높이 판단 실패. goal 프레임에 로봇 팔이 크게 가리는 경우(house_965·464)의 영향 확인 → goal 프레임을 retreat 이후(팔 없는 장면)로 찍는 변형(HANDOFF_GOAL_DELAY) 재평가.
배포 형식 강건성
벤치의 goal은 "같은 카메라·같은 장면의 배치 후 프레임"이라 최적 조건. 실제 2-stage에서는 goal이 이전 시점(pick 전)·다른 로봇 포즈·다른 조명일 수 있음 → v1 wrong(다른 에피소드)이 아니라 "같은 장면, 다른 포즈/시간"의 goal로 강건성 평가.
벤치 점검
네 조건 모두 hand-off 직후 떨어뜨리는 4편(house_258/374/395/566): expert hand-off 상태(그립·물체 자세) 문제 여부 확인 후 분모에서 제외할지 결정.