"물체를 든 채 시작 + Place 명령만" — closed-loop hand-off 벤치로 Q1·Q2 재측정
TL;DR
- 측정을 사용자 정의로 바꿨다: 기존 HardBench(pick부터)·val open-loop L1이 아니라, scripted expert가 물체를 집어 preplace까지 간 뒤 정책이
Place the X next to the Y만 받는 closed-loop hand-off 벤치를 새로 만들어 쟀다. - Q1 place 데이터: open-loop L1은 −22%(gripper −36%)지만 closed-loop 성공률은 21.1% → 21.1%로 무변화(142편, 쌍별 17:17 완전 동률).
- Q2 goal image: 학습 분포(val)에서는 확실히 읽는다 — goal on이 arm −23%, 틀린 goal은 +50% 오도. 그러나 closed-loop에서는 23.9% vs 22.2%(p=0.86)로 이득 없음. 최종 위치 분포도 동일.
- 병목은 "어디에 놓느냐": 놓기 자체는 97–100% 하지만 최종 표면거리 중앙값 0.17–0.24 m, 10 cm 이내는 27–32%뿐. expert 상한은 71.8%.
- 교훈: val open-loop L1은 성공률 대리 지표로 부족했다(−22%가 0%p). goal 도메인 갭(squash vs crop) 가설은 프로브로 대부분 기각 — crop goal도 이득의 73% 유지(0.0768). 남은 진단 2잡(틀린 goal closed-loop, 늦은 goal 프레임)을 extra 큐에 넣었다(§5).
1 배경 / 측정 정의
2-stage(pick → navigation → place)의 low-level VLA가 물체를 든 채 제어권을 넘겨받은 뒤 잘 내려놓지 못한다. 두 질문: Q1 place 전용 데이터(molmo-augment, NextTo의 preplace→retreat 구간 15k편)로 학습하면 잘 놓는가, Q2 goal image를 넣는 것이 큰 의미가 있는가.
그래서 그 상황을 그대로 재현하는 closed-loop 벤치를 만들었다. 학습 클립이 잘린 지점(expert phase preplace)과 같은 시점에서 정책에 넘기므로 시작 상태 분포가 학습 데이터와 일치한다.
2 벤치 구축과 실험 설계
hand-off place 벤치 (molmobot_pi0/eval/handoff.py)
- 에피소드: NextTo HardBench 200편(held-out procthor-10k val). val split은 NextTo aux 데이터와 house가 겹쳐 closed-loop 벤치로는 HardBench가 더 깨끗하다.
- 절차: molmo_spaces의 데이터 생성용 scripted expert(
PickAndPlaceNextToPlannerPolicy)를 등록한 채 reset → gripper-open→pregrasp→grasp→close→lift → phase가preplace가 되는 순간 학습 정책으로 교체, 지시문은 학습과 같은 규칙으로Place the X next to the Y, horizon 20 s(학습 클립 ~6.5 s의 3배). - 판정: NextTo 기준(표면 간격 ≤5 cm · 같은 표면 · 수용체 안 밀림, 0.5 s 지속). NextTo 판정에는 "놓았는지" 검사가 없어
released_at_end를 별도 기록. - 분모: expert가 preplace에 도달한 편. expert 계획·grasp 샘플링을 (house, episode) 시드로 고정해 ckpt 간 동일 에피소드 집합(142편; expert 불가 58편 동일).
- goal-on 변형 (
handoff_goal.py): pass 1로 expert를 완주시켜 배치 후 exo 프레임을 goal로 확보 → MuJoCo 상태를 reset 직후로 복원(mj_setState, qpos drift <1e-6 assert) → 같은 시드로 재계획 → pass 2 hand-off에서 관측에goal_image를 붙여 서버로 전송.
실험 목록
| job | 내용 | 목적 |
|---|---|---|
| 107382 | pi05_mlspaces_place_goal 학습 (init droid, 10k step, goal exo_camera_2, dropout 0.5), loss 0.0050 | place10k와 goal 유무만 다른 A/B |
| 107598 / 107599 / 107600 | val open-loop L1: goal on / off / shuffle(다른 에피소드의 goal) | goal의 내용을 읽는가 |
| 107595 / 107596 / 107597 | hand-off 벤치: mix20k / place10k / place_goal10k(goal off) | Q1, Q2 closed-loop |
| 107603 | hand-off 벤치 goal-on 변형: place_goal10k | Q2 closed-loop |
| 107743 | val: 학습 goal PNG를 관측처럼 crop해 넣은 L1 (GOAL_PREPROC=crop) | goal 도메인 갭 프로브 |
3 결과
① val open-loop L1 (39,040 프레임, 정규화 공간, 낮을수록 좋음)
| 모델 | all (8d×16) | arm (7d) | gripper (1d) | step0 |
|---|---|---|---|---|
| mix20k (place 없음) | 0.1116 | 0.1062 | 0.1495 | 0.1097 |
| place10k | 0.0870 | 0.0859 | 0.0950 | 0.0856 |
| place_goal10k, goal off | 0.0898 | 0.0885 | 0.0983 | 0.0881 |
| place_goal10k, goal on | 0.0720 | 0.0683 | 0.0979 | 0.0732 |
| place_goal10k, 틀린 goal(shuffle) | 0.1285 | 0.1324 | 0.1016 | 0.1263 |
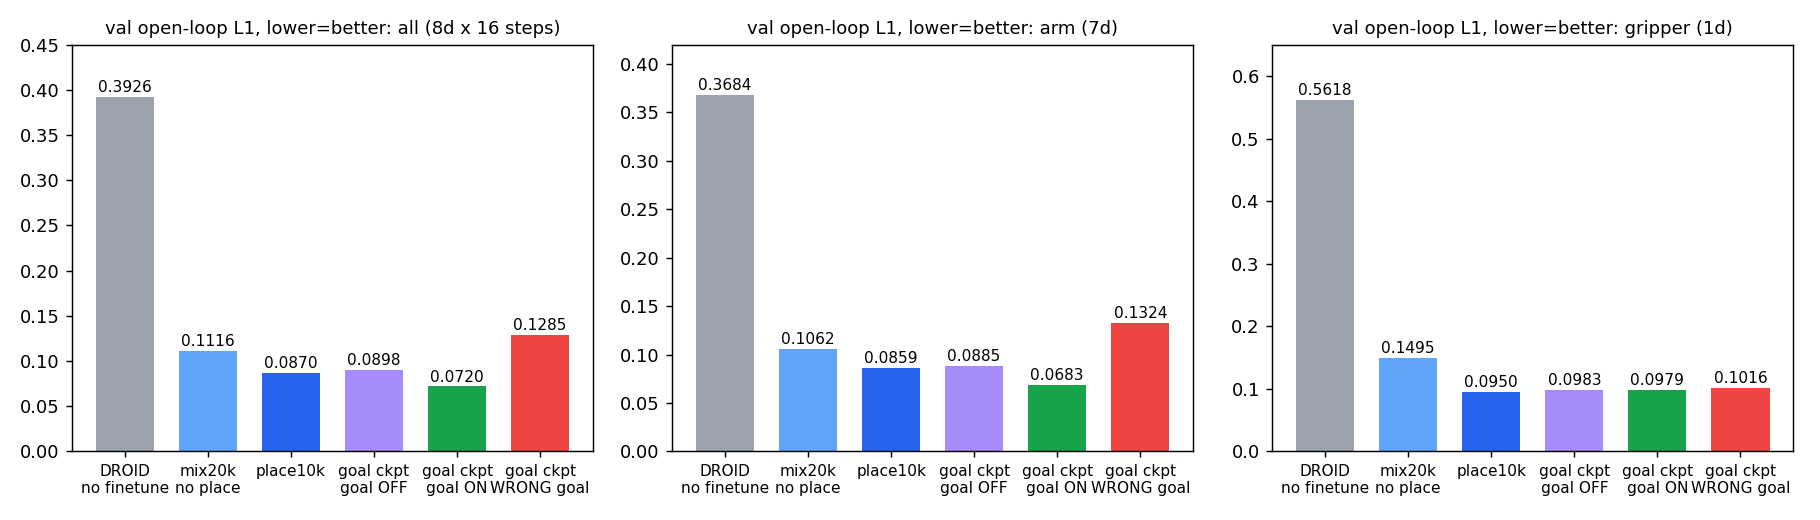
② closed-loop hand-off 성공률
| 모델 | 전체 (평가 편수) | 공통 117편 | 놓음 | vs goal-on (McNemar) |
|---|---|---|---|---|
| mix20k (place 없음) | 30/142 = 21.1% | 27 = 23.1% | 96.5% | 19:18, p=1.00 |
| place10k | 30/142 = 21.1% | 26 = 22.2% | 99.3% | 16:14, p=0.86 |
| place_goal10k, goal off | 31/142 = 21.8% | 26 = 22.2% | 99.3% | 17:15, p=0.86 |
| place_goal10k, goal on | 28/117 = 23.9% | 28 = 23.9% | 100% | — |
| scripted expert (pass 1 완주) | 102/142 = 71.8% | 벤치의 현실적 상한 | ||
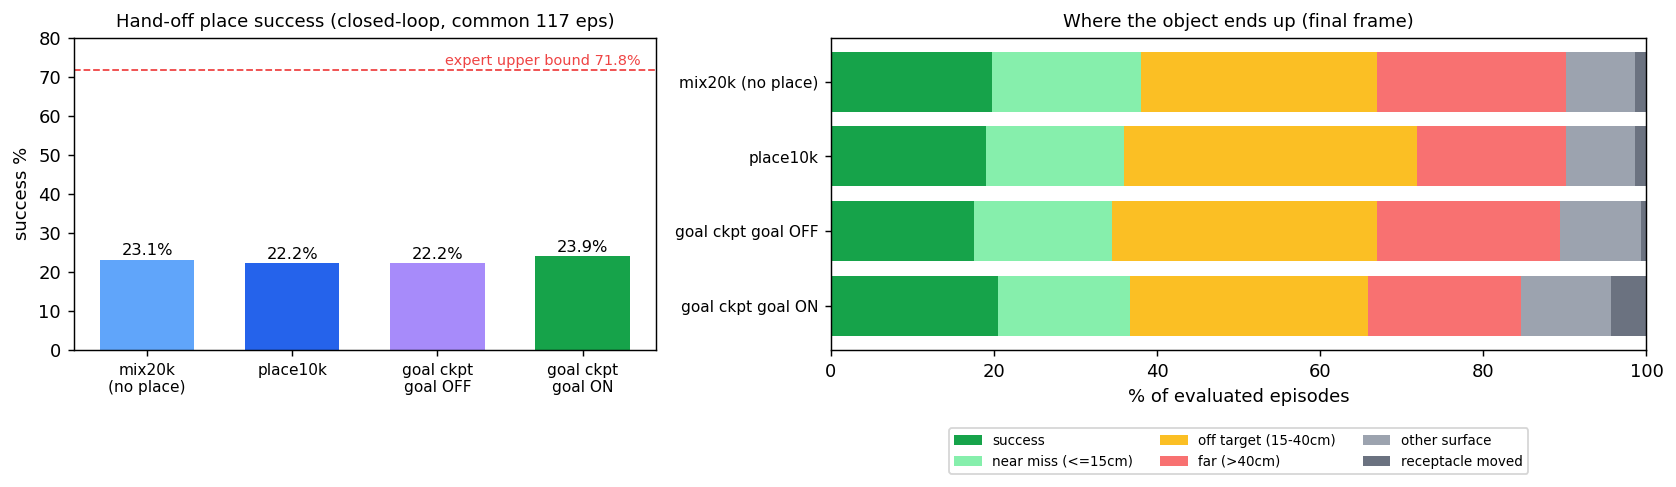
③ 실패 분해 (마지막 프레임의 물체–수용체 표면 거리)
| 분류 | mix20k | place10k | goal off | goal on |
|---|---|---|---|---|
| 성공 | 19.7% | 19.0% | 17.6% | 20.5% |
| 근접 실패 (≤15 cm, 같은 표면) | 18.3% | 16.9% | 16.9% | 16.2% |
| 15–40 cm 벗어남 | 28.9% | 35.9% | 32.4% | 29.1% |
| >40 cm | 23.2% | 18.3% | 22.5% | 18.8% |
| 다른 표면(바닥 등) | 8.5% | 8.5% | 9.9% | 11.1% |
| 수용체 밀림 | 1.4% | 1.4% | 0.7% | 4.3% |
| 최종 표면거리 중앙값 (hand-off 시 0.396 m) | 0.171 m | 0.204 m | 0.227 m | 0.240 m |
| ≤10 cm 비율 | 32% | 27% | 29% | 32% |
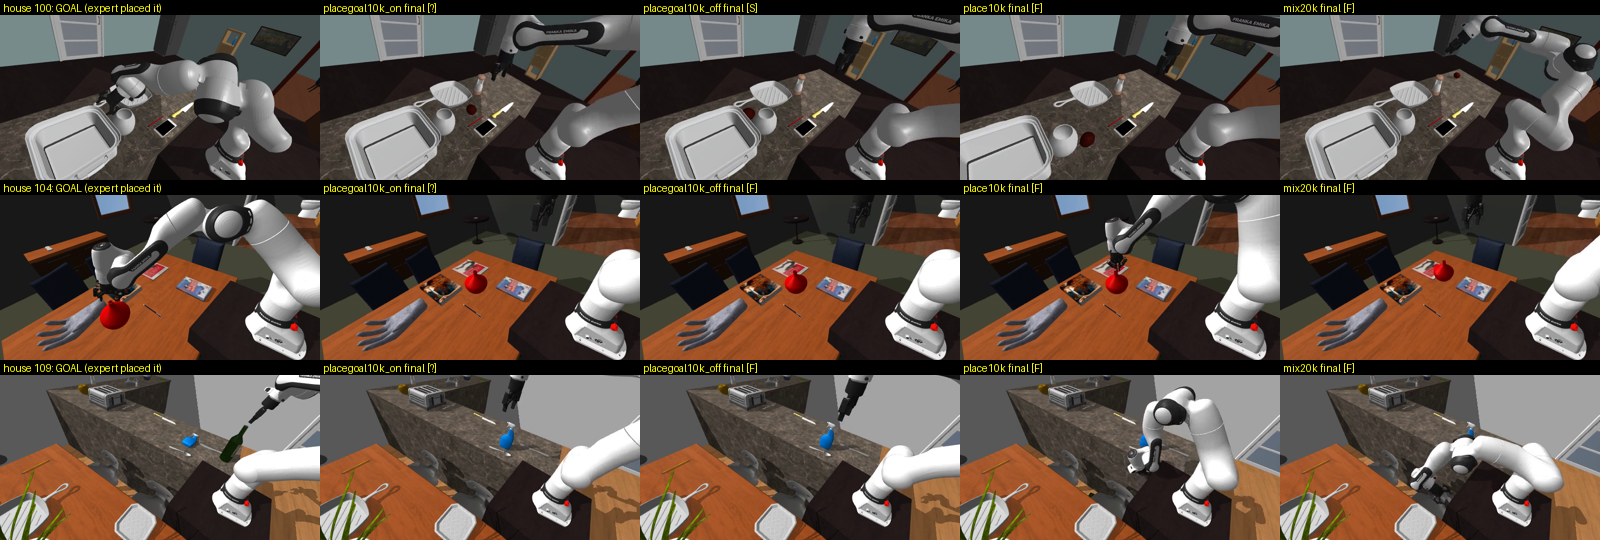
네 모델 모두 물체를 hand-off 지점에서 절반쯤 가져가서 놓는다. 놓는 행동은 문제가 아니고(released 97–100%), 참조 물체까지 마지막 15–40 cm를 못 맞춘다. place 데이터도 goal도 이 분포를 못 바꿨다.
4 Takeaway
의미
Q1 재답: place 데이터는 시연 행동의 재현(open-loop, 특히 릴리즈 타이밍)은 확실히 좋게 하지만, 사용자가 원하는 "놓기 성공률"은 그대로다. 오전의 "place를 잘한다"는 결론은 val L1을 과신한 오판이었다.
Q2 재답: goal image는 학습 분포에서 큰 의미가 있다(arm −23%, 틀린 goal이 오도). 하지만 sim closed-loop hand-off에서는 이득이 0이고 최종 위치 분포조차 안 움직였다 — sim에서는 goal이 사실상 안 읽히는 것으로 보인다.
가장 유력한 원인 = goal 도메인 갭. 학습 goal은 원본 카메라의 480×640(4:3) 프레임을 360×640으로 세로 squash한 것이고, 관측은 같은 프레임을 center-crop한 것이다. sim 배포 goal은 eval 카메라 352×624(16:9), 즉 관측과 같은 크롭형 기하이고 squash가 없다. 모델은 "squash된 goal"만 배웠다.
지표 교훈: open-loop L1(전 프레임 평균 action 오차)은 이송 구간의 방향 예측 개선을 크게 잡지만, 마지막 15–40 cm의 정밀 배치 실패는 못 잡는다. 이 프로젝트의 지표는 hand-off 벤치 성공률 + 최종 표면거리 분포여야 한다.
5 Next Steps
goal 도메인 갭 프로브 (job 107743) 완료
val에서 학습 goal PNG를 관측과 같은 전처리(resize + center-crop, 360×640)로 넣은 L1 = 0.0768 (goal on 0.0720 / off 0.0898). crop 기하로도 goal 이득의 73%가 유지된다 → squash/crop 기하 차이는 closed-loop 무효과의 주원인이 아니다(잔여 27%만 설명).
| goal 조건 | all | arm | gripper |
|---|---|---|---|
| off | 0.0898 | 0.0885 | 0.0983 |
| on (학습 기하, squash) | 0.0720 | 0.0683 | 0.0979 |
| on, crop (배포 기하) | 0.0768 | 0.0739 | 0.0978 |
| 틀린 goal | 0.1285 | 0.1324 | 0.1016 |
진단 2잡 제출 (extra 큐, own 보존) 대기/진행
107752 틀린 goal closed-loop(다른 에피소드의 goal PNG) 완료: 19.7%(23/117) vs goal on 23.9% / off 22.2%. 방향은 on > off > wrong이지만 유의하지 않고(on vs wrong 14:9, p=0.41) 최종 위치 분포도 같다(중앙값 0.208 m, ≤10 cm 29%) → sim closed-loop에서 goal 내용의 영향은 약하며 정밀 배치를 바꾸지 못한다. open-loop(틀린 goal +43%)와 대조적.
107753 늦은 goal 프레임(go_home 진입 30 step 뒤, 팔이 물체에서 떨어진 장면) 완료: 23.9%(28/117), goal-on과 쌍별 12:12로 정확히 동률 — goal 프레임 시점도 무관.
| 조건 (공통 117편) | mix20k | place10k | goal off | goal on | goal on, 늦은 프레임 | 틀린 goal |
|---|---|---|---|---|---|---|
| hand-off 성공률 | 23.1% | 22.2% | 22.2% | 23.9% | 23.9% | 19.7% |
그 뒤
둘 다 무효과로 확인됐으므로 goal 재학습(crop 전처리·늦은 프레임)은 우선순위가 낮다. 정밀 배치 자체(마지막 15–40 cm; 참조 물체 접지)를 다루는 방향이 맞다 — NextTo 전체 태스크가 어떤 데이터 혼합에도 무변화였던 것과 같은 병목이다. 후보: 배치 직전 구간 오버샘플링, wrist 카메라 활용·해상도, place 지점을 명시하는 저수준 목표(좌표/마커) 조건화, NextTo 판정 거리별 커리큘럼. 사용자 2-stage 파이프라인에서는 현재 ckpt 중 어느 것을 써도 hand-off 성공률은 같다(~22%).
벤치 보완
expert 불가 29%(58/200) → grasp 후보 재시도 확대 또는 bench 필터로 분모 확대. expert 상한 71.8%도 같이 보고. 2-stage 파이프라인의 실제 goal 소스(저장된 사전 관측)도 관측과 같은 전처리를 거치게 할 것.