τ₀-WM RoboTwin 2.0 전면 진단 — baseline → RCS → ACVS
TL;DR
- baseline 49.4% vs X-WAM 90.8% (42 task 완료, 386/500 unit). 버그 5종 + 환경 결함(OIDN 디노이저)을 모두 제거한 뒤의 수치.
- 하네스는 무결 — X-WAM 공개 robotwin_sft를 같은 하네스로 돌려 82.1%(논문 90.7) 재현. 낮은 SR은 인터페이스 탓이 아니다.
- 비디오 브랜치는 정상 — 고정 클립 예측 영상 PSNR 25.2 dB / SSIM 0.86. "sim 렌더에 OOD라 conditioning이 망가졌다"는 가설은 기각.
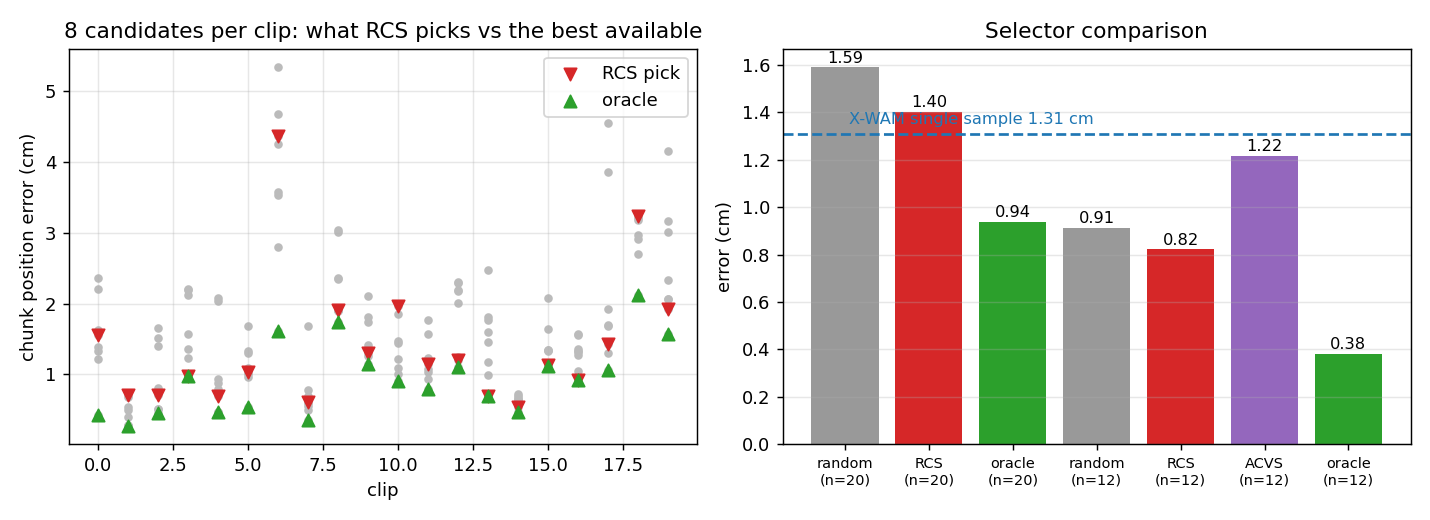
- 병목은 선택 — 후보 8개 중 오라클이 0.94 cm로 X-WAM 단일 샘플(1.31)보다 정확한데, RCS는 여지의 29%만 회수하고 공개 ACVS는 sim 도메인 미적응으로 역상관(−0.14).
- 기각된 가설: receding horizon(37%→12%), batch 384+cosine(2.26→2.63 cm), R/B 채널, adapter/normalization.
1 그냥 쓴 것 — baseline
τ₀ pretrained → RoboTwin 50 task posttrain(54k step) 후 공식 프로토콜(demo_randomized, unseen 지시문, 32-step chunk)로 평가. 아래는 같은 task·같은 하네스에서 X-WAM 공개 ckpt(위)와 τ₀(아래)를 나란히 놓은 롤아웃이다. 3분할은 head / left wrist / right wrist 카메라.
각 패널: 위 = head 카메라(장면 전체), 아래 = 좌/우 손목 카메라. 손목 뷰가 클로즈업인 것은 RoboTwin 표준 구성이며 두 모델이 받는 입력은 동일하다. 좌우는 같은 seed·같은 에피소드라 초기 씬이 일치한다(첫 프레임 픽셀 차 1.7~8.6).
per-task 결과 (진행 중: 42/50 task, 386/500 unit)
| task | τ₀ | X-WAM(논문) | 격차 | n |
|---|---|---|---|---|
| blocks_ranking_rgb | 12% | 95% | -82 | 80 |
| rotate_qrcode | 10% | 83% | -73 | 70 |
| blocks_ranking_size | 11% | 82% | -71 | 100 |
| handover_block | 11% | 79% | -68 | 90 |
| place_mouse_pad | 26% | 86% | -60 | 80 |
| open_microwave | 33% | 92% | -59 | 70 |
| move_can_pot | 25% | 84% | -59 | 100 |
| place_dual_shoes | 23% | 81% | -58 | 90 |
| lift_pot | 44% | 99% | -55 | 100 |
| place_a2b_right | 34% | 89% | -55 | 90 |
| place_fan | 38% | 92% | -54 | 90 |
| open_laptop | 43% | 97% | -54 | 100 |
| place_object_scale | 36% | 89% | -53 | 100 |
| move_stapler_pad | 19% | 70% | -51 | 100 |
| place_object_basket | 36% | 87% | -51 | 80 |
| hanging_mug | 4% | 55% | -51 | 90 |
| place_a2b_left | 43% | 87% | -44 | 100 |
| pick_diverse_bottles | 48% | 92% | -44 | 100 |
| place_bread_basket | 49% | 91% | -42 | 100 |
| place_object_stand | 55% | 96% | -41 | 80 |
| move_pillbottle_pad | 57% | 98% | -41 | 100 |
| place_can_basket | 42% | 82% | -40 | 80 |
| move_playingcard_away | 60% | 98% | -38 | 100 |
| place_burger_fries | 61% | 99% | -38 | 100 |
| place_cans_plasticbox | 63% | 98% | -35 | 100 |
| scan_object | 44% | 79% | -35 | 70 |
| handover_mic | 54% | 89% | -35 | 90 |
| place_bread_skillet | 62% | 96% | -34 | 100 |
| place_shoe | 66% | 99% | -33 | 90 |
| pick_dual_bottles | 67% | 100% | -33 | 90 |
| place_phone_stand | 50% | 80% | -30 | 50 |
| adjust_bottle | 69% | 99% | -30 | 100 |
| dump_bin_bigbin | 69% | 96% | -27 | 100 |
| place_empty_cup | 72% | 99% | -27 | 90 |
| place_container_plate | 76% | 100% | -24 | 100 |
| beat_block_hammer | 75% | 96% | -21 | 100 |
| grab_roller | 84% | 100% | -16 | 100 |
| press_stapler | 76% | 90% | -14 | 90 |
| shake_bottle | 86% | 99% | -13 | 100 |
| click_bell | 92% | 100% | -8 | 100 |
| click_alarmclock | 98% | 99% | -1 | 100 |
| shake_bottle_horizontally | 93% | — | — | 100 |
2 open-loop 정밀도 — 갭의 물리량
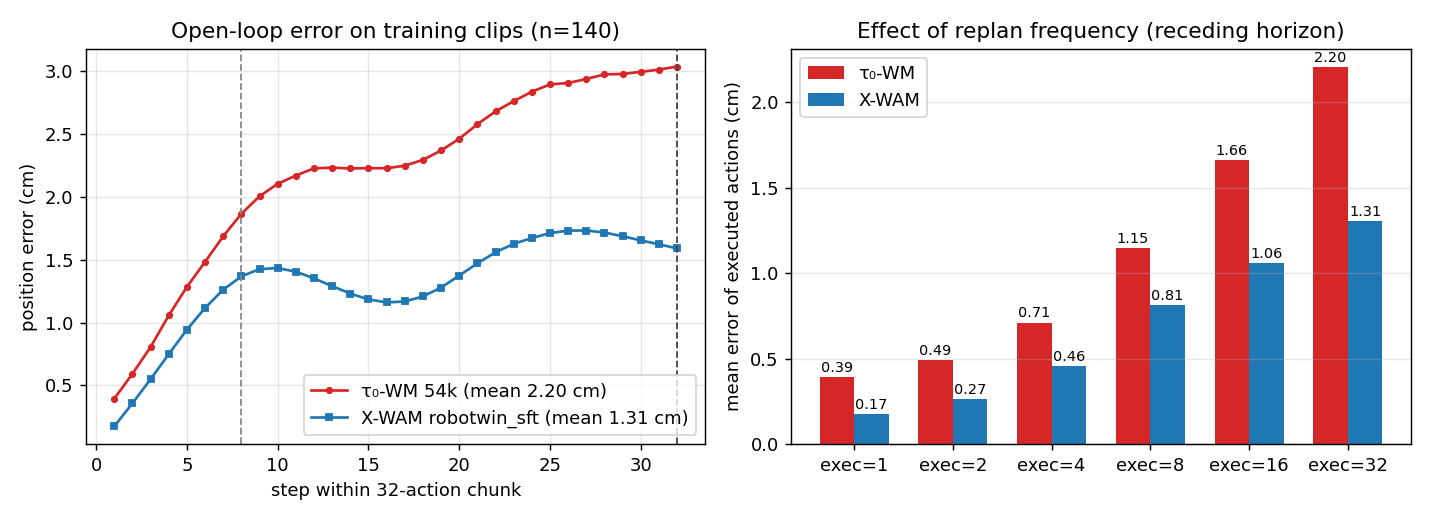
학습 클립 140개에 대해 두 모델에 같은 관측을 주고 32-step chunk를 예측시켜 GT와 비교. 이 클립들은 τ₀에겐 학습 데이터, X-WAM에겐 미학습 에피소드(자체 재생성 seed 사용, 첫 프레임 픽셀 diff 17~42로 확인) — τ₀에게 유리한 조건이다.
기각된 가설: receding horizon
τ₀ 논문은 receding-horizon 실행이 기본이고 오차 곡선상 exec=8이면 실행 오차가 2.20→1.15 cm로 줄어 유리해 보였다. 실제 A/B는 SR 37% → 12%로 악화. 성공 에피소드가 2배 느려지고 나머지는 타임아웃이었다. 원인은 RoboTwin의 take_action('ee')가 매 스텝 모션 플래너를 호출하고 실패 시 조용히 정지하기 때문(재계획 4배 → 실패 기회 4배). exec=32가 τ₀에게도 최선이다.
3 비디오 브랜치 — 시각 표현은 전이됐다
"video branch가 SAPIEN 렌더에 OOD라 action이 망가진 conditioning 위에서 학습됐다"는 가설을 직접 디코딩해 검증. 고정 20 클립에서 조건 프레임 1장을 주고 32 env step(≈1.3초) 앞을 생성.
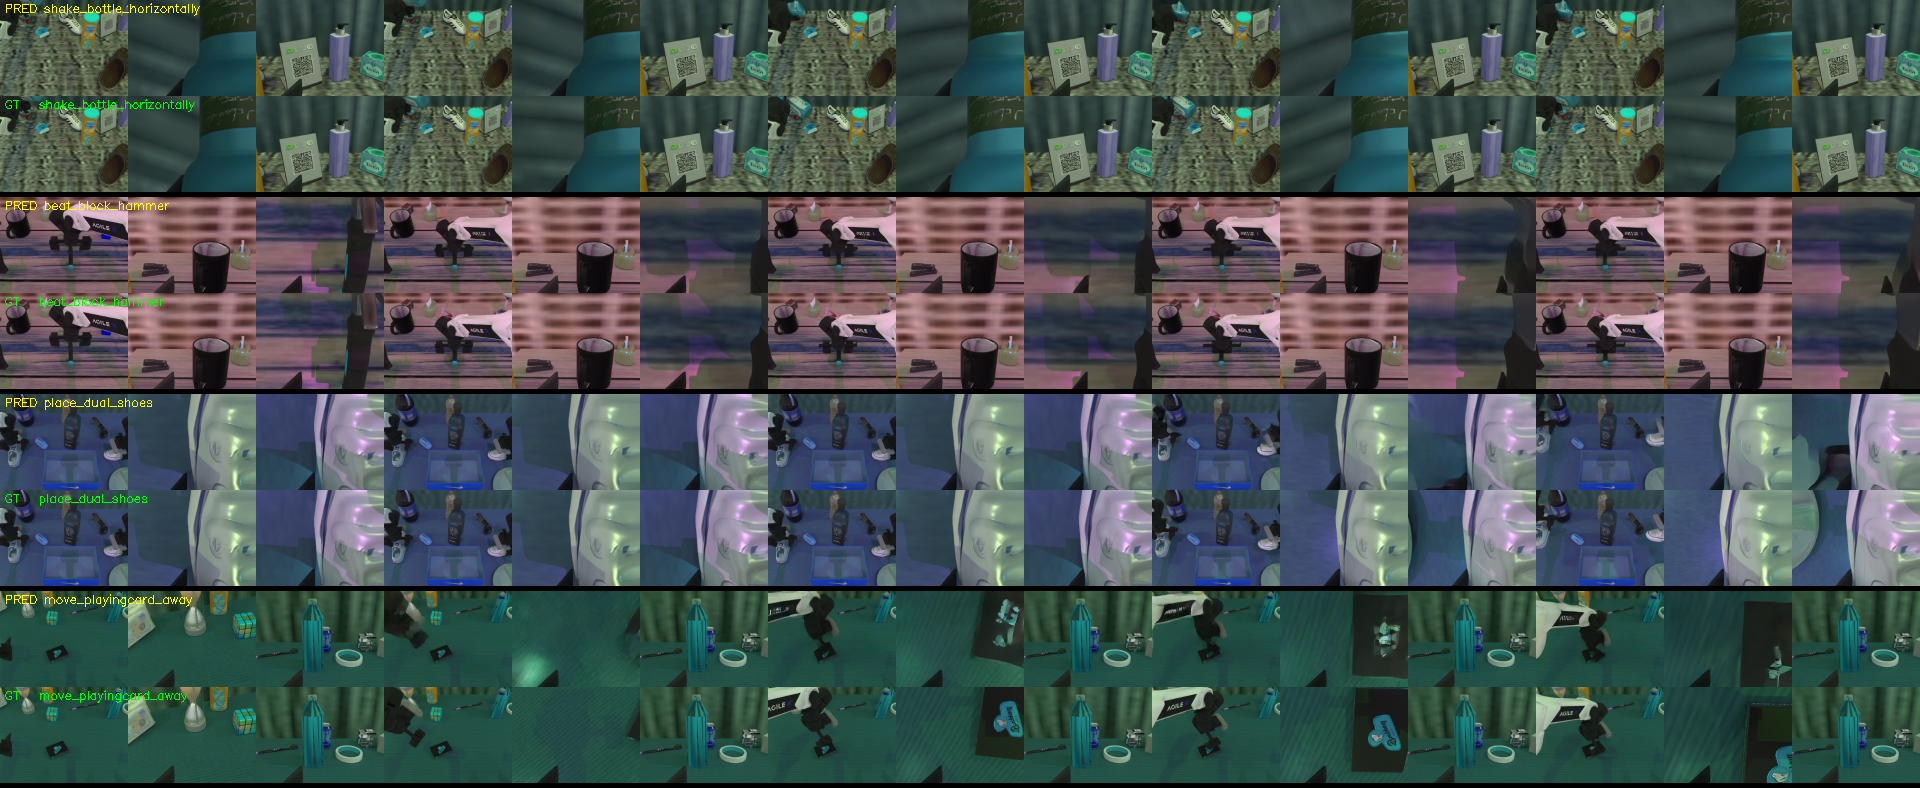
| ckpt | 전체 PSNR | SSIM | f0(조건) | f1 | f4 | f8 |
|---|---|---|---|---|---|---|
| run1 step_54000 | 25.20 dB | 0.861 | 37.0 | 26.8 | 23.9 | 22.4 |
| run2 step_15000 (batch384+cosine) | 24.07 dB | 0.843 | 36.8 | 25.4 | 22.8 | 21.1 |
loss_video×1.0 + loss_action×1.0인데 실측이 video ~0.11 vs action ~0.03 → 그래디언트를 비디오가 3~4배 지배한다. 개선 방향은 video weight를 올리는 게 아니라 action_loss_scale을 올리는 쪽.4 RCS — 후보를 뽑고 고르기
TTC 1단계. 후보 액션 8개를 샘플링하고 re-denoising consistency 점수로 최선을 고른다(시뮬레이터 불필요). 클립 20개에서 후보별 실제 오차를 재고 RCS의 선택과 비교했다.
5 ACVS 시뮬레이터 — 후보를 굴려보고 고르기
TTC 2단계. 공개된 ACVS 가중치(11.9 GB)로 후보 8개를 각각 롤아웃해 dense task-progress 보상을 받고, 그 순위가 실제 정확도를 맞히는지 확인했다.
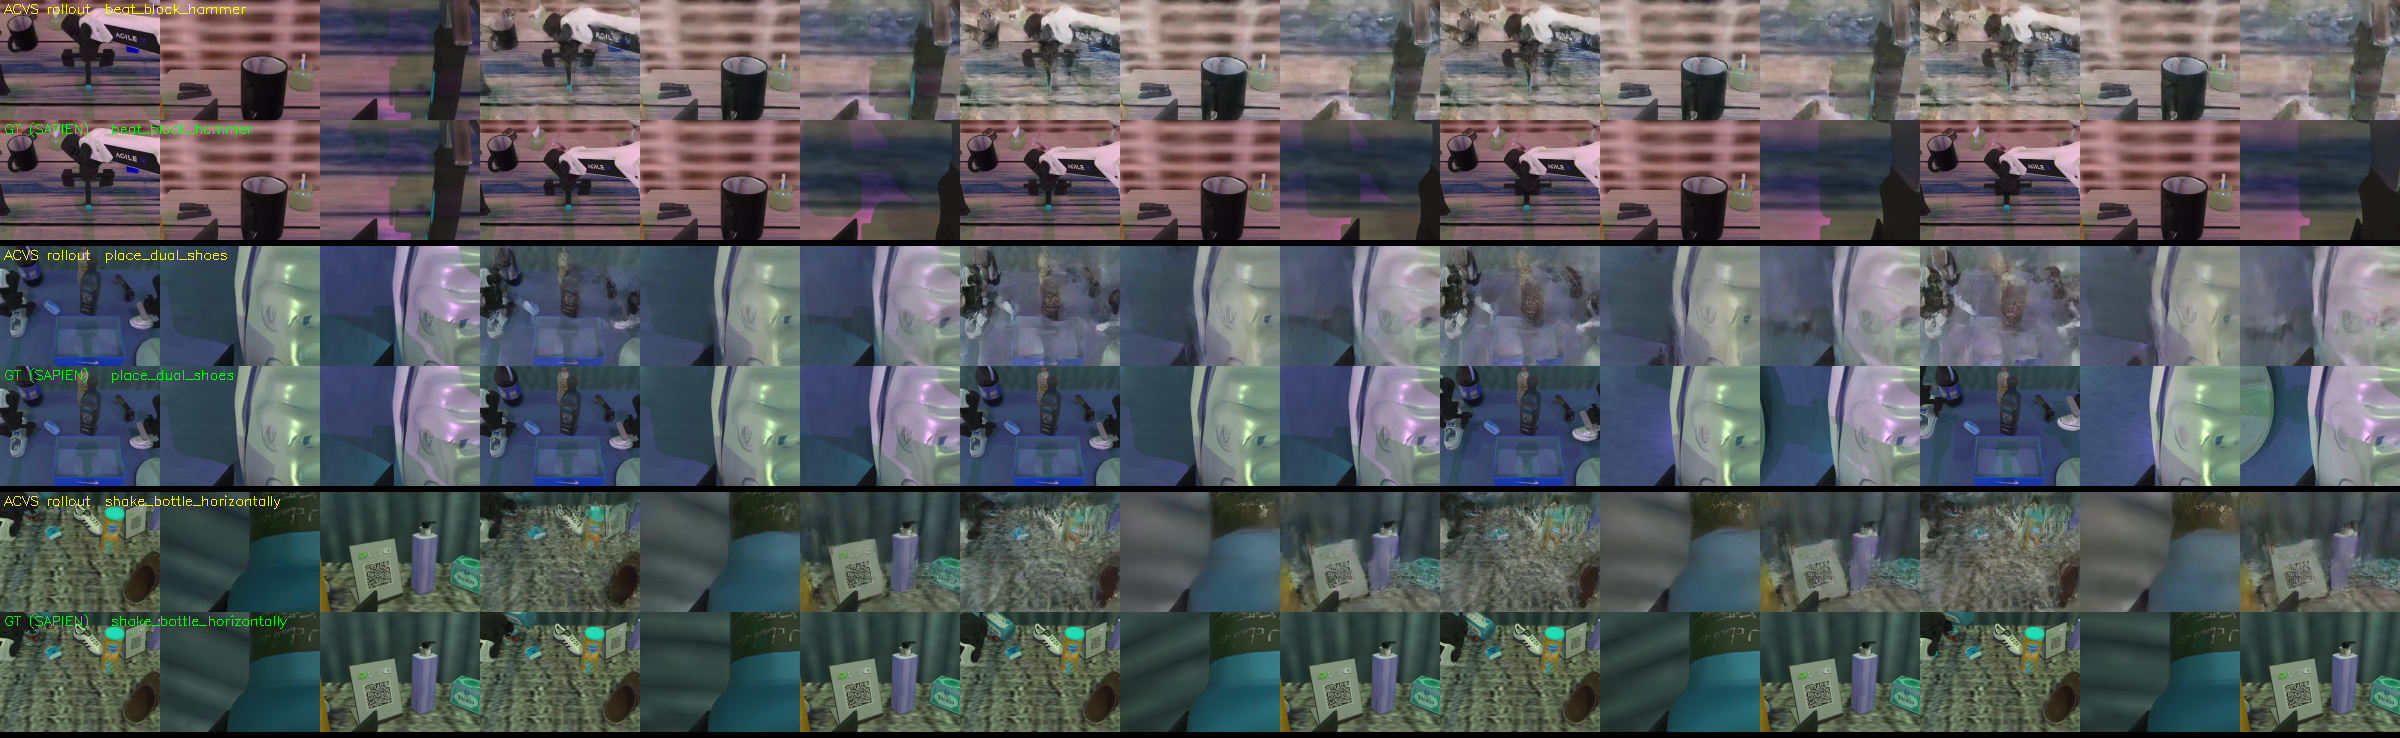
| 선택 방식 | 오차 (12 클립) | 순위 상관 | 판정 |
|---|---|---|---|
| 랜덤 | 1.32 cm | — | 기준 |
| RCS | 1.26 cm | +0.00 | 약한 이득 |
| ACVS 보상 | 1.34 cm | −0.14 | 못 씀 |
| 오라클 | 0.84 cm | — | 상한 |
runner/posttrain_sim.py로 ~17h면 학습 가능.6 종합 — 어디가 문제였나
제거한 버그·결함
| # | 내용 | 영향 |
|---|---|---|
| 1 | 브릿지가 절대 pose 반환 (shim은 delta 기대) | SR ~1% |
| 2 | 데이터 로더 R/B 채널 중복 변환 | 영향 작음 |
| 3 | OIDN 디노이저가 B200 미지원 → 노이즈 렌더가 정책 입력 | 전 평가 무효화 |
| 4 | TauPolicy 영상 저장 경로 datetime 미import | 비디오 브랜치 실행 불가 |
| 5 | 시뮬레이터 파이프라인 no-memory 경로 mem_z 미초기화 | ACVS 실행 불가 |
| + | TTC 함정 3종: 전용 파이프라인 미지정 / TauPolicyTTC의 fused-qkv 기본값 반대 → 361 텐서 조용히 미로드 / 시뮬레이터 config 불일치 | 조용히 틀린 결과 |
기각된 가설
| 가설 | 검증 | 결과 |
|---|---|---|
| 평가 하네스/인터페이스 버그 | X-WAM 공개 ckpt를 같은 하네스로 | 82.1% 재현 → 무결 |
| video branch가 sim에 OOD | 예측 영상 디코딩·PSNR | 25.2 dB → 기각 |
| receding horizon 부재 | exec 32 → 8 A/B | 37% → 12% 악화 |
| 하이퍼파라미터 (batch/스케줄) | batch 384 + cosine 재학습 | 2.26 → 2.63 cm 악화 |
| embodiment adapter / 그리퍼 스케일 | 왕복 변환 수치 검증 | 오차 0 → 정상 |
| normalization stats 재사용 | RoboTwin 전용 통계 재계산 확인 | 정상 |
| 학습 데이터 미적합(일반화 실패) | 학습 seed로 재평가 | 34.8% → 학습 씬에서도 실패 |
결론과 다음 단계
τ₀-WM의 RoboTwin 성능은 생성이 아니라 선택에서 잃는다. 모델은 X-WAM보다 정확한 액션을 이미 만들 수 있지만(오라클 0.94 cm) 그것을 식별하지 못하고, τ₀가 그 용도로 설계한 ACVS는 sim 도메인에 적응돼 있지 않다. 우선순위:
- ACVS를 RoboTwin에 posttrain (~17h) → sim_refine 재측정. 오라클과의 격차 1.26→0.84(−33%)가 목표이고, 달성 시 X-WAM 수준을 넘어선다.
action_loss_scale상향 재학습 — 현재 그래디언트를 비디오가 3~4배 지배.- held-out split 구성 — 현재
val이train과 동일해 일반화 측정 자체가 불가능하다.
baseline 평가는 386/500 unit 진행 중이며 완료 시 이 페이지의 수치가 갱신된다.