2026-09-24 · scene_bench · 온라인 하네스 화면 감사
온라인 VLM이 받는 화면 vs 컨텍스트(기억) 프레임 — 실물 대조
사용자 질문 "context 때 화면이랑 좀 다른 것 같다" → 같은 편의 데이터셋 exo_camera_1 프레임과 온라인 하네스가 실제로 VLM 프롬프트에 넣는 이미지를 1:1 픽셀 배율로 나란히 놓고, 카메라 intrinsics·마운트를 traj.h5 실측으로 대조
TL;DR
같음
마운트 [-0.40, 0.24, 1.55] · fov_y 70°
640×480 → 320×181
기억 프레임 vs 현재 뷰 exo 반쪽
5.3×
픽셀 수 감소 (세로 2.65×)
86° → 102°
수평 FOV (4:3 → 16:9)
다름
그림자 렌더 (데이터셋 hard shadow / 온라인 없음)
- 카메라 자체는 같은 곳에 있다. 데이터셋 exo_camera_1 은 베이스 기준 오프셋
[-0.40, 0.24, 1.55](17,838 프레임 내내 상수, 베이스 고정), fov_y 70.0°. 온라인bench_exo_L은 fr3_link0 기준[-0.40, 0.24, 0.965](링크 높이 더하면 1.55) · fov 70 · 쿼터니언 성분 {0.5375, 0.2858, 0.3725, 0.7005} 동일 — Task N10에서 데이터셋 샘플로 실측 보정한 값이 맞다. - 다른 것은 렌더 해상도·비율과 프롬프트에 넣는 크기. 기억(읽기 트랙·시드) 프레임은 데이터셋 영상 640×480(4:3). 온라인 exo 렌더는 624×352(16:9)라 같은 fov_y 70° 에서 수평 FOV 가 86°→102° 로 넓어져 물체가 더 작게 보이고, VLM 프롬프트의 "현재 뷰"는 exo‖wrist 를 640 폭 한 장으로 합친 타일(반쪽 320×181, JPEG 85)이다 — 사용자 결정 260918 "1번은 너무 큼 반쪽으로 줄이자"(토큰 과금). 기억 프레임 대비 픽셀 5.3배 적고 세로 해상도 480→181.
- 그림자/조명이 다르다. 데이터셋 프레임은 오프라인 렌더러(
randomize_shadows, hard shadow)로 찍혀 바닥 그림자가 진하고, 온라인은env.render_rgb_frame라이브 렌더라 그림자가 거의 없다. 이미지 매칭(vis-pure·tagmem·frames)에는 도메인 차이로 작용한다. - writer(온라인에서 새로 기억하는 프레임)는 exo 원본 624×352 를 받는다 — 시드 없는 오라클 실험 안에서는 일관되지만, 시드가 있는 실험 2 에서는 한 장부에 640×480(데이터셋)과 624×352(온라인)가 섞인다.
1실물 대조 — restore 편 train_1299__2 (1:1 픽셀 배율)
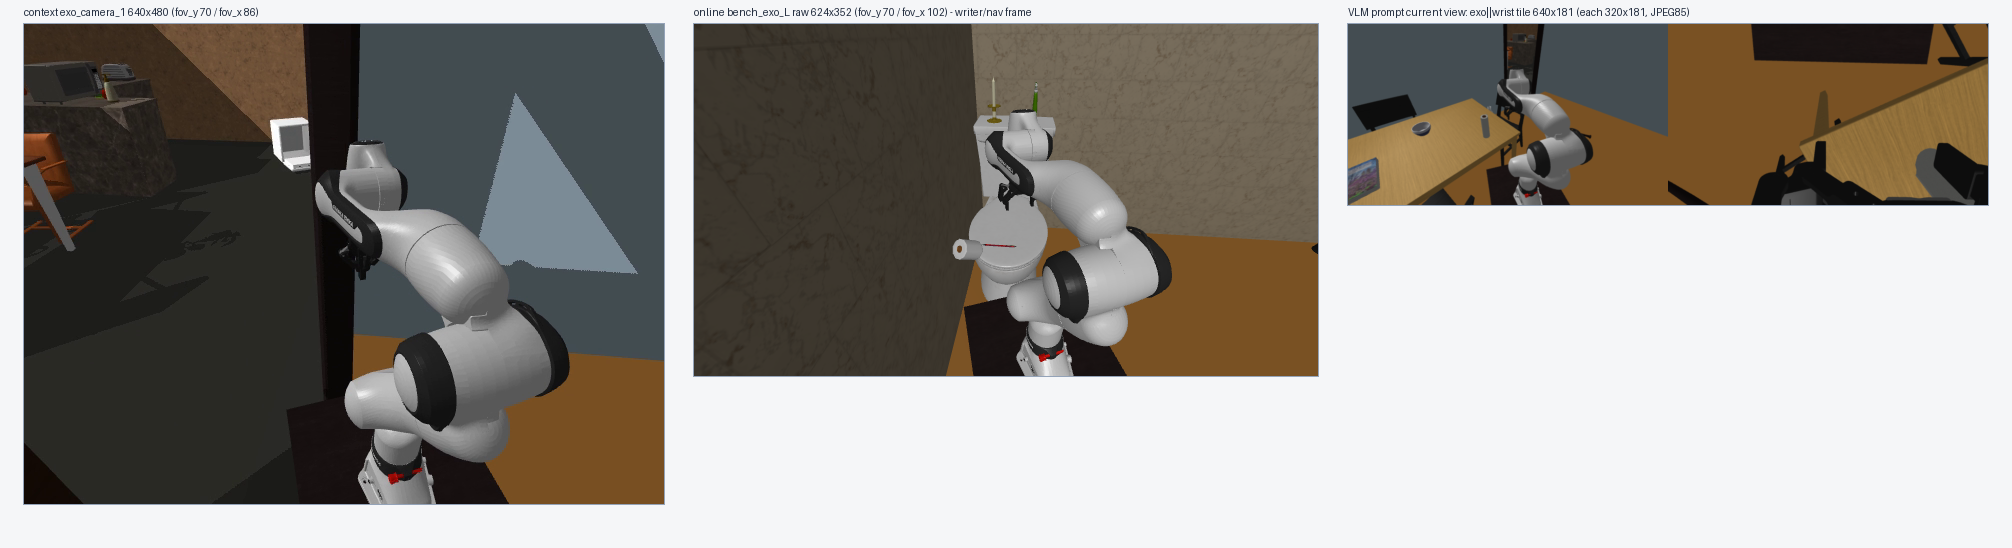
왼쪽: 컨텍스트 exo_camera_1 640×480(기억 프레임) · 가운데: 온라인 bench_exo_L 원본 624×352(writer·nav 프레임) · 오른쪽: VLM 프롬프트의 현재 뷰 타일 640×181(exo‖wrist). 세 장 모두 실제 픽셀 크기 — VLM 이 결정 때 받는 exo 는 오른쪽 타일의 왼쪽 반쪽(320×181)이다.

손목: 컨텍스트 wrist_camera 640×480(fov_y 56.7°) · 온라인 wrist_camera_zed_mini 624×352(fov 52°±4 노이즈) · 타일 손목 반쪽 320×181.
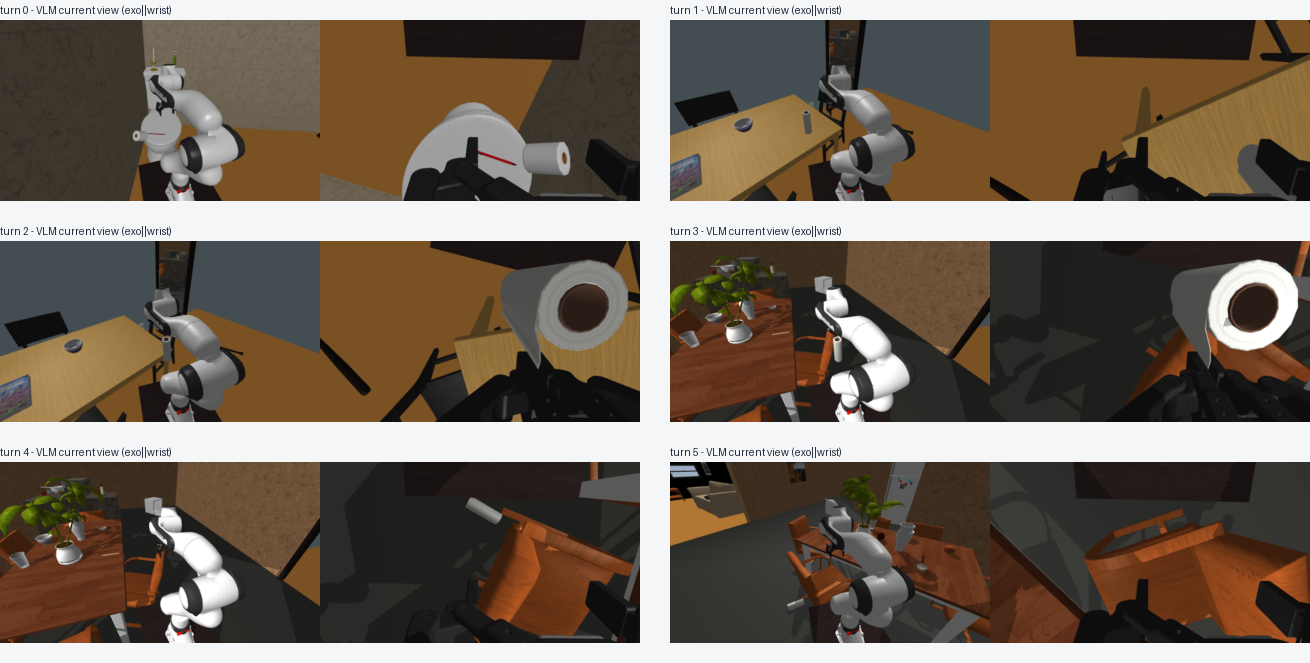
같은 편 온라인 턴 0~5 의 VLM 현재 뷰(타일) 시퀀스. 여기에 직전 서브골 실행 중 캡처 최대 3장(조작 중 exo‖wrist, 주행 중 exo 만)이 앞에 붙어 obs 예산 4장을 채운다.
2routine 편 train_1128__7922 (type3, 원격 스모크)
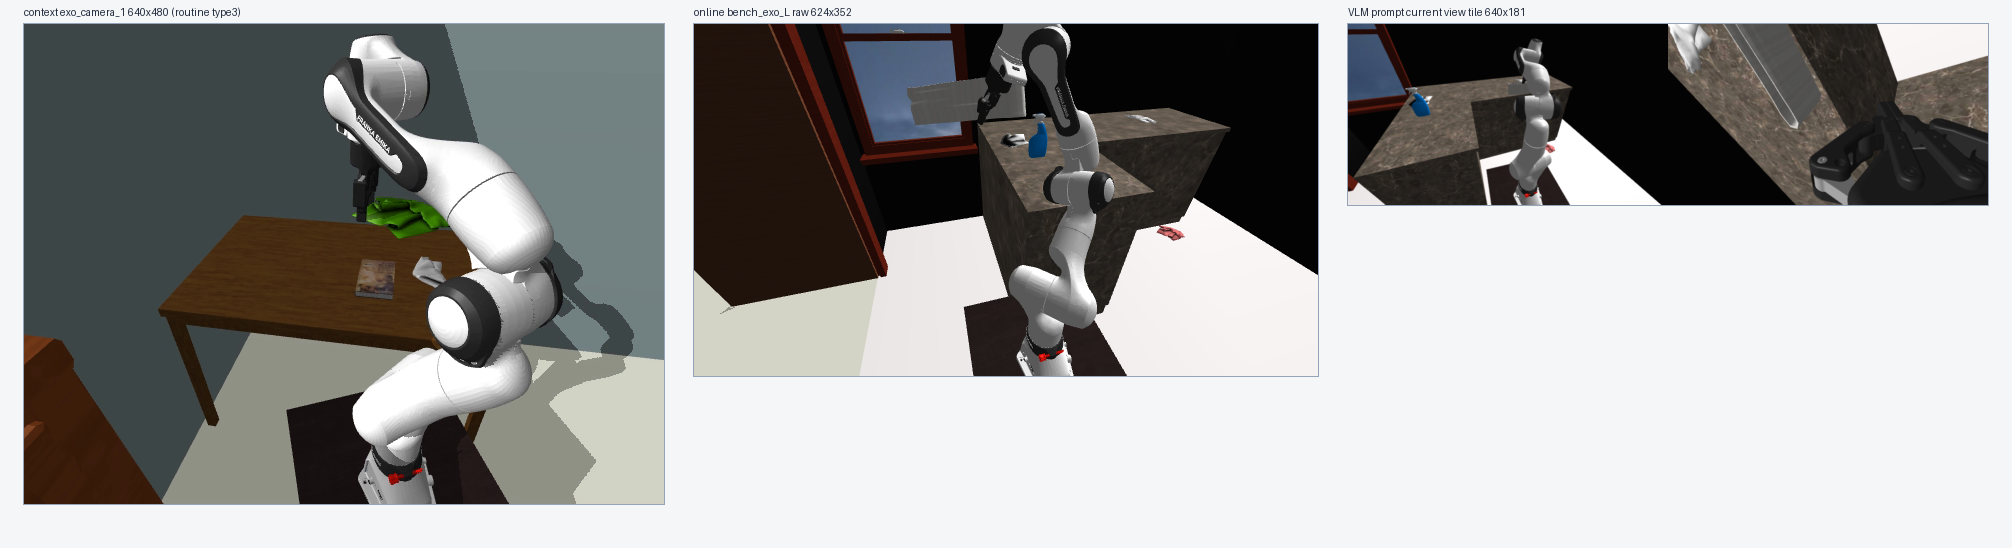
같은 구성. routine 컨텍스트도 640×480 4:3, 온라인은 624×352 → 타일.
3수치 대조 (traj.h5 obs/sensor_param 실측 · 코드 상수)
| 항목 | 컨텍스트(기억) exo_camera_1 | 온라인 bench_exo_L | VLM 프롬프트 현재 뷰 |
|---|---|---|---|
| 해상도 · 비율 | 640×480 · 4:3 | 624×352 · 16:9 | exo‖wrist 타일 640×181, exo 반쪽 320×181 · JPEG q85 |
| fov_y / fov_x | 70.0° / 86.1° (fx=fy=342.8) | 70° / 102.3° (fovy 70 을 16:9 에 적용) | 동일(축소만) |
| 마운트 | 베이스 기준 [-0.40, 0.24, 1.55], 프레임 내내 상수 | fr3_link0 기준 [-0.40, 0.24, 0.965] (+링크 높이 ≈ 1.55) · 쿼터니언 성분 동일 | — |
| 렌더 | 오프라인 렌더러, hard shadow(rerender 파이프라인, source_run T20260826) | 라이브 env.render_rgb_frame, 그림자 거의 없음 | — |
| 손목 | 640×480, fov_y 56.7° | 624×352, fov 52°±4 | 반쪽 320×181 |
| writer(온라인 기억) 입력 | — | exo 원본 624×352 (writer_frame) | — |
src/sbench_online/exp_matrix.py BENCH_EXO_L_PARAMS: reference fr3_link0 · offset [-0.40, 0.24, 0.965] · quat [0.5375, 0.2858, -0.3725, -0.7005] · fov 70
src/sbench_online/orchestrator.py TILE_WIDTH=640; exo_wrist_tile(): 각 반쪽 320 폭으로 축소 후 가로 합성 (사용자 결정 260918)
src/sbench_online/unified_turn.py parts = prev_frames(≤3, image_part) + image_part(ctx.exo=타일) [+ wrist(unified 모드만)]
src/sbench_online/vlm_client.py image_part(): JPEG quality=85, 리사이즈 없음
데이터셋 traj.h5 obs/sensor_param/exo_camera_1/intrinsic_cv[0] = [[342.8,0,320],[0,342.8,240],[0,0,1]] · cam2world 위치 − robot_base_pose → [-0.40, 0.24, 1.55]
4Takeaway · 선택지(결정은 사용자)
- "화면이 다르다"는 느낌의 실체는 시점이 아니라 해상도·비율·그림자다. 시점(마운트·수직 FOV)은 데이터셋과 맞춰져 있다.
- 영향은 5 arm 공통이라 순위를 바꾸는 요인은 아니지만, 기억 프레임(640×480, 그림자 있음)과 현재 뷰(320×181, 그림자 없음)를 대조해야 하는 이미지 전략(frames·vis-pure·tagmem)에는 불리한 방향의 도메인 차이다. 텍스트 전략(blind·rf-v3)은 영향이 작다.
- 선택지: (a) 그대로 두고 논문에 "현재 뷰는 640×181 타일" 로 명시 (b) bench_exo_L 렌더를 640×480 으로 바꿔 intrinsics 를 데이터셋과 일치(수평 FOV 86°) — 실행 중 캠페인엔 적용 불가, 새 캠페인부터 (c) 타일 폭 640→1280(반쪽 640) 복원 — 토큰 ≈2배 (d) 온라인 렌더에 그림자 켜기 — 렌더러 경로 확인 필요. 어느 쪽이든 돌고 있는 오라클·resume·routine 캠페인 안에서는 바꾸지 않는다(한 표 안 조건 혼합 금지).
기록
이미지·수치 원본 tmp/vlm_view_check/ · 로그 claude/260924/analysis-online_vlm_view_vs_context.md. 이 감사는 API $0.