2026-09-24 — Analysis
goal 이미지가 왜 못하나 — 학습 goal 과 기억 프레임은 다른 물건이고, goal 은 물체를 원위치에서 멀어지게 한다
scene_bench | A/B v2(102칸) 에피소드 로그·기억 traj.h5·MolmoBot 학습 코드 재분석, 추가 비용 $0
TL;DR
- 학습 goal = 같은 exo 카메라로 본 같은 에피소드의 마지막 프레임(
synthmanip_dataset.py:376, p=.667). 현재 관측과 카메라가 0 m·0° 로 같고, "방금 이 물체를 놓은 장면"이다. - 기억 프레임은 세 축 모두 분포 밖: 카메라(어깨 캠, 원위치까지 1.28 m·8° / observed 1.69 m·22°), 시점(과제 전), 팔 상태(observed 15장 중 7장이 다른 물체를 쥔 팔).
- 결과: preplace 는 두 팔이 같은 곳(원위치 0.16~0.21 m)에 놓는데, goal 이 있으면 EEF 가 더 돌아다니고(acted 수평 0.36 vs 0.11 m) 물체가 원위치에서 더 먼 곳에 놓인다(0.35/0.31 vs 0.25/0.23 m; observed ≤15 cm 1 vs 6).
- 손해가 성공률로 드러나는지는 표면 여유가 가른다: acted 조리대 7/8 은 흡수, observed 식탁 1/5(off 4/4)·안락의자·싱크는 낙하·미방출.
- 대조군(260918 프로브): 정책 카메라 렌더 goal 은 0.22 vs off 0.33 m 였지만 ⚠ 정정: 이 프로브의 정책은 π0.5 goal 모델이라 MolmoBot 근거가 아니다 — MolmoBot place 전용 프로브를 따로 돈다.
0 m·0°
학습 goal↔관측 카메라
1.69 m·22°
observed 기억 goal
3.3×
EEF 수평 이동(acted)
1 / 6
observed ≤15 cm on/off
1배경/목적
A/B v2 에서 goal-on 25 vs off 26(p=1.0), observed 6 vs 13. 사용자 요청: goal 이 왜 못하는지 꼼꼼히. 기존 행·에피소드 로그(qpos.npz·episode.json)·기억 traj.h5·학습 코드로만 가린다.
2학습 goal vs 기억 프레임
# MolmoBot olmo/data/synthmanip_dataset.py
# goal 이미지: 에피소드 마지막 프레임(같은 exo 카메라). 존재 확률로 드롭 → 드롭 시 goal 없이 학습.
use_goal = bool(self.config.goal_image) and (rng.random() < self.config.goal_presence_prob) # 0.667
extra_frame_indices = ... + [-1]
# ckpt 실행 인자: --goal_image --goal_presence_prob=0.667 --camera_preset franka_one_random_then_wrist
| 축 | 학습 goal | 기억 프레임 goal (acted 24 / observed 15) |
|---|---|---|
| 카메라 | 현재 관측과 동일(무작위 zed2, 작업 중심 0.2~0.8 m) | 어깨 캠 — 원위치까지 1.28 m·8° / 1.69 m·22° |
| 시점 | 과제가 끝난 뒤 | 과제 전(원위치 구간 73% / 53% 지점) |
| 팔 상태 | 방금 이 물체를 놓은 팔(옆, 빈손) | 목표에서 0.35 m / 0.92 m; observed 7/15 다른 물체를 쥠 |
| 해상도 | 관측과 같은 종횡비 | 640×480 vs 관측 624×352 |
goal 없는 샘플도 1/3 학습했으므로 off 팔은 학습 분포 안, on 팔은 세 축 모두 밖이다.
3goal 은 물체를 목표로 끌지 않고 팔을 더 돌아다니게 한다
첫 place 시도 기준. Panda DH FK 로 EEF 궤적을 계산했다(방출 시점까지).
| acted on | acted off | observed on | observed off | |
|---|---|---|---|---|
| preplace → 원위치 수평 | 0.166 m | 0.160 m | 0.213 m | 0.214 m |
| EEF 최대 수평 이동 | 0.36 m | 0.11 m | 0.14 m | 0.085 m |
| 관절 경로 | 4.97 rad | 3.11 | 4.24 | 1.56 |
| 방출 스텝 중앙값 (방출 수) | 65.5 (16/26) | 58 (17/19) | 50 (12/16) | 20 (11/16) |
| 최종 물체 → 원위치 수평 | 0.352 m | 0.246 m | 0.312 m | 0.232 m |
| ≤15 cm / ≤30 cm | 3 / 9 | 4 / 14 | 1 / 8 | 6 / 9 |
| 바닥 낙하 | 0 | 3 | 4 | 1 |
둘 다 도달한 쌍(각 13): acted 는 on 의 EEF 수평 이동이 11/13 쌍에서 크다(+0.107 m), observed 는 방출이 7/13 쌍에서 늦다(+7 스텝).
preplace 가 이미 원위치 근처인데 goal 이 있으면 물체가 거기서 ~10 cm 더 먼 곳에 놓인다. 분포 밖 goal 은 공간 정보가 아니라 잡음이다.
4acted 는 버티고 observed 는 무너진다 — 표면 여유
| 표면 | acted on / off 성공 | observed on / off 성공 |
|---|---|---|
| 조리대 | 7/8 · 3/4 | 1/3 · 3/5 |
| 식탁 | 3/6 · 3/4 | 1/5 · 4/4 |
| 안락의자 / 싱크 | 0/1·1/1 / 1/1·1/1 | 0/1(낙하)·1/1 / 0/1(낙하)·0/1 |
넓은 조리대는 0.36 m 이동을 흡수하지만, observed 물체는 식탁 가장자리·의자처럼 여유 없는 자리가 많고 goal 도 더 분포 밖이다. acted 헤드라인 우세(19 vs 13)는 place 도달 수(26 vs 19) 차이이고 둘 다 도달한 칸은 9 vs 8.
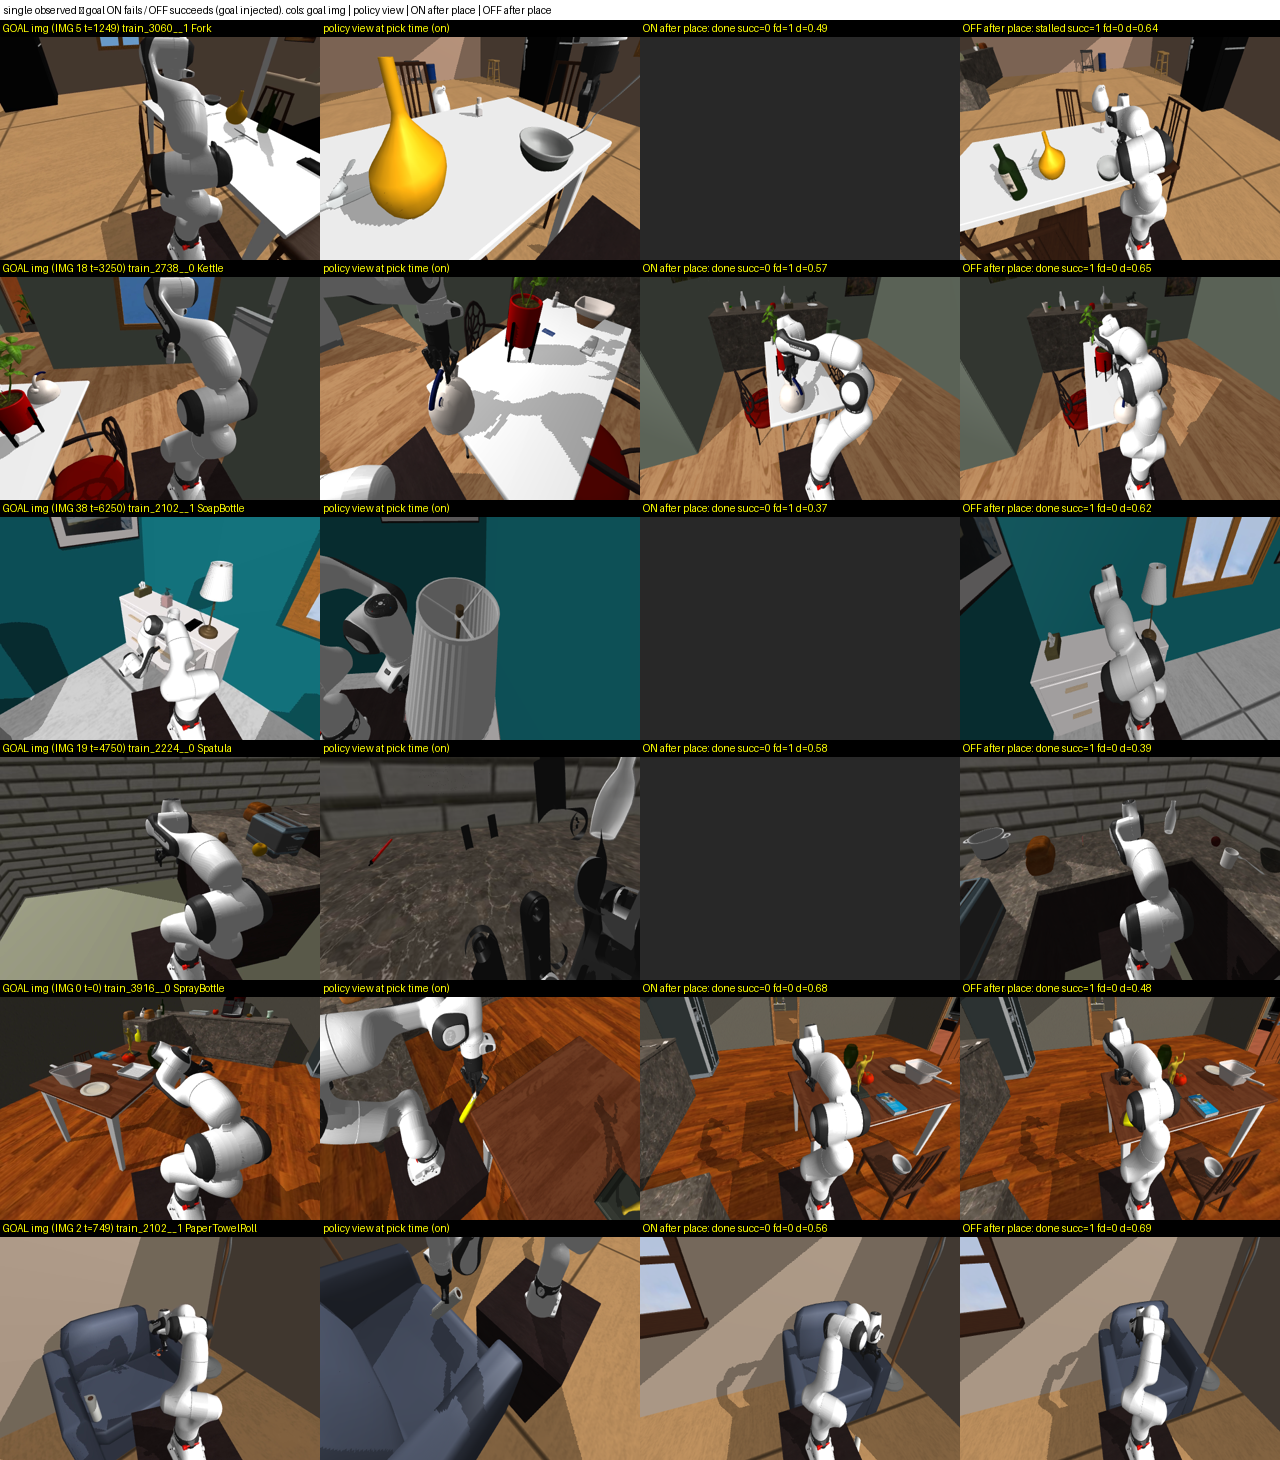
observed 실패 6칸: goal 이미지(어깨 캠, 멀고 비스듬, 팔이 다른 일 중) | 정책 화면 | on 놓은 뒤(검은 칸 = 안 놓음) | off 놓은 뒤.
5대조군 — 학습 분포 goal 은 방향이 맞았다
| 260918 프로브 런 2+3 (같은 40칸, 든 채 도착) | render(정책 카메라) | 기억 프레임 | off |
|---|---|---|---|
| 정답 가구 위 | 13/22 | 9/16 | 10/24 |
| 원래 자리 거리 중앙값(런 3) | 0.22 m | 0.30 m | 0.33 m |
| @15 cm | 4 | 1 | 1 |
정정: 이 표의 정책은 π0.5
pi05_goal_v2 다(A/B v2 의 MolmoBot 아님). MolmoBot 에 대한 대조 근거가 아니며, render vs off 쌍 비교도 런 3에서 재현 안 됨(n=7, p=.11).6원인이 아닌 것
| 후보 | 결과 |
|---|---|
| goal 이 정책에 안 갔다 | on place 44회 중 41회 전달(3회 NONE) |
| 색 순서·형식 | imageio RGB, set_goal_image HWC uint8 assert — 정상 |
| pick 단계 차이 | goal 은 place 에만 — pick 은 동일 코드, 도달 차이는 잡음 |
| 주전자 0 스텝 실패 | 정책이 한 스텝도 안 움직임 — goal 이 작용할 틈 없음 |
| goal 프레임 속 팔 상태·기하가 개별 실패를 가름 | kind 안에서 구별 안 됨(다른 물체 쥔 7장 성공 2 vs 빈손 8장 성공 3) |
7Takeaway
결론
원인은 하나로 모인다 — 기억 프레임은 이 ckpt 가 배운 goal 이 아니다. 학습 goal 은 같은 카메라·과제 종료 후·방금 놓은 팔이고, 기억 프레임은 셋 다 어긋난다. 분포 밖 goal 은 팔을 더 움직이게 하고, 늦게 놓게 하고, 물체를 원위치에서 멀리 둔다. 프레임 고르기로는 못 고친다 — 필요한 것(원위치에 놓인 뒤의 장면을 현재 카메라로)은 기억에 없다. 채택 안 함·goal-off 본표 결론은 그대로.8보완점 / 다음
- 로깅 공백: place 시점 정책 카메라 자세 미기록 → "goal 속 물체 화면 위치 쪽으로 옮긴다"는 방향 가설 미검증.
- 선택($0 GPU): 오라클 파지 + place 만, 같은 칸 render / 기억 프레임 / off 로 대조군을 쌍으로 재확인.
- 산출:
claude/260924/analysis-goal_underperformance.md,tmp/goal_gt/why_goal_v2.py,why_goal_feat.json,place_geom_v2.json.