2026-09-23 — Experiment
goal 이미지 A/B v2 완주 — 같은 ckpt·최신 하네스에서 goal 은 동률, observed 칸에선 해롭다
scene_bench | restore single 102칸 × goal-on/off, MolmoBot place_oc_goal@10000, tagmem-r3 검색 시드, 지목 = VLM vlmpick
TL;DR
- 채택 안 함. 102쌍 on 25 vs off 26(on만 13·off만 14, McNemar p=1.000). 260920 결정 그대로
tagmem goal-off가 본표, goal-on 은 절제 행. - acted 19 vs 13(p=.21)은 goal 의 공이 아니다 — goal 은 place 에만 들어가므로 pick 단계는 두 팔이 동일한데, on 팔이 우연히 place 에 더 많이 도달했다(26 vs 19). 둘 다 도달한 13칸은 9 vs 8.
- observed 6 vs 13(p=.065)은 goal 의 손실이다 — 도달 16 vs 16 인데 goal 을 주면 정책이 128 스텝을 다 쓰고 안 놓거나(4 vs 1), 바닥에 떨어뜨린다(4 vs 1). 첫 place 스텝 82 vs 36.5.
- 원인은 시점 분포: 지목 프레임이 observed 에선 1.69 m·22°(acted 1.28 m·8°) — 학습 goal 카메라(0.2~0.8 m)와 격차. 같은 kind 안에서 성공/실패의 기하 차이는 없어 프레임 고르기로 못 메움.
- ckpt 를 맞추니 옛 런의 격차(23 vs 17)는 사라졌다 — 그 절반은 ckpt 차이였다. GT 쪽 goal-on 측정은 불필요.
25 / 26
성공 on / off (102쌍)
p=1.00
McNemar 전체
6 / 13
observed on / off
82 / 36.5
observed place 스텝 중앙값
$57.7
API (칸당 $0.28)
28.5 h
own 2→4샤드 + extra
1배경/목적
첫 A/B(260919~20, 107칸: off 23 vs on 17)는 두 팔의 체크포인트가 달랐고(off=place_oc, on=place_oc_goal) 스냅샷이 낡아 tagmem 온라인 시드가 엔트리 전량 평문 덤프였다(최신은 260919 부터 질의 태그 검색). 사용자 결정 "다시 재보자": 최신 하네스에서 두 팔 모두 molmobot_place_oc_goal@10000, 차이는 --goal-image vlmpick|off 하나뿐으로 재측정. 목표는 "single acted/observed 를 goal 조건으로 본표, goal-off 를 절제"라는 그림의 근거를 얻는 것.
| 항목 | 값 |
|---|---|
| 칸 | 102 single(acted restore_target 68 + observed restore_distractor 34) = 읽기 답이 방+가구까지 맞은 tagmem-r3 107칸 − 다물체 5 |
| 계획·정책 | --plan read(flash-3.7 읽기 답) · MolmoBot place_oc_goal@10000 · PLACE_MODE=vla |
| goal | on = tagmem 검색 8장 + 현재 정책 화면 + 시점 힌트 → VLM 지목(NONE 이면 goal 없이) · off |
| 하네스 | tmp/goal_gt/src_v2(= oracle_plan/src_main4), --max-episodes 6, --obs-images 4 --image-cap 8 |
| 운영 | 260922 16:24 → 260923 20:52. own 2샤드/팔 → 03:27 부터 4샤드/팔 + extra 병용(사용자 결정). 잡 21 COMPLETED · 3 PREEMPTED(자동 재제출) · 4 재샤딩 취소 |
| 비용 | on $27.52 + off $29.77 + 지목 44회 $0.43 = $57.7 |
2결과 — 헤드라인 (102쌍)
| goal-on | goal-off | 쌍 비교 | |
|---|---|---|---|
| 전체 성공 | 25/102 (24.5%) | 26/102 (25.5%) | on만 13 · off만 14 → p=1.000 |
| single acted (68) | 19 (27.9%) | 13 (19.1%) | on만 11 · off만 5 → p=.210 |
| single observed (34) | 6 (17.6%) | 13 (38.2%) | on만 2 · off만 9 → p=.065 |
| min_d_gt 중앙값 | 0.56 m | 0.57 m | Wilcoxon p=.47 · ≤15 cm 0 / 0 |
| 첫 행동 적중 / false_done / 바닥 낙하 | 89 / 22 / 17 | 85 / 18 / 20 | |
| 턴 중앙값 | 12 | 17 |
acted 와 observed 가 반대 방향이다. 아래에서 place 도달을 통제하면 acted 의 우세는 사라지고 observed 의 열세만 남는다.
3goal 이 실제로 쓰인 칸 — place 도달을 통제하면
지목은 VLA place 직전에만 호출된다. pick 단계는 두 팔이 바이트 동일하므로 "place 에 도달했는가"는 goal 과 무관한 런 잡음이다.
| acted | observed | |
|---|---|---|
| place 도달 on / off | 26/68 / 19/68 | 16/34 / 16/34 |
| 도달 시 성공 on / off | 17/26 (65%) / 11/19 (58%) | 6/16 (38%) / 13/16 (81%) |
| 둘 다 도달한 칸 | 13: on 9 / off 8 (on만 3·off만 2, p=1.000) | 13: on 5 / off 10 (on만 1·off만 6, p=.125) |
| 지목 호출된 칸(주입) | 24: on 16 / off 8 (p=.039) | 15: on 5 / off 9 |
왜 observed 에서 망가지나 — place 시도 분해 (각 16회)
| place 시도 결과 | on (goal 주입 15/16) | off |
|---|---|---|
| 놓음(정책 성공 보고) | 10 | 13 |
| 128 스텝 소진, 안 놓고 계속 듦 | 4 | 1 |
| 놓다 떨어뜨림 | 2 | 2 |
| 칸 결과: 성공 / 바닥 낙하 / false_done | 6 / 4 / 8 | 13 / 1 / 4 |
| 첫 place 스텝 중앙값 (≥128 회수) | 82 (6) | 36.5 (3) |
acted 는 on 21/28 놓음·안 놓음 5·낙하 2 vs off 15/19·3·1, 스텝 65.5 vs 55 — 차이가 작다. 즉 observed 칸에 goal 을 주면 정책이 2.2배 오래 망설이고, 4배 자주 안 놓고, 놓아도 바닥에 4배 자주 떨어뜨린다. 안 놓은 뒤에도 플래너는 done 을 선언한다(false_done 8).
지목된 goal 프레임의 기하
| acted (24) | observed (15) | |
|---|---|---|
| 카메라→원위치 거리 중앙값 | 1.28 m | 1.69 m |
| 카메라 정면↔원위치 각도 | 8° | 22° |
| 물체 픽셀 중앙값 / 원위치 구간 안 | 534 / 19/24 | 410 / 15/15 |
| on 성공 vs 실패 (d · 각도) | 1.27 m·11° vs 1.30 m·6° | 1.69 m·28° vs 1.60 m·22° |
해석
acted 물체의 원위치 프레임은 로봇이 그 물체를 집으러 가서 바로 앞에 선 순간(가깝고 정면)이고, observed 물체는 다른 일 하다 지나가며 본 프레임(멀고 비스듬)이다. 학습 goal 카메라(zed2, 작업 중심 0.2~0.8 m)와의 격차가 observed 에서 더 크다. 다만 같은 kind 안에서는 성공/실패의 기하 차이가 없다 — 프레임을 잘 골라도 못 메운다(260918 시점 감사 결론과 일치).4실패 사례 — observed, goal 주입, on 실패·off 성공 6칸 전부
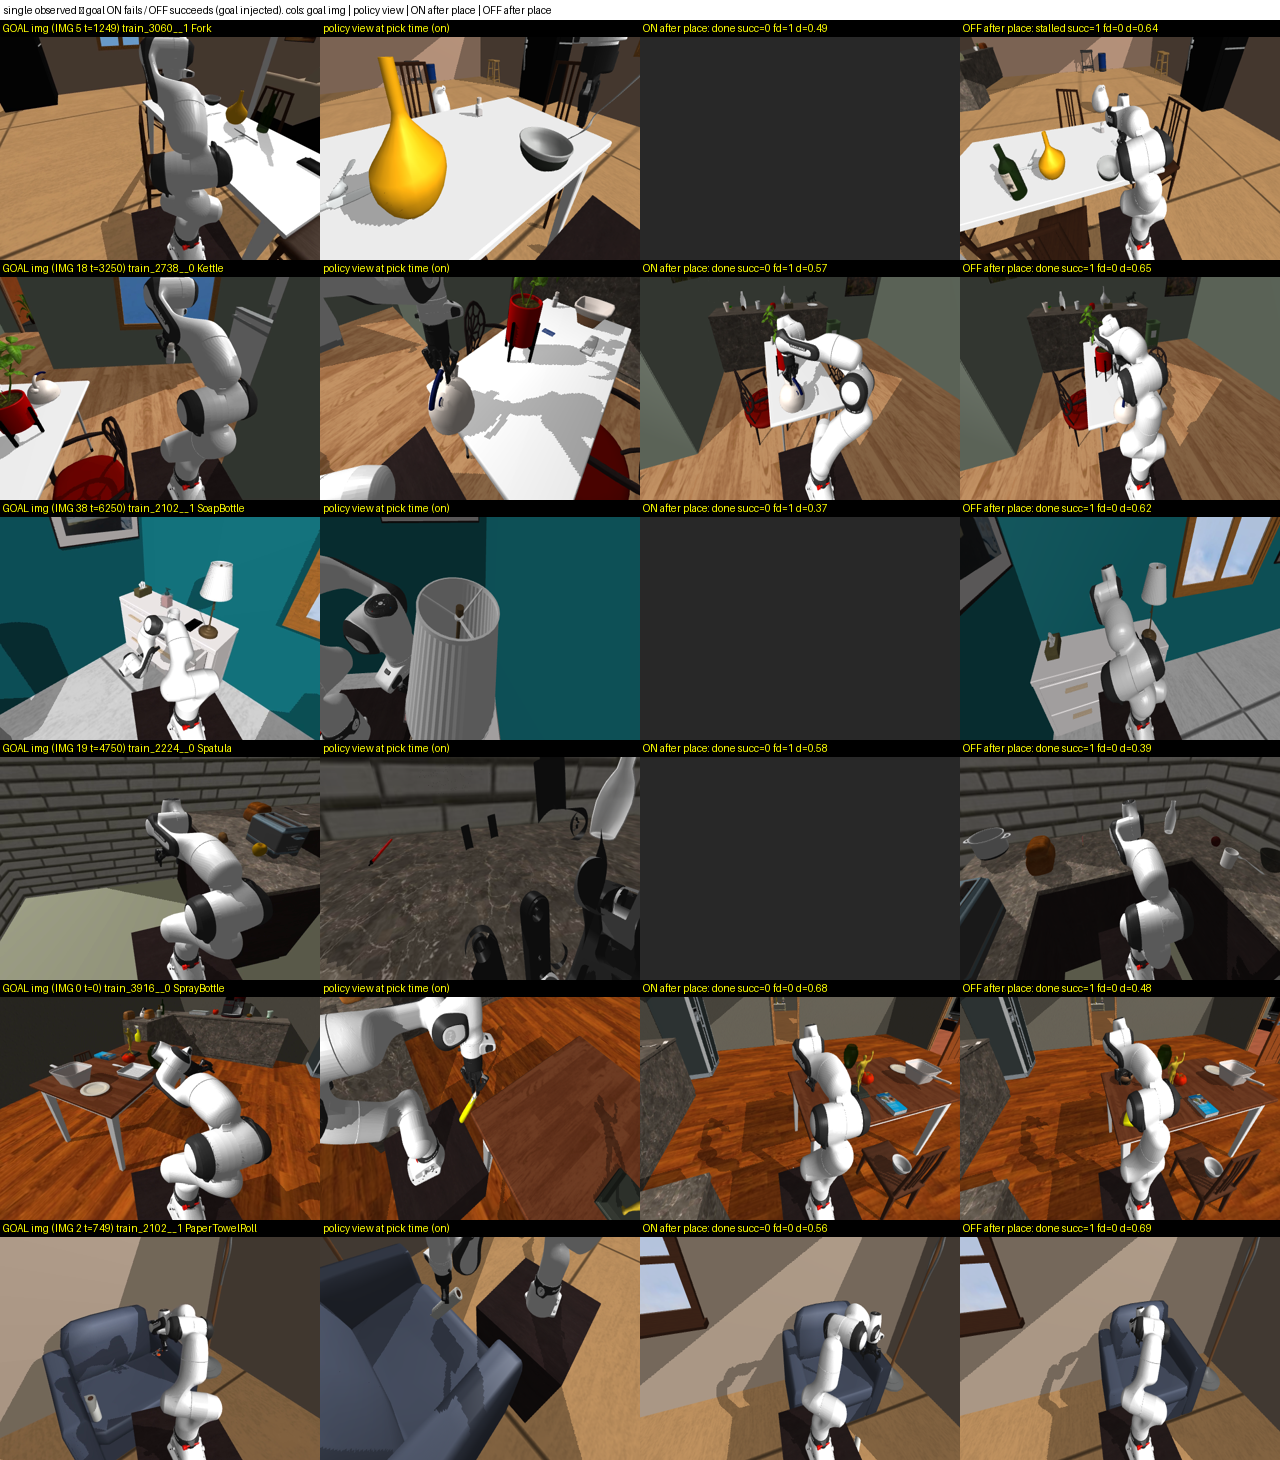
열: goal 이미지(지목 프레임) | 지목 시점 정책 화면 | on 팔 놓은 뒤 | off 팔 놓은 뒤. 검은 칸 = 그 팔이 놓지 않아 postplace 이미지가 없음(128 스텝 소진, 든 채 종료).
| 칸 | on 팔에서 일어난 일 | off 팔 | 교훈 |
|---|---|---|---|
| train_3060 포크 → 식탁 | 128 스텝 소진, 든 채 종료, 플래너 done(fd) · d 0.49 | 33 스텝에 놓음 · 성공 | goal 이 있으면 놓는 동작으로 안 넘어감 |
| train_2102 비누통 → 서랍장 | 128 스텝, 든 채, fd · d 0.37(더 가까이 갔는데도) | 9 스텝 | 위치는 맞췄는데 release 를 못 함 |
| train_2224 뒤집개 → 조리대 | 128 스텝, 든 채, fd · d 0.58 | 9 스텝 | 같은 패턴 |
| train_2738 주전자 → 식탁 | place 0 스텝에 놓았다고 보고, GT 미안착, fd | 18 스텝 · 성공 | 지목 직후 즉시 해제 — "이미 됐다"고 본 형태 |
| train_3916 분무기 → 식탁 | 9 스텝에 놓음 → 바닥 낙하 | 70 스텝 · 성공 | goal 이 놓는 지점을 가장자리로 끌었다 |
| train_2102 종이타월 → 안락의자 | 118 스텝에 놓음 → 바닥 낙하 | 64 스텝 · 성공 | 같은 패턴 |
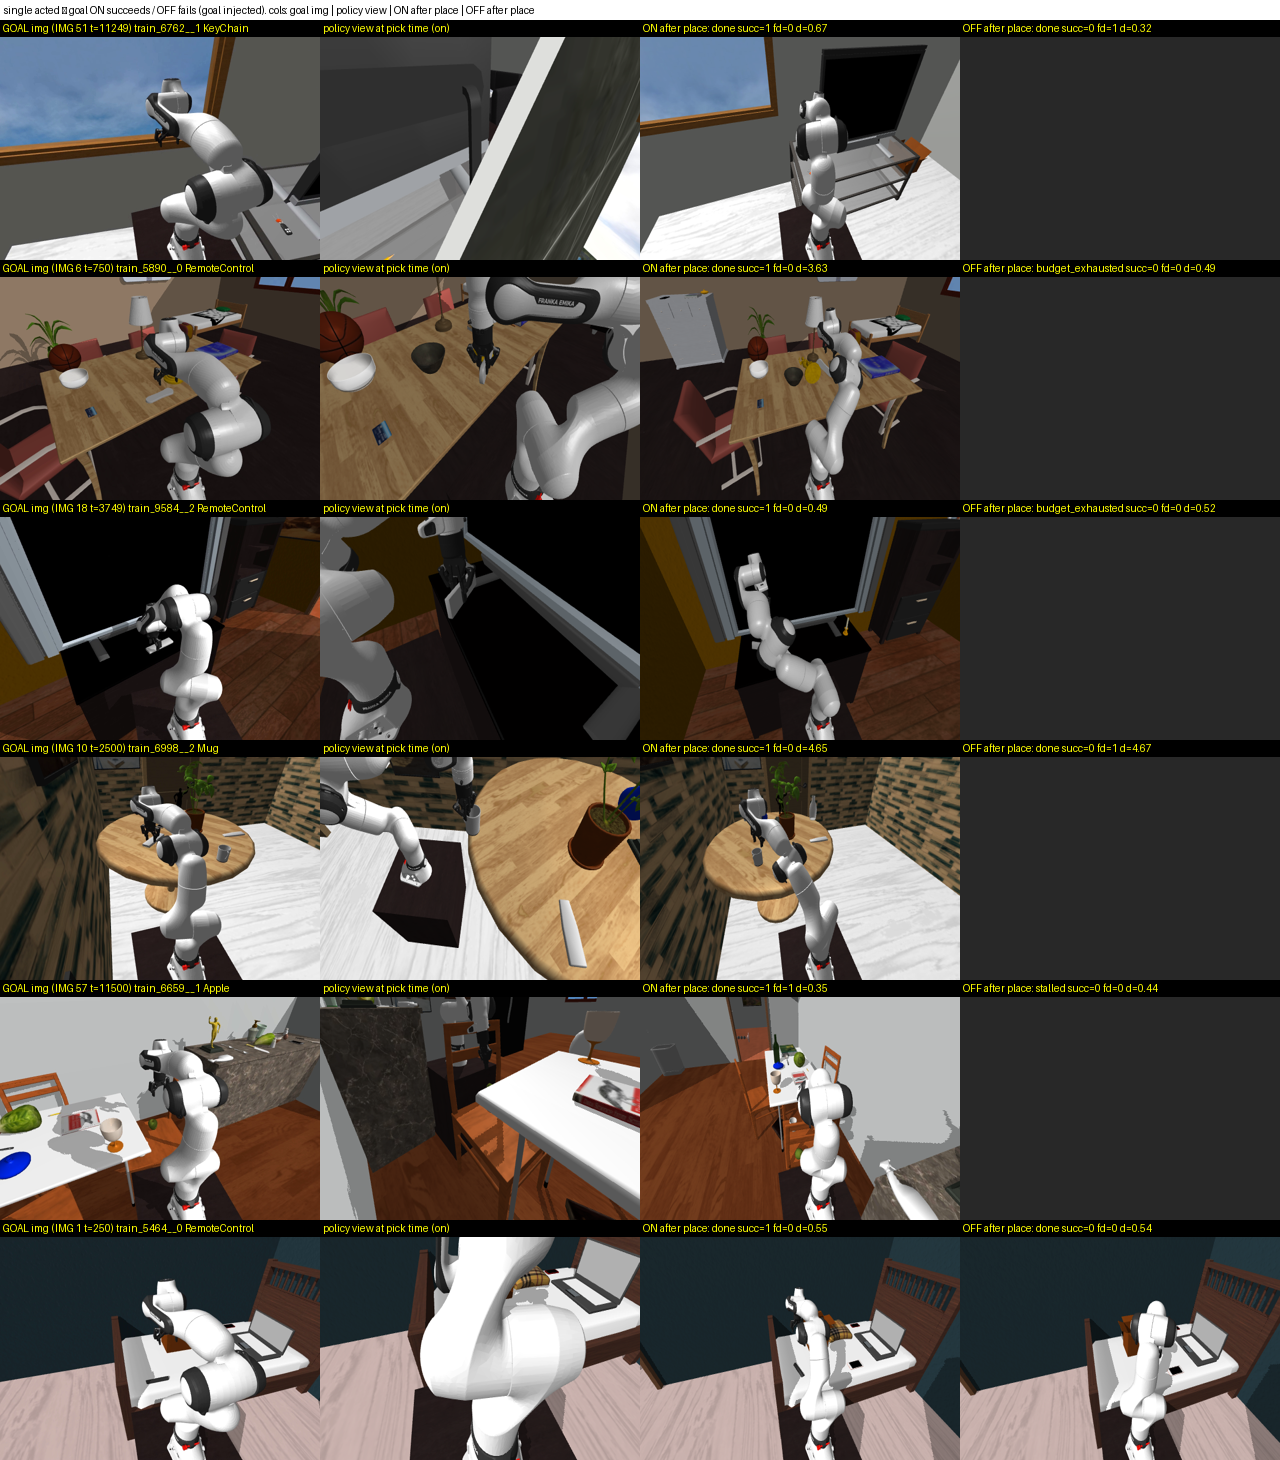
acted 에서 on 이 이긴 칸(주입 10 중 6): off 팔은 대부분 place 에 못 갔다(예산소진·nav 루프·stalled) — goal 의 공이 아니다. 둘 다 도달한 acted 13칸은 9 vs 8.
5Takeaway
기억 프레임 goal 은 채택하지 않는다. 사용자 기준("전체 실행해서 진짜 괜찮게 나오면 넣는다")에 미달 — 전체 동률(p=1.0), place 도달 후 비교로는 acted 동률·observed 열세. 260922 에 그렸던 "goal-on 본표 + goal-off 절제" 그림은 뒤집어 goal-off 본표 + goal-on 절제 행이 데이터에 맞다.
ckpt 를 맞추니 옛 런의 격차(23 vs 17)는 사라졌다 — 그 절반은 ckpt 차이였다. goal 의 고유 효과는 observed 에서의 손실만 남는다.
GT 쪽(Online GT Eval, --seed none) goal-on 측정은 불필요해졌다. 필요하면 오라클 render goal 로 상한만 재는 용도.
6보완점 / 다음
- 하네스 결함 후보(측정 공정성): VLA place 가 128 스텝을 다 쓰고
held_object_id가 남아 있는데 플래너의done이 받아들여진다(on 9칸·off 4칸). "든 채 done" 게이트 도입 여부는 사용자 결정 — 두 팔 같은 규칙이라 A/B 결론은 불변, 본표 SR 정의에는 영향. - CLI 기본값
--goal-image vlmpick→off전환 여부(본 런 스크립트는 명시적으로off). - 지목 캐시는 이번 런 칸당 최대 2회로 문제 없음 — 보류.
- 산출물:
tmp/exec_online/goalv2_{on,off}_restore_s{0..3}.jsonl·tmp/exec_online_goalv2_{on,off}/<plan_id>/·tmp/goal_gt/agg_v2_final.md·pick_geom_v2.json· 로그claude/260923/exp-goal_ab_v2_final.md.