온라인 execute-state 재측정 — 무엇이 나왔고, 무엇이 문제였고, 무엇을 고쳐 어떻게 돌리는가
TL;DR
- find 에서 나온 결과는 확정적이다: 난이도를 맞추면(LOO) 전략 간 성공률 차이가 없다(Δ 전부 ±0.036 이내). 실패의 84%가 파지 실패이고, 완료 인지(false_done 24~29%)도 전략 무관이다.
- 그런데 감사에서 치명적인 것을 찾았다: 우리가 재려던 execute-state 메모리가 6 arm 중 1개(tagmem)에서만 켜져 있었다. vis-pure 는 KEEP 계약이 있는데 103턴 동안 한 번도 쓰지 않았고, frames-uniform 의 온라인 1장은 관측과 중복이라 순증 0, textlog 은 채널 자체가 없고, tagmem 조차 온라인에서 태그화·재검색을 하지 않았다.
- 원인은 능력이 아니라 프레이밍이었다: 메모리가 읽기 8장으로 꽉 찬 채 시작해 KEEP 이 "내 프레임을 버리는 것"으로 읽혔다. 한 문장을 더하자 KEEP 0 → 턴당 0.237(유효 0.092), 13/16칸에서 발생(p=0.0002).
- 4가지를 고쳐 전량 재측정 중: ① 축출 정상화 문장 ② 온라인 노트 태그화+예산 초과 시 재검색
③ tagmem
[now]상태 슬롯(누적 아닌 갱신) ④ KEEP 프레임을 모델이 본 타일로 저장. - 읽기 본표가 v1.0→v1.2 로 바뀌어 셀도 갈아탔다. v1.2 신규 133질의 중 132가 이종 물체 다중 ("Pick up the ladle and the pencil") — find 가 비로소 execute-state 를 잴 수 있는 과제가 됐다.
1 무엇을 재려는가
온라인 트랙이 재는 것은 execute-state memory — 실행 중에 바뀐 세계 상태를 자기 메모리 구조에 반영하고, 그걸 다시 꺼내 "3개 중 1개는 끝냈다"를 아는 능력이다. 읽기 트랙(메모리에서 "어디 있었나"를 답하는 과제)과 짝을 이룬다.
2 프롬프트는 어떻게 생겼고, 메모리·계획은 어디로 들어가나
2-1. 매 턴 모델이 받는 것 (user turn)
이미지 예산은 전 전략 동일하다 — 메모리 8장 상한 + 직전 서브골 3장 + 현재 뷰 1장.
텍스트 메모리를 안 쓰는 전략은 notes 자리에 시드(계획 포함)만 있고 늘지 않는다.
2-2. 계획은 별도 슬롯이 없다 — 노트 안의 [plan] 줄이다
사용자 결정(260919): 계획을 위한 프롬프트 칸이나 응답 필드를 따로 두지 않고,
노트 텍스트 안에 [plan] 접두사 줄로 넣는다. 그래야 "계획을 고칠 수 있는가"가
그 전략의 쓰기 규칙에 자동으로 종속된다(별도 채널을 주면 blind 에게도 메모리를 주는 셈).
2-3. 모델이 매 턴 돌려주는 것 (출력 스키마)
note 와 keep 은 그 전략이 쓸 수 있을 때만 요구된다 —
못 쓰는 전략에는 계약이 "Always return note: null" 로 명시돼 있다.
next 는 이름·방·가구로만 말하고, 실제 object_id 접지는 하네스가 한다
(그래서 같은 카테고리가 둘이면 어느 쪽인지 모델이 지정할 수 없다 — 쌍둥이 셀이 어려운 이유).
2-4. 한 턴의 루프
2-5. 전략별로 "무엇이 어떻게 갱신되나"
| 전략 | 텍스트 | 이미지 | 턴마다 실제로 일어나는 일 |
|---|---|---|---|
| blind | none | none | 아무것도 안 바뀐다. 노트 = 계획 1줄 고정 |
| textlog | none | none | 시드(읽기 트랙 행동 로그 6줄)가 동결. 모델은 note: null 을 낸다 |
| frames-uniform | none | uniform | 샘플러가 관측 타임라인 전체에 균등 재표집 → 8장 중 온라인은 늘 1장(= 현재 뷰). 모델은 관여 안 함 |
| rollforward-v3 | rewrite | none | 모델이 노트 전체를 다시 써서 교체(최대 줄 수 제한). 계획 줄도 이때 같이 쓰게 돼 있으나 실제로는 지워진다 |
| rollforward-vis-pure | none | keep | 모델이 KEEP: F2 DROP: m5 로 8칸 세트를 교체. 8칸이 읽기 프레임으로 차 있어 반드시 하나를 버려야 한다 |
| tagmem-r3 | append | keep | 노트 한 줄이 태그 엔트리로 장부에 누적 + 예산(12줄) 넘으면 읽기와 같은 retrieve 로 추림 + 최신 줄은 [now] 로 갱신·항상 표시. 이미지는 KEEP 로 교체 |
2-6. 실물 — 답 3개짜리 다중 질의가 도는 장면 (tagmem, 지금 런)
[now] 가 "1번 끝, 2번으로 간다"를 들고 있고,
KEEP: F4 DROP: m5 로 읽기 프레임 하나를 버리고 방금 장면을 남긴다.
이게 바로 재려던 execute-state 의 모습이고, 수정 전에는 [now] 도 KEEP 도 없었다.3 지금까지 확정된 결과 — find (4전략, 821칸)
조건이 바뀌지 않은 4전략의 v1.0 결과다. vis-pure·tagmem 은 아래 수정 때문에 재측정 중이라 빠져 있다.
| 전략 | 자기 셀 SR | LOO Δ ±SE | 턴 | pick | 첫 nav 적중 | false_done | unaware |
|---|---|---|---|---|---|---|---|
| blind | 43/82 = 0.524 [0.418, 0.629] | +0.004 ±0.052 | 6.7 | 4.8 | 0.57 | 0.29 | 0.05 |
| textlog | 151/280 = 0.539 [0.481, 0.597] | +0.013 ±0.033 | 8.9 | 5.8 | 0.83 | 0.23 | 0.09 |
| frames-uniform | 149/235 = 0.634 [0.571, 0.693] | -0.029 ±0.036 | 6.7 | 4.5 | 0.75 | 0.25 | 0.09 |
| rollforward-v3 | 127/224 = 0.567 [0.501, 0.630] | +0.014 ±0.032 | 7.2 | 4.2 | 0.84 | 0.28 | 0.05 |
실패는 어디서 나는가 — 351칸
| 유형 | 칸 | 비율 |
|---|---|---|
| GT 근처에 한 번도 못 감 | 42 | 12% |
| 도달했지만 못 듦 (파지 실패) | 294 | 84% |
| 들었지만 예산 초과 | 5 | 1% |
| 들었지만 그 외 | 11 | 3% |
완료 인지 — 전략 무관
false_done(목표 미달인데 done 선언)이 24~29%, unaware_success(들었는데 done 안 하고 계속)가 5~9%. LOO 보정하면 전략 간 차이가 전부 잡음이다. 관측 4장이 전 전략 동일하므로 "손에 들었다"를 못 읽는 건 메모리가 아니라 관측의 한계다.
4 무엇이 문제였나 — 감사
위 결과를 "메모리 방법의 우열"로 읽으려면 각 arm 이 실제로 execute-state 채널을 가져야 한다. 스냅샷 코드에서 메모리 계약 원문을 재구성해 실측과 대조했다.
| 전략 | 정책 | 실측 | 판정 |
|---|---|---|---|
| blind | none / none | 시드 = 계획 1줄, 불변 | ✅ 대조군 의도대로 |
| textlog | none / none | 프롬프트가 note: null 강제 → 모델이 아무것도 못 씀 | ❌ 채널 원천 차단 |
| frames-uniform | none / uniform | 온라인 프레임 1장 고정인데 그게 이번 턴 현재 뷰 = 관측과 중복 | ❌ 순증 0 |
| rollforward-v3 | rewrite / none | 88% 재작성하나 그중 100%가 계획 줄을 삭제 | △ 구조화 상태 소실 |
| vis-pure | none / keep | tagmem 과 글자 그대로 같은 계약인데 keep 0.12/칸 · 89% 칸이 0장 | ❌ 모델이 안 씀 |
| tagmem-r3 | append / keep | 노트 6.6줄/칸 · 77% 칸이 완료 문장 · 온라인 프레임 87% 칸 ≥1장 | △ 절반(쓰기 ✅ / 태그화·재검색 ❌) |
추가로 찾은 3건
build_goal_picker 가 restore+tagmem 일 때만 picker 를 만든다.
내 5전략 런은 전원 off 로 일관되지만(행으로 확인), tagmem goal-on 팔을 다른 5전략 옆에 놓으면 tagmem 만 VLA 조준 보조를 받는 셈.
결정: goal-off 가 본표, goal-on 은 별도 표.
(다른 세션 A/B 결과도 off 23/107 vs on 17/107, p=.263 으로 채택 권고 안 함)done 턴에 일어난다.
턴당 유효 KEEP 은 0.237 이 아니라 0.092. find 는 평균 4.8턴이라 채널을 열어도 쓸 기회가 적다
→ execute-state 무대는 restore(20턴+)와 v1.2 다중 질의다.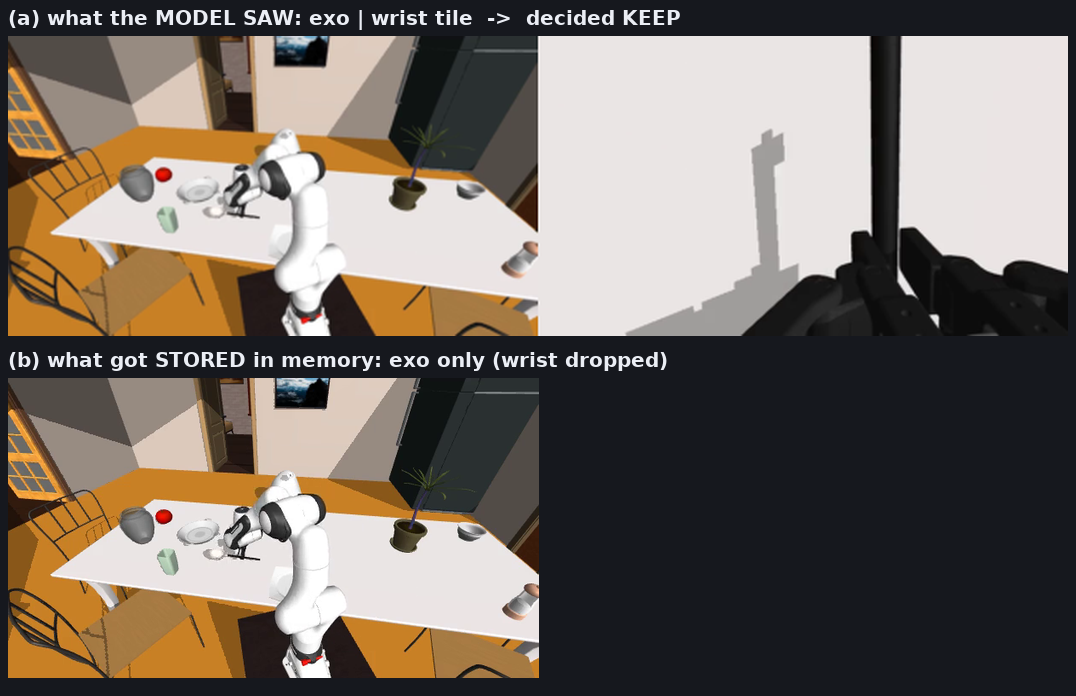
5 원인 규명 — 짝지은 16칸 진단 ($2.05)
vis-pure 가 KEEP 을 안 쓰는 이유가 능력인지 축출 비용의 프레이밍인지 갈랐다. 같은 16칸을 A(현행) / B(문장 한 줄 추가)로 짝지어 돌렸다.
| 지표 | A (현행) | B (축출 정상화 문장) |
|---|---|---|
| 턴 합 | 103 | 76 |
| KEEP 결정 합 | 0 | 18 |
| ≥1장 보관 칸 | 0/16 | 13/16 |
| 턴당 KEEP 율 | 0.000 | 0.237 (유효 0.092) |
| seed_left 평균 | 8.00 (손 안 댐) | 7.12 |
짝 Δ = +0.88 ±0.12 · 증가 13 / 감소 0 / 동일 3 · 부호검정 p = 0.0002.
해석
KEEP 규칙 1번이 이미 "집히는 물체·놓인 물체를 남겨라"라고 말하고 있었다. 즉 이 문장은 목적을 새로 알려주는 것이 아니라 비용 인식만 바꾼다 — 읽기 단계가 8슬롯을 다 써서 메모리가 꽉 찬 채 시작한다는, 하네스가 만든 조건을 명시하는 공정성 수정이다. 부수 지표(Δ턴 −1.69±1.23 · Δpick −2.00±1.33)는 n=16 에서 비유의 — 효율 효과는 본 재측정이 잰다.
6 무엇을 고쳤나 — 조건 4건
| # | 수정 | 영향 arm | 효과 |
|---|---|---|---|
| ① | KEEP 축출 정상화 문장(기본 켬, SBENCH_KEEP_EVICTION_NOTE=0 로 구동작 재현) | vis-pure · tagmem | KEEP 0 → 유효 0.092/턴 |
| ② | 온라인 노트를 태그 엔트리로 누적, 예산(12줄) 초과 시 읽기와 같은 retrieve 로 추림 | tagmem | 온라인 텍스트 예산 무한 → 읽기와 같은 규칙. 초과 칸 find 13% · restore 46% |
| ③ | [now] 상태 슬롯 — 최신 노트가 누적이 아니라 갱신되며 항상 표시 | tagmem | 로그 → 상태. rf-v3 의 재작성과 같은 자리 + 이미지 동반 |
| ④ | KEEP 프레임을 모델이 본 타일로 저장(keep 전략만) | vis-pure · tagmem | 손목 뷰가 메모리에 남음 → 실행 상태 신호 보존 |
rows_oldprompt/ 백업).사용자 결정
- textlog 의 oracle 로그는 복원하지 않는다 — 260909 결정 유지. 논문에서 textlog 은 "execute-state 채널 없음" arm 으로 명시한다.
- tagmem goal-off 가 본표, goal-on 은 별도 표.
- KEEP 프레임은 타일로 저장한다(위 ④).
- execute-state 를 재는 것이 최우선 — 그래서 보고만 하지 않고 채널을 열어 재측정한다.
7 인프라에서 잡은 블로커 2건 (런을 망쳤을 것들)
OVER_COST_CAP 을 보면 재제출을 포기하므로(무한 재제출 방지), 7/8 샤드가 중간에 멈춘 채
런이 조용히 미완으로 끝났을 것이다. → 캡 20 으로 상향.--max-episodes 3 이라 잡 하나는 3편만 돌고 끝나는데
(씬 메모리 편당 ≈15 GB 누적 대책) 재제출 주체가 없어 47편/샤드 중 3편만 돌고 방치됐을 것이다.
→ 범용 babysit_run.sh 신설(복사본마다 같은 걸 놓치지 않게 인자화).OpenAI(max_retries=5) 라 캡 429 는 샤드를 죽인다.
3분 주기 재제출이 "모델 서버 로드 10분 → 즉사"를 반복하지 않도록 세 babysitter 전부에 30분 백오프를 넣었다.그 밖에 통과한 점검: 스냅샷 import · sbench_eval 동결 동일 · live↔스냅샷 drift 없음 ·
전체 시스템 프롬프트 parity · 선택기를 실제 restore 노트 52칸에 오프라인 재생(46% 발동, 표시 전부 ≤12) ·
셀 파일 중복 0·컨텍스트 정합 · resume 스킵 동작 · REMAINING_EPISODES 0 도달 · 제출 dry-run · OOM 이력 없음.
8 읽기 본표가 v1.0 → v1.2 로 바뀌었다
다른 세션에서 find 본표를 v1.2(722질의) 로 바꿨다. "v1.0 + 추가"인 줄 알았는데 확인해 보니 아니었다.
| v1.0 | v1.2 | |
|---|---|---|
| 행 | 4,123 | 4,857 |
| v1.0 ⊆ v1.2 | 아니오 — v1.0 에만 있는 키 70개 | |
| 공통 4,053칸 중 답 동일 | 86.3% (재측정판이라 flash 답이 달라짐) | |
| 공통 칸 중 정답 판정 동일 | 96.6% — 138칸이 뒤집힘 | |
그래서 온라인 셀이 추가만 되는 게 아니라 빠지기도 한다: 재사용 1,322 · v1.0 에만 88(버림) · v1.2 에만 222(새로).
칸당 실측 소요도 답 개수에 따라 갈린다 — 답 1개 3.9분 · 2개 13.1분 · 3개 25.2분.
9 지금 돌고 있는 것
| 런 | 무엇 | 칸 | 진행 | 성공 | 평균 턴 | $ | QOS |
|---|---|---|---|---|---|---|---|
| restore 5전략 | pick→carry→place 2단계, execute-state 주 무대 | 464 | 349 (75%) | 62 | 25.3 | $68 | own (preempt 0) |
| find delta4 | 이미 끝난 4전략의 v1.2 신규 칸만(대부분 다중 질의) | 126 | 29 (23%) | 5 | 20.1 | $4.2 | extra |
| find vis-pure | 조건 바뀌어 전량 재측정 | 309 | 47 (15%) | 26 | 8.1 | $4.8 | extra |
| find tagmem | 조건 바뀌어 전량 재측정(①②③④ 전부 처음 작동) | 332 | 58 (17%) | 33 | 6.7 | $5.3 | extra |
restore 전략별 잠정 (아직 미완 — 참고용)
| 전략 | 행 | 성공 | 평균 턴 |
|---|---|---|---|
| blind | 1 | 1 (1.00) | 9.0 |
| frames-uniform | 32 | 7 (0.22) | 21.6 |
| rollforward-v3 | 50 | 12 (0.24) | 18.7 |
| vis-pure | 69 | 16 (0.23) | 22.3 |
| textlog | 197 | 26 (0.13) | 28.8 |
감시
babysitter 4개(restore · delta4 · vispure · tagmem)가 3분 주기로 돌며 샤드가 3편 돌고 끝나면 재제출하고,
OVER_COST_CAP 이면 멈추고, 429 면 30분 백오프한다. 그 위에 별도 워처가 5분마다
babysitter 사망 · 잡 전멸 · 429/캡 흔적 · 전량 완료를 감시한다.
DONE_GLOB 로 재개하므로 측정 손실은 없고 시간만 늘어난다.
restore(own)는 preempt 0.10 남은 것
- restore 완료 후 own 8장이 find 로 넘어가면 preempt 없이 빨라진다. 전체 완료는 그로부터 6~8시간.
- 완료되면 집계 시 v1.0 에만 있던 88칸을 빼고 재사용 1,322 + 신규 222 로 맞춘다
(
aggregate_online_main.py의ROW_PATTERNS에 고정해 둠). - 그 다음이 본 분석: execute-state 채널이 열린 arm(vis-pure·tagmem)이 안 열린 arm 과 실제로 갈리는가 — 특히 restore 와 v1.2 다중 질의에서. 지금까지는 대조가 성립하지 않아 답할 수 없었다.
- 미결: tagmem 시드가 구조적으로 가장 크다는 점(34줄 + 8장 vs 나머지 1~6줄)은 읽기 트랙과 같은 성질이지만 표에 명시해야 한다.