신규 VLA 연결 검증 — MolmoBot-Pi0 × online 2-stage
TL;DR
- 통합 성립 — 신규 PyTorch VLA로 online 2-stage 전체 루프(서버→어댑터→navigate/carry/pnp 전환→dense 영상) 완주. 하네스가 정책-교체 가능함이 실증됨
- 조작은 0승 — 같은 house 136에서 구 모델은 pick 61스텝 성공, 신 모델은 팔이 거의 정지 (모션 0.023 = 구 모델 14.42의 1/600) → 모델 약함보다 관측 분포 불일치 의심
- 신 모델의 자체 벤치는 PnP 42.5%(논문 36% 상회) — "우리 환경에서만 얼어붙는다"가 핵심 미스터리, 카메라 A/B가 다음 단계
- 비호환 3종을 어댑터로 해소: PyTorch 자체 서버(raw-obs 계약) / 학습 카메라 상이 / 프롬프트 관례 상이("Pick up the X and place it in or on the Y")
- 표본 1 주의: 방어 가능한 결론은 "이 인스턴스에서 실패"까지 — "42.5%와 모순"은 성립 안 함
1 새 모델은 무엇이고, 왜 그대로 안 꽂히나
모델: 사용자가 AllenAI 공식 MolmoBot 파이프라인(pi05_mlspaces_finetune)으로 직접 FT한 π0.5 — molmobot-data part1(PnP 전용), 20k step, PyTorch 포맷. 자체 rollout 평가(HardBench 200ep): PnP 42.5% (논문 π0.5-FT 36% 상회) / Pick 7.5% / NextTo 10.5% (미학습 태스크는 낮음 — 정상).
| 호환 갭 (조사 2회로 확정) | 구 스택 (franka_2cam 15k) | 신 스택 (part1 20k) | 어댑터 |
|---|---|---|---|
| 서빙/관측 계약 | JAX 서버 + $MS PI_Policy가 클라이언트에서 전처리(DROID 스키마, 그리퍼 정규화) | PyTorch 자체 서버가 서버에서 전처리 — raw obs(qpos, task, 원본 프레임) 기대. 그대로 꽂으면 KeyError + 그리퍼 이중 정규화 | raw-obs ws 클라이언트 신규 작성 (molmobot_policy.py) |
| 카메라 | exo_camera_1 + wrist_camera | 학습: randomized_zed2_analogue_1 + wrist_camera_zed_mini | FrankaOmniPurposeCameraSystem 부착 + 카메라명 설정화 |
| 프롬프트 | 소문자 5템플릿 byte-identical ("pick up the {}.") | 템플릿 증강 없음 — h5 실측 "Pick up the X and place it in or on the Y" (대문자, 마침표 없음) | 프롬프트 프로파일 분기 (기본값 = 기존 유지) |
2 런 B — 구 모델과 동일한 GT 시퀀스 (직접 비교)
house 136, 목표 "Move the bowl to the TV stand.", GT 4단계. 구 모델(260813 최종 런)과 같은 인스턴스·같은 시퀀스·같은 하네스에서 정책만 교체.
| k | skill | 구 모델 (franka_2cam 15k) | 신 모델 (part1 20k) |
|---|---|---|---|
| 0 | navigate(table) | 성공 | 성공 (receptacle_check: matched — 지난 리뷰 I8의 provenance 필드 실전 작동) |
| 1 | pick(bowl) | 성공 61스텝 | 실패 600/600 — 무모션 (mean diff 0.023, 임계 2.06 미달) |
| 2 | navigate(carry) | 성공 (bowl 동반) | 성공 (단, k=1 실패라 carry 없음 — held 상태 추적이 올바르게 미발동) |
| 3 | pick_and_place | 실패 — 모션 활발, bowl 낙하 ("partial") | 실패 — no_evidence: bowl이 카메라 프레임에 아예 없음 (k=1 실패의 인과 — bowl은 원위치, 로봇은 TV stand를 향해 돌아섬) |
k=1 pick — 이 실험의 핵심 증거 무모션 실패
- 준 명령
- VLA 프롬프트
"Pick up the bowl"(신 모델 관례) — 로봇은 테이블 앞 정위치 (구 모델이 61스텝에 성공한 그 자리) - 실제 결과
- 600스텝 내내 그리퍼가 거의 제자리. 프레임 diff mean 0.023 — 구 모델의 14.42 대비 1/600. 키프레임 3장(0/150/299)이 사실상 동일
- 영상이 보여주는 것
- 팔이 초기 자세에서 미동만 반복하는 전 구간. wrist 뷰도 정지 상태 — "시도하다 실패"가 아니라 "시도 자체가 없음"
k=3 pick_and_place no_evidence (인과적 실패)
- 준 명령
"Pick up the bowl and place it in or on the stand"— 그러나 k=1 실패로 bowl은 원위치에 남았고, carry-navigate가 로봇을 TV stand 쪽으로 돌려세워 bowl이 시야 밖- 실제 결과
- 무모션, oracle 실패. 목표물이 시각적으로 존재하지 않는, 정책 입장에서 완전 분포 밖 상황 — 이 단계는 신 모델의 능력 평가로 쓸 수 없음
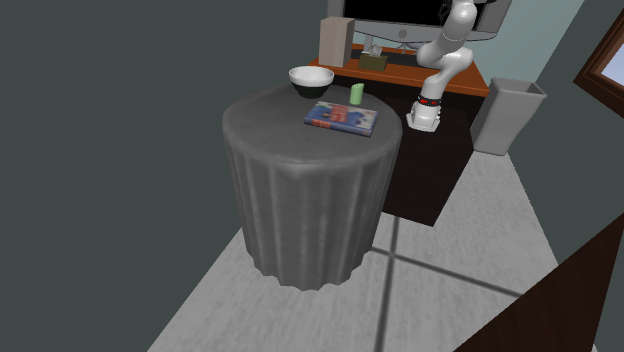
3 런 A — 단일 스탠스 PnP (모델 주특기 시험)
이 모델은 PnP 전용 데이터로만 학습됐으므로(pick 단독 벤치 7.5%), navigate 후 한 자리에서 pnp 전체를 시키는 별도 런을 설계. 명령: "Pick up the bowl and place it in or on the stand" (다이닝 테이블 앞 스탠스).
- 결과
- 모션 발현 (정적 플로어의 4.09배 — 런 B의 무모션과 대조적으로 "시도"는 있음) but oracle 실패 — 이 스탠스에서 TV stand는 팔 리치 밖(~1.2m > 0.8m)이라 애초에 성공 불가능한 배치. "정책이 반응한다"는 증거용 런으로 해석해야 정확함
4 실패 사례 — 원문과 원인
G1. 브리프의 런 A 원안이 무효 테스트 구현자가 사전 적발
G2. 1차 서버 무음 사망 (k=3 진입 직후) 원인 미확정
G3. 신 모델 pick 무모션 미해결 — 다음 실험의 대상
5 결론과 다음 단계
사용자 질문("새 VLA로 online 2-stage 실행이 가능한가")에 대한 답: 파이프라인은 된다. 이종 스택(JAX→PyTorch, 클라→서버 전처리, 프롬프트 관례)을 어댑터 계층으로 흡수하며 전 루프가 완주했고, 하네스의 정책-교체 가능성이 실증됐다. 조작 성공은 아직 없으며 그 원인 규명이 다음 단계다.
| # | 다음 단계 | 목적 |
|---|---|---|
| 1 | 프롬프트 A/B: 런 B k=1을 pnp 문장으로 재실행 | G3 가설 ② 검증 (가장 싸고 빠름) |
| 2 | 카메라 A/B: 학습 캠(randomized_zed2)으로 교체 | G3 가설 ① 검증 |
| 3 | 그들의 eval.py를 유사 에피소드에 재현 | 하네스 vs 환경 분리 (42.5%가 재현되는가) |
| 4 | 다중 인스턴스 확대 | 표본 1 한계 해소 |
판단
런 A/B의 모션 비대칭(pnp 문장 = 반응, pick 문장 = 정지)이 가장 강한 단서다 — 이 모델은 PnP 문장만 본 모델이므로, 2-stage 문법을 이 모델에 맞추려면 "pick 단독" subgoal을 버리고 nav→pnp 원자 단위로 가는 편이 맞을 수 있다 (마침 실험 B에서 VLM 분해의 최빈 패턴도 nav→pnp였다). 프롬프트 A/B(1번)가 이를 가장 싸게 확정해 준다.