실험 A/B/B2 결과 — 2-Stage 분리 검증
TL;DR
- Main goal:
"Move the bowl to the TV stand."— 이 한 문장을 (B) VLM이 subgoal로 분해할 수 있는가, (A) 분해된 subgoal을 VLA(π0.5-FT)가 시뮬에서 실행할 수 있는가를 분리 검증 - (B) 분해: gemini-3.6-flash가 15/15 언롤에서 유효한 분해 산출 (id 정확도 100%) — 단 가드레일(인벤토리 검증+재질의)이 필수 부품(trial당 ~1.7회 교정)
- (A) 실행, 최종 런: navigate → pick 성공(61스텝) → carry navigate 성공(bowl이 base와 함께 이동)까지 입증. 마지막 place 재개는 bowl을 스탠드 옆 바닥에 낙하(z 0.85→0.05m) — 가설 ④ partial
- 하네스 결함 3종 수정 완료: F1 접근반경(600스텝 실패→61스텝 성공), F2 대형가구 접근 파라미터(carry nav 성공), F5 인벤토리 아티팩트 필터(86→83개)
- 남은 실패(place 중 낙하)는 하네스 결함이 모두 제거된 뒤 남은 최초의 정책 층위 후보 — 근본원인 미조사 (F6)
(수정 전 600 실패)
(가드레일 후)
1 시나리오 — main goal과 GT subgoal
무대는 샘플 데이터셋 val_136__0의 house 136 (물체 86개, 필터 후 83개). 로봇(Franka, mobile base)은 다이닝 테이블에서 0.86~0.90m 떨어진 지점에서 시작한다 — 팔 리치(~0.8m) 밖이라, 내비게이션 없이는 어떤 조작도 물리적으로 불가능한 배치다.
| 등장 요소 | id (인벤토리 표기) | 위치 (x, y, z) |
|---|---|---|
| 목표 물체: bowl (다이닝 테이블 위) | bowl_847a24bf..._1_0_7 | (5.69, 9.05, 0.84) |
| 경유지: dining table | diningtable_c1517e53..._1_0_7 | (5.75, 8.91, 0.39) |
| 목적지: TV stand | stand_6bc09b7e..._2_0_7 | (5.99, 10.25, 0.35) |
| 로봇 시작 위치 (base) | — | (6.47, 8.38) |
GT subgoal 시퀀스 (사람이 분해한 정답 — 실험 A의 스크립트이자 실험 B의 채점 기준):
실험 B에는 같은 목표의 언어 변형 5종을 사용: "Put the bowl in front of the TV." / "Move the bowl to the TV stand." / "Take the bowl from the dining table and put it on the TV stand." / "Place the bowl on the TV stand in the living room." / "bowl을 TV 앞에 갖다 놔." (각 3 trial = 15 언롤)
실행 정책(VLA) — 무엇을 썼고, 왜 이렇게 제약되나
저수준 실행은 π0.5를 MolmoSpaces 데이터로 자체 fine-tuning한 체크포인트다 (이 세션이 아니라 scenemem 트랙에서 260804에 이 클러스터에서 학습된 것). 정확한 레시피 — Physical-Intelligence 공식 pi05_droid 체크포인트에서 시작 → MolmoBot 공개 데이터(molmobot-data)의 mlspaces/franka_2cam으로 15k step FT, SigLIP 인코더 동결(MolmoBot 논문 arXiv 2603.16861의 레시피 그대로 — 15k step, 논문 보고치 sim SR 36.0% vs zero-shot 10.0%). 즉 MolmoBot의 π0.5-FT 베이스라인을 로컬 재현한 모델이다. config pi05_mlspaces_franka (repos/scenemem/openpi), 관측 = exo_camera_1 + wrist_camera (224px letterbox), 액션 = 8-dim 절대 관절 타겟 @15Hz, websocket 서빙.
| 학습 분포의 사실 | 하네스에 강제된 제약 |
|---|---|
| 프롬프트가 5개 고정 템플릿(소문자+마침표)으로만 학습됨 | subgoal→프롬프트 변환을 byte-identical로 유지 (OOD 문구는 최대 14% 손실) |
| 로봇 배치가 대상 기준 반경 0.0~0.7m + 안전 0.15m에서 샘플링됨 | navigate가 같은 분포로 배치해야 pick이 성공 (F1: 600스텝 실패 → 61스텝 성공의 전부) |
| Franka 데이터에 open/close가 0% | planner에서 open/close 스킬 자체를 금지 |
| pnp가 항상 pick부터 시작하는 원자 단위로 학습됨 | held 상태 재개(가설 ④)는 분포 밖 사용 — partial 결과의 배경 |
대안 후보: AllenAI 공식 MolmoBot 릴리즈(MolmoBot-Pi0/DROID/SPOC, HF allenai/molmobot-models)도 같은 MolmoSpaces 시뮬 학습 계열 — 하네스가 websocket 경계에서 정책-불가지론적이라 openpi 포맷이면 교체 비교 용이. 특히 RBY1 모바일 학습분이 있어 N0 텔레포트를 진짜 navigate 실행으로 대체할 잠재 경로.
2 (B) VLM 분해축 — 모델에 무엇을 넣었고 각 턴에 무엇이 나왔나
모델 입력 ①: 시스템 프롬프트 (전문, 916 chars)
모델 입력 ②: 매 턴 유저 메시지 = 지시문 + 씬 이미지 + 인벤토리 + 직전 결과
첫 턴에는 자연어 지시문과 exo 카메라 현재 프레임(JPEG), 그리고 물체 인벤토리 83줄이 들어간다. 2턴째부터는 직전 subgoal의 실행 결과(oracle 모드: 성공/실패)가 덧붙는다. 인벤토리 형식 예시(실제 3줄):
턴별 워크스루 — 변형 "Put the bowl in front of the TV.", trial 1 (원문)
→ 먼 거리를 스스로 인지하고 navigate부터 선택. GT ①과 일치 (GT는 테이블, 모델은 bowl을 앵커로 지정 — N0 텔레포트에선 동등한 결과).
→ 목표 물체와 목적지 둘 다 정확한 id로 지정. GT ②~④를 원자적 pnp 하나로 압축한 형태 — 시퀀스 클래스 nav→pnp (전체 15언롤 중 11회, 73%로 최빈).
→ 성공 확인 후 종료 선언. 이 trial의 4 API 호출 중 1회는 환각 id 재질의로 소모($0.124, 턴당 지연 9~23초).
15 언롤 집계
| 지표 | 실측 | 해석 |
|---|---|---|
| id 정확도 (조작 결정 12건 기준) | object 12/12, receptacle 12/12 | 단, 15 trial 중 3건은 조작 없이 종료(abort 2 + 가짜 done 1) |
| 시퀀스 클래스 | nav→pnp 11/15 (73%) | N0 문법과 일치 |
| 환각/재질의 | 25회 / 25회 | 가드레일이 필수 부품 — trial당 ~1.7회 교정 후에야 100% |
| 일관성 | 평균 0.73 (한국어 변형 0.33) | 문구 민감성 |
| 비용/지연 | 총 $1.60 (61 calls), 턴 평균 15.4초 | gemini-3.6-flash |
실측 예시 — 신규 실패 모드 "done-escape" (변형 1, trial 1 원문)
3 (A) VLA 실행축 — 최종 런: 명령 → 실행 → 영상
GT subgoal 시퀀스를 그대로 스크립트로 넣어 π0.5-FT(franka_2cam, 15k step ckpt)가 시뮬에서 실행. 이번 최종 런은 F1·F2·F5 수정이 모두 반영된 상태이고, 영상은 2 sim-step당 1프레임(dense), exo+wrist 병행, 15fps로 전 구간을 담았다. 아래 각 스테이지 카드에 [① VLA/하네스에 준 명령 → ② 로봇이 실제로 한 것(좌표 증거) → ③ 이 영상이 보여주는 것]을 명시한다.
Run 1 — Baseline: navigate 없이 시작 위치에서 바로 pick (실패 재현용 대조군)
Stage B-0. pick 실패 (600/600 스텝 타임아웃)
- 준 명령
- VLA 프롬프트
"pick up the bowl."— 로봇은 시작 위치 (6.47, 8.38) 그대로. bowl까지 0.86m (학습 배치 상한 0.7m 밖) - 실제 결과
- 600스텝 내내 파지 실패. bowl은 (5.69, 9.05) → (5.69, 9.12)로 7cm 밀렸을 뿐 (접촉은 있었으나 파지 없음). base 이동 0.000m
- 영상이 보여주는 것
- 팔이 계속 뻗고 허우적대지만 끝까지 bowl을 잡지 못하는 전 과정 20초(600스텝 전체). wrist 뷰에선 bowl이 시야에 잡히다가 손끝이 닿을 듯 못 잡는 것이 보임
이 baseline이 "왜 navigate subgoal이 반드시 필요한가"의 물리적 증거다 — 같은 정책, 같은 프롬프트로 아래 Run 2에서는 61스텝 만에 성공한다. 차이는 오직 로봇의 위치.
Run 2 — Main: GT 4-subgoal 시퀀스 전체
Stage ① navigate(dining table) 성공 N0 텔레포트 — 정책 미개입
- 준 명령
- 하네스 호출
teleport_to(env, diningtable_c1517e53...)— 학습 분포와 동일한 접근 파라미터(반경 0.0~0.7m, 안전 0.15m)로 base 재배치 - 실제 결과
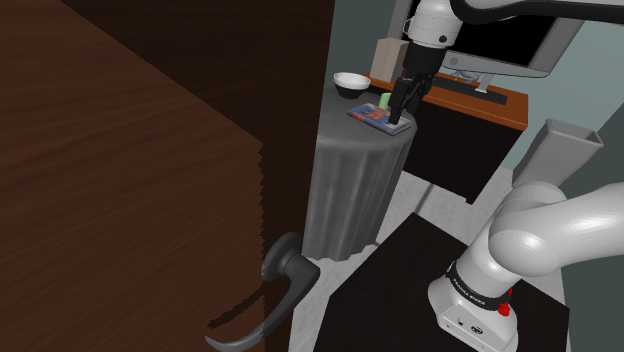
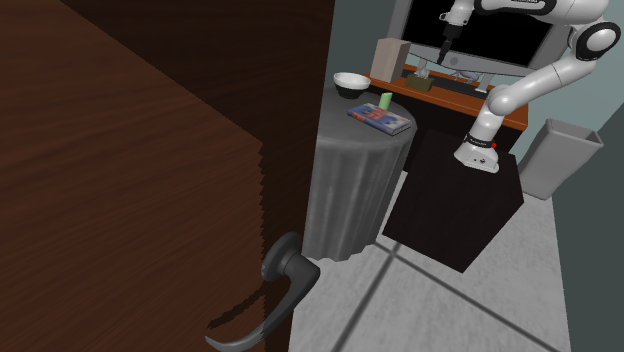
- base (6.47, 8.38) → (6.36, 9.31), 0.935m 이동,
nav_ok=True. bowl까지 거리가 팔 리치 안으로 진입 - 이미지가 보여주는 것
- 텔레포트 직전/직후 exo 프레임 — 로봇이 테이블 앞으로 순간이동한 전/후 비교 (텔레포트라 중간 과정 영상은 없음, N0+ 스무스 이동은 백로그)
Stage ② pick(bowl) 성공 — 61스텝 (oracle 판정, 조기 종료)
- 준 명령
- VLA 프롬프트
"pick up the bowl."(학습 템플릿과 byte-identical) - 실제 결과
- 61스텝 만에 파지+리프트 성공 (시뮬 물리 predicate 판정). bowl z 0.837 → 0.848 (들어올림). 수정 전 600스텝 실패였던 것이 F1 수정(접근거리 정렬) 하나로 61스텝 성공
- 영상이 보여주는 것
- 접근→파지→리프트 성공 순간까지 전 과정 (성공 시점에 조기 종료되어 2초 분량). wrist 뷰에서 bowl이 그리퍼 안으로 들어오는 장면
Stage ③ navigate(TV stand) + carry 성공 — F2 수정 검증 N0 텔레포트
- 준 명령
- 하네스 호출
teleport_to(env, stand_6bc09b7e..., carry_object_id=bowl_847a24bf...)— 대상이 receptacle이므로 이번에 추가된 대형가구용 접근 파라미터 (반경 0.3~0.8m, 안전 0.3m) 적용 - 실제 결과
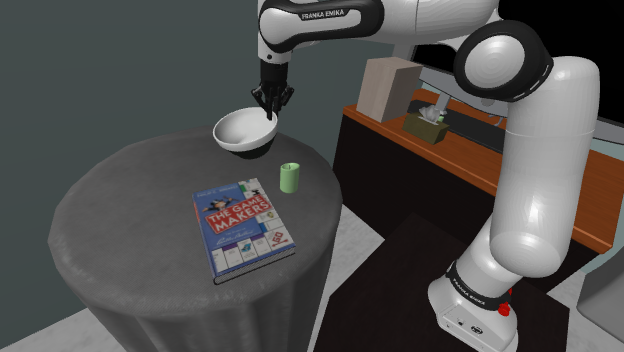
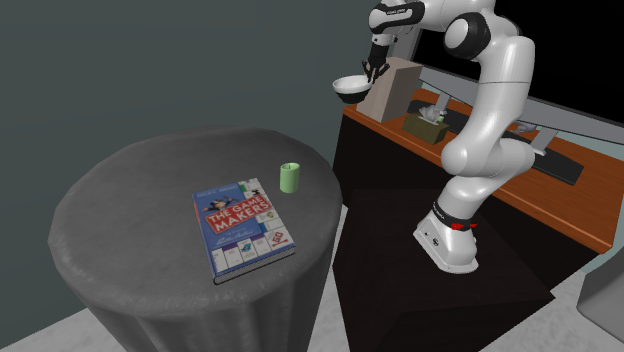
nav_ok=True— 처음 3개 후보 포즈는 TV 바디와 충돌해 기각, 4번째 후보에서 성공(반경 확장이 실제로 필요했다는 실증). base 0.252m 이동, bowl이 base와 함께 (5.69, 9.04) → (5.51, 9.71)로 0.686m 동반 이동, z는 소수점까지 불변(0.848) = 들고 있는 상태 유지- 이미지가 보여주는 것
- bowl을 든 채 TV 스탠드 앞으로 순간이동한 전/후 비교. after 프레임에서 그리퍼에 bowl이 들려 있는 상태로 스탠드 앞에 서 있는 것 확인 가능
Stage ④ pick_and_place 재개 실패 — bowl 바닥 낙하 (가설 ④ = partial)
- 준 명령
- VLA 프롬프트
"pick up the bowl and place it on the stand."— 이미 bowl을 든 상태에서 pnp 프롬프트를 주면 place 국면부터 재개하는가? (가설 ④) - 실제 결과
- 600스텝 타임아웃, oracle 실패. bowl은 z 0.848 → 0.0495 (바닥), 최종 위치 (5.62, 9.55)는 스탠드 중심에서 0.79m — 스탠드 위가 아닌 옆 바닥에 떨어짐. 프레임 diff 분석: mean 14.42 (빈 그리퍼 대조군의 21배, pick 단계와 동급) → 진짜 place 시도가 있었고, sim step ~50~110 구간에서 diff 급락 후 flatline ≈ 낙하 시점
- 영상이 보여주는 것
- 스탠드를 향해 팔을 뻗고 bowl을 놓는(놓쳐 떨어뜨리는) 순간, 이후 빈 손으로 회수 동작을 반복하는 나머지 구간까지 600스텝 전체 20초. wrist 뷰에서 bowl이 시야에서 사라지는(낙하) 시점이 명확히 보임
가설 ④ 최종 판정 — partial
선행조건(② pick 성공 + ③ carry nav 성공)이 이번 런에서 처음으로 모두 충족된 상태에서의 판정이다. "held 상태에서 pnp 프롬프트를 주면 place 행동이 발현된다"는 성립 (motion 증거 + 스탠드 방향 접근 + 놓는 동작) — 그러나 완수는 실패 (스탠드 위가 아닌 바닥 낙하). 낙하의 근본원인(파지력 유지 / release 타이밍 / place 좌표 정합)은 미조사 → F6. 참고: π0.5-FT의 학습 데이터에서 pnp는 항상 pick부터 시작하는 원자 단위라, 중간 상태(held)에서의 재개 자체가 분포 밖 사용이다.
4 (B2) stepwise vs plan-first — 온라인 모드 비교 (36 언롤, $3.55)
실전 온라인 제어에서 VLM을 매 subgoal 경계마다 호출할 때의 두 방식: stepwise(매 턴 "지금 할 것 하나"만 출력) vs plan-first(첫 호출에 전체 plan 산출, 이후 호출은 현재 스텝 선택 + 필요시 revised_plan). 성공/실패 경로 각각 주입해 4셀 비교.
| mode | path | id_acc(raw)* | 일관성 | 재질의+환각 | 실패 반응 | calls | 비용 | 입력 chars/call |
|---|---|---|---|---|---|---|---|
| stepwise | success | 0.0% | 1.00 | 9+9 | — | 27 | $0.83 | 13,310 |
| stepwise | fail | 27.3% | 0.89 | 10+10 | reroute 0.11 | 32 | $0.86 | 14,868 |
| planfirst | success | 22.2% | 0.89 | 0+0 | — | 28 | $0.79 | 8,703 |
| planfirst | fail | 33.3% | 1.00 | 1+1 | replan 0.44 | 42 | $1.07 | 8,814 |
* raw id_acc는 아티팩트 오염(F5, 당시 미수정)으로 절대값 무효 — 4셀 동일 조건이라 모드 간 비교만 유효. 환각 합계는 stepwise 19회 vs plan-first 1회 = 19:1.
행동 차이 (양쪽 다 논리적으론 유효)
| stepwise | plan-first | |
|---|---|---|
| 성공 경로 시퀀스 | pnp-only 9/9 — 매 턴 이미지를 재판단해 "팔이 닿는 거리"로 보고 navigate 생략 | nav→pnp 8/9 — plan 수립 시점에 교과서적 2단계 계획 |
| 실패 대응 | 암묵 재계획 (reroute 0.11) | 명시적 revised_plan 0.44 — 해석·채점 가능 |
| done 선언 | 4셀 전부 9/9 (100%) — 분해 자체의 품질은 raw id_acc보다 훨씬 높음 | |
권고 — 온라인 기본값 = plan-first
근거(아티팩트와 무관한 신호만): ① 환각/재질의 19 vs 1 — 구조적 원인(선택 스키마는 매 턴 id 강제 안 함) ② 입력 38%↓(stateless — 실전 "step 후 재호출" 형태 정합) ③ 실패 시 revised_plan이 명시적 산출물(벤치마크 채점 재료). 유보: stepwise의 매 턴 이미지 재판단이 불필요한 navigate를 걸러내는 장점은 실이미지 온라인 결합에서 재검증. (orchestrator --planner-mode 배선은 예정)
5 실패 사례 모음 — 원문과 원인 (수정 반영)
F1. 실험 A 1차 — pick 600스텝 무접촉 수정 완료 (80a4b27)
F2. carry 중 대형가구 접근 불발 수정 완료 (c40d7a8)
F3. 실험 B — abort 2건 가드레일 정상 작동
F4. 실험 B — done-escape 신규 실패 모드 (미해결, 대책 특정됨)
F5. 실험 B2 — 아티팩트 유인 (pick의 77%) 수정 완료 (c40d7a8)
F6. 최종 런 — place 재개 중 bowl 낙하 신규 — 최초의 정책 층위 후보 (미조사)
6 종합 — 교차 판정과 다음 단계
교차 판정: (B) 분해 성립 + (A) ①~③ 성립 → "자연어 → plan-first 분해 → 온라인 실행" 결합 런의 전제 조건이 모두 충족됐다. 남은 리스크는 ④(place 완수)뿐이며, 이는 결합 런에서도 동일하게 나타날 것이므로 F6 조사와 병행하면 된다.
| # | 발견 | 조치 |
|---|---|---|
| 1 | 접근거리=학습분포 정렬이 pick 성패를 가름 (600→61) | 반영됨 80a4b27 |
| 2 | 가드레일(검증+재질의) 없으면 환각 id가 실행에 유입 | 이미 내장 T1~T3부터 |
| 3 | carry 중 대형가구 접근 — receptacle용 파라미터 필요 | 반영됨 c40d7a8 |
| 4 | 씬 아티팩트(place_receptacle/*)가 인벤토리 오염 | 반영됨 c40d7a8 (object_enum 필터) |
| 5 | done-escape — done 선언은 무검증 탈출구 | 예정 done 시 oracle 대조 + 조작0회 감지 |
| 6 | plan-first가 온라인 기본값으로 우월 (환각 19:1) | 예정 orchestrator --planner-mode 배선 |
| 7 | place 재개 중 bowl 낙하 — 정책 층위 후보 | 조사 필요 F6 (grasp 유지/release/좌표 정합) |
다음 단계 (순서)
① 결합 런: 자연어 → plan-first 분해 → 온라인 실행 (실이미지, --planner-mode 배선 포함) → ② F6 조사 (held-재개 낙하 원인) + done 검증 추가 → ③ 문서화·최종 리뷰. 보류 중: T4(worker 게이트), N0+(스무스 이동 렌더)/N1(A* 경로) 백로그.