Tier-2 LoRA fixture accuracy — partial 30-sample cascade
TL;DR
- scene-mem-benchmark
subtasks.json기반 multi-turn 학습 (per-chunk supervision + final-query recall) — Tier-1 V2 merged ckpt에서 LoRA 이어 학습 (3 epoch, 258 step, 1h 6m) - format은 100% RoboCasa atomic style —
place the X in the Y - 10 scenario × 29 simple test sweep (Job 2996 PREEMPTED at 10/30 by extra QoS) — partial JSON checkpoint 추가 후 데이터 보존
- memory_success는 stub action이라 0/30 — 실제 metric 추출은 진짜 Pi0.5 cascade 필요
- 강점:
cabinet(89%) /microwave(40%) /toaster_oven(50%) — common fixture 잘 학습 - 약점:
oven·freezer·dishwasher0% — rare fixture에서 cabinet fallback bias
1 배경 / 목적
왜 Tier-2가 필요했는가: Tier-1 V2는 vocab swap (dusting → RoboCasa atomic) 성공. 그러나 target fixture 정확도가 부족 — combo_002 probe에서 steak/bowl/fish 모두 부정확. 원인: Tier-1은 single-atomic episode 학습 (memory FIFO 비어있음). Deployment 분포 (prior video N개 → memory build → final query)와 불일치.
해결책: scene-mem-benchmark 데이터셋이 새로 추가한 videos/subtasks.json — scenario마다 prior video를 segment 단위로 분리 + 각 segment의 ground-truth atomic instruction. 이걸 supervision으로 multi-turn compound trajectory 학습.
- 858 scenarios × 평균 3.3 test = 2,793 multi-turn sample
- 한 sample = (system prompt) + N개 chunk turn (per-chunk atomic) + (final query) → (target atomic recall)
- 각 chunk에 memory FIFO에 keyframe 누적 — deployment time과 정확히 동일
2 학습 — `swift sft` LoRA r=16 / α=32
2.1 Loss / token_acc curve
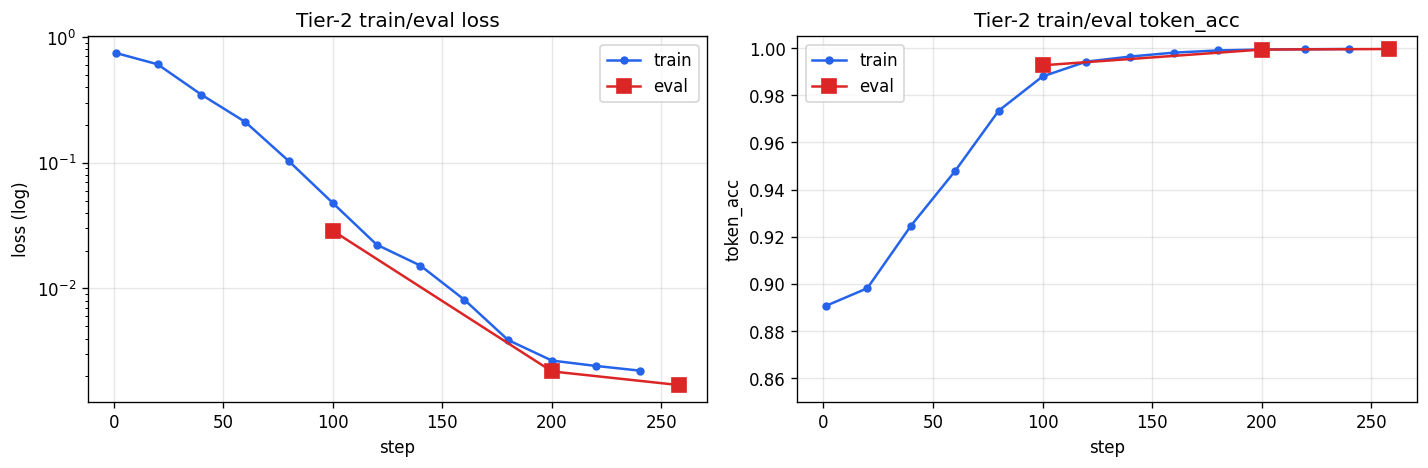
0.0111) 대비 6.5× 낮은 eval_loss. multi-turn + memory recall task가 훨씬 복잡함에도 불구하고 더 잘 수렴. format/token level은 거의 완벽 학습.
3 Cascade eval — fixture accuracy
3.1 Setup
- 30 scenario stratified sample (seed=42, 다양한 combo 분산)
- Cascade: MemER(Tier-2 merged) + Pi0.5(STUB mode, zero action) — memory_success는 stub이라 0/30 (이건 측정 불가, 다음 단계는 진짜 Pi0.5)
- 실질 metric: MemER가 final query에 emit하는
place the X in the Y의 fixture Y가 eval_spec의 ground-truth fixture와 일치하는가 - SLURM Job 2996 PREEMPTED at 1h 24m by
extraQoS → partial 10 scenario / 29 simple test 완료
3.2 Per-fixture recall
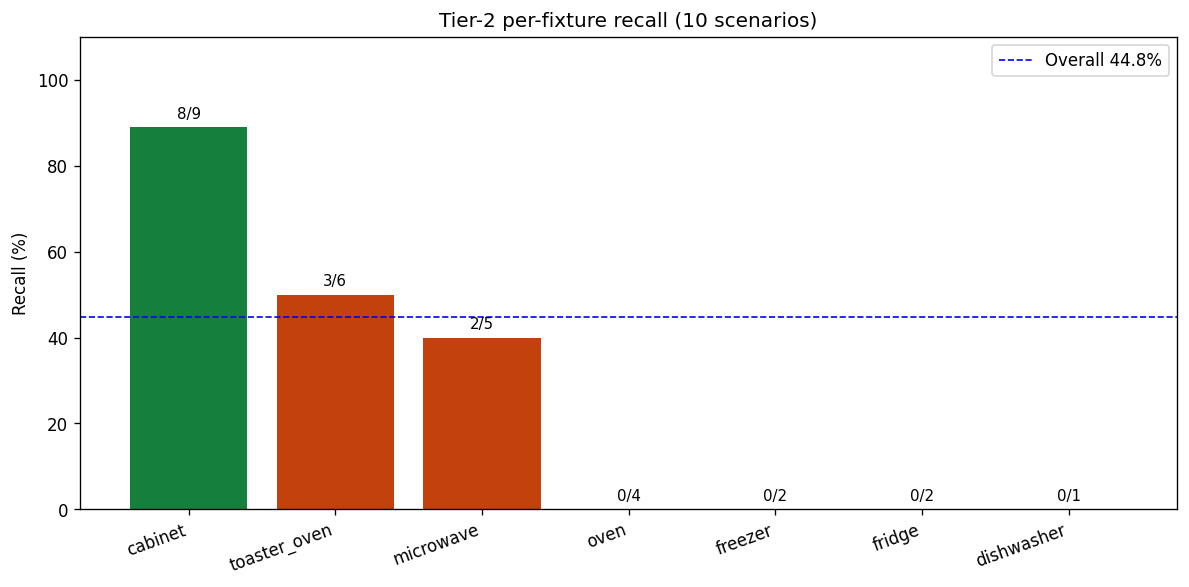
| GT fixture | correct | total | recall | 주 task family |
|---|---|---|---|---|
| cabinet | 8 | 9 | 89% | RestockBowls, FoodCleanup |
| toaster_oven | 3 | 6 | 50% | ToastBagel, ToastBaguette |
| microwave | 2 | 5 | 40% | MicrowaveThawing, SteamInMicrowave |
| oven | 0 | 4 | 0% | OvenBroilFish |
| freezer | 0 | 2 | 0% | MoveFridgeToFreezer |
| fridge | 0 | 1 | 0% | FreshProduceOrganization |
| dishwasher | 0 | 1 | 0% | LoadDishwasher |
| Total | 13 | 29 | 44.8% |
3.3 Confusion matrix
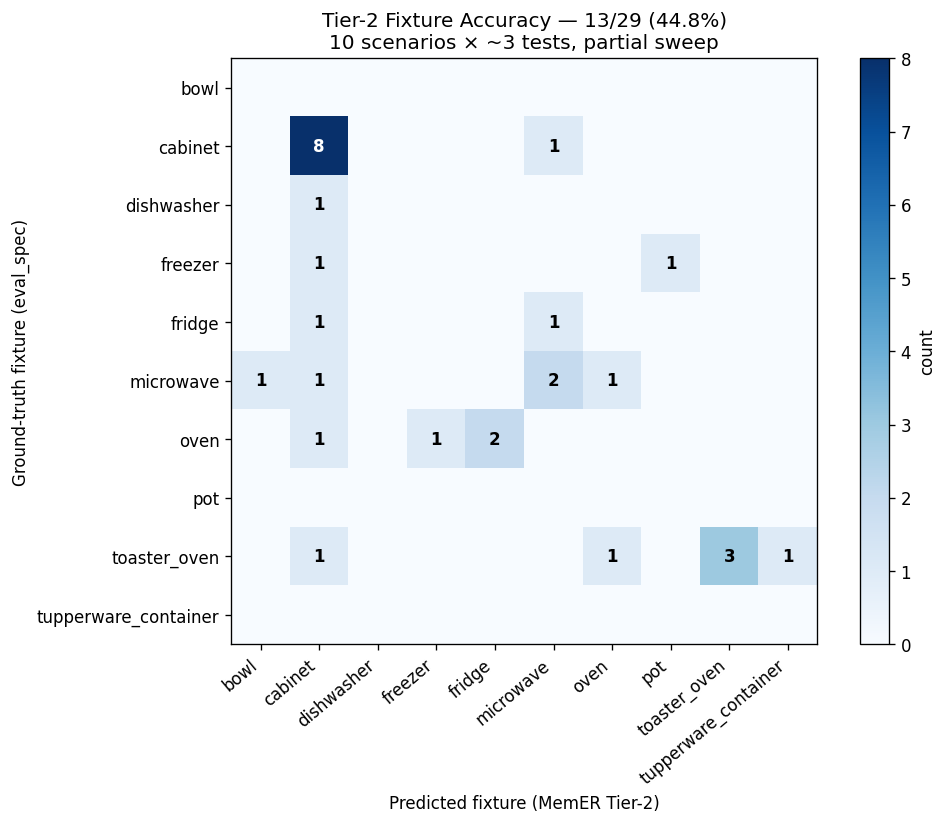
oven → fridge (2회), oven → freezer (1회). fish 관련 task에서 oven 대신 cold storage로 잘못 매핑. visual ambiguity 또는 학습 시 video 마지막 frame이 misleading. Tier-3 builder에서 fish-specific augmentation 필요.
4 Tier-1 V2 vs Tier-2 비교 (combo_002)
| Test | 정답 fixture | Tier-1 V2 출력 | Tier-2 출력 | 정답? |
|---|---|---|---|---|
| steak | freezer | pick the steak from the cabinet and place it on the counter | place the steak in the fridge | 유사 (cold) |
| bowl | cabinet | pick the bowl from the cabinet and place it on the counter | place the bowl in the cabinet | ✅ |
| fish | oven | pick the fish from the counter and place it in the microwave | place the fish in the fridge | ❌ |
- ✅ Format 정확히 매칭:
place the X in the Y(Tier-2 atomic style). Pi0.5 cascade 호환성 보장. - ✅ 1/3 fixture 정답 (V2는 0/3).
- ✅ Memory build 빨라짐 (~24s → ~14s) — multi-turn 학습으로 sticky subtask 빠르게 수렴.
- ⚠️ steak:
fridge≠freezer— cold-storage confusion (둘 다 fridge 일종으로 인식). - ⚠️ fish:
fridge≠oven— 큰 miss. memory에서 fish가 oven으로 갔던 frame 회상 못 함.
5 운영 이슈 (재발 방지)
5.1 Job 2773 — TIMEOUT (4시간 한도)
30 scenario × ~2:45/test × 3 test = ~4시간 빠듯. partial JSON 저장 없어서 87 memory build 정보만 stdout으로 회수. → JSON checkpoint 추가.
5.2 Job 2996 — PREEMPTED at 1h 24m
--qos=extra 는 own jobs에 의해 강제 cancel. 10/30 완료 후 종료. partial JSON 저장이 덕분에 데이터 보존됨 ✅ (eval_runner_local.py에 per-scenario flush + flush=True 추가).
5.3 다음 sweep 추천
또는 858 전체에서 100 scenario subset으로 population 추정.
6 Takeaway + Next
Takeaway
- Tier-2 학습 자체는 성공. Token-level loss 측면에서 거의 완벽 (eval_token_acc 99.96%). Format 100% 정확.
- Fixture accuracy 44.8% — Tier-1 V2 (33%) 대비 의미있는 진전. RestockBowls/cabinet 89%로 dominant case는 잘 잡음.
- Rare fixture가 약점. oven/freezer/dishwasher 0%. 원인: 학습 데이터 imbalance (cabinet 47%) + visual ambiguity (cold-storage). Tier-3에서 fixture-balanced augmentation 필요.
- memory_success는 stub mode라 측정 불가. 진짜 metric은 real Pi0.5 cascade에서만.
Next priorities
- P0: 30 scenario sweep 마저 완료 (
--qos=own --time=6:00:00) → fixture accuracy CI 좁힘 - P1: 진짜 Pi0.5 cascade 검증 (
PI05_STUB=0) → memory_success 정량 - P2: Tier-3 augmentation — fixture-balanced sample (oven/freezer/dishwasher × 3-5배) + per-fixture validation
- P3: 858 전체 SLURM batch (병렬 4-8 worker, 1 scenario per worker)