TL;DR
- 델타는 "이동량"이 아니다.
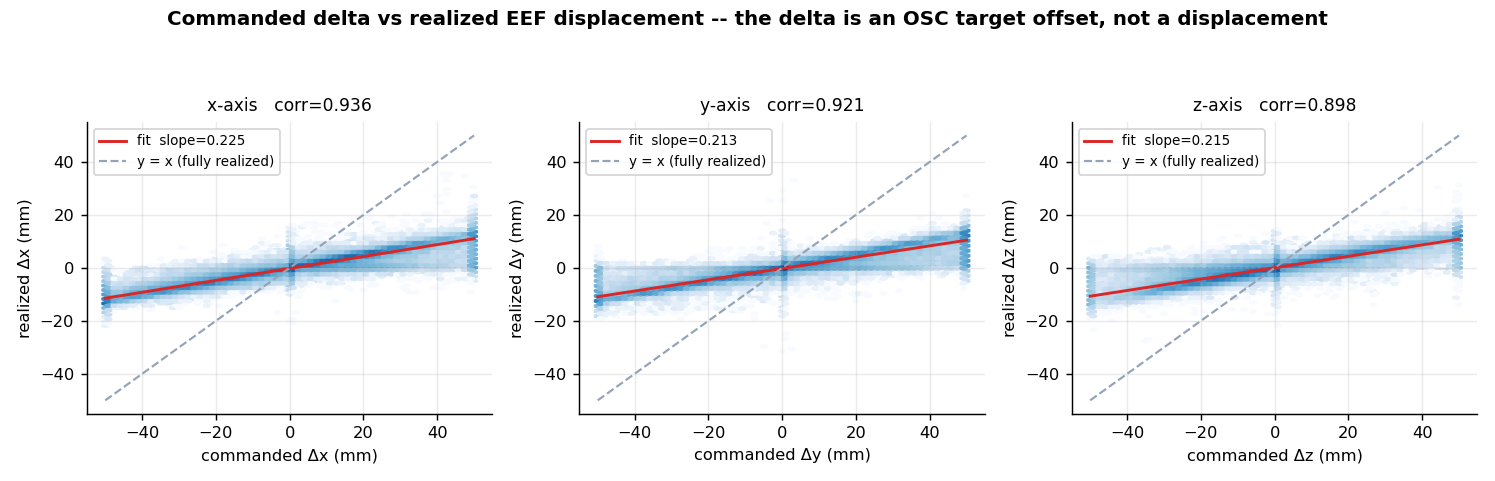
base frame기준 정규화 목표 오프셋(×0.05 m / ×0.5 rad)이고, OSC 컨트롤러가 한 스텝에 실현하는 비율은 0.213~0.225. - 분포가 정규분포가 아니다. Δpos는 21~34%가 정확히 0(스페이스마우스 데드존), 2~5%가 ±1 포화. Δrot은 46~52%가 정확히 0. 0에 델타 스파이크 + 넓은 꼬리 + 양끝 포화의 3-모드 신호.
- 실전 함정 LIBERO
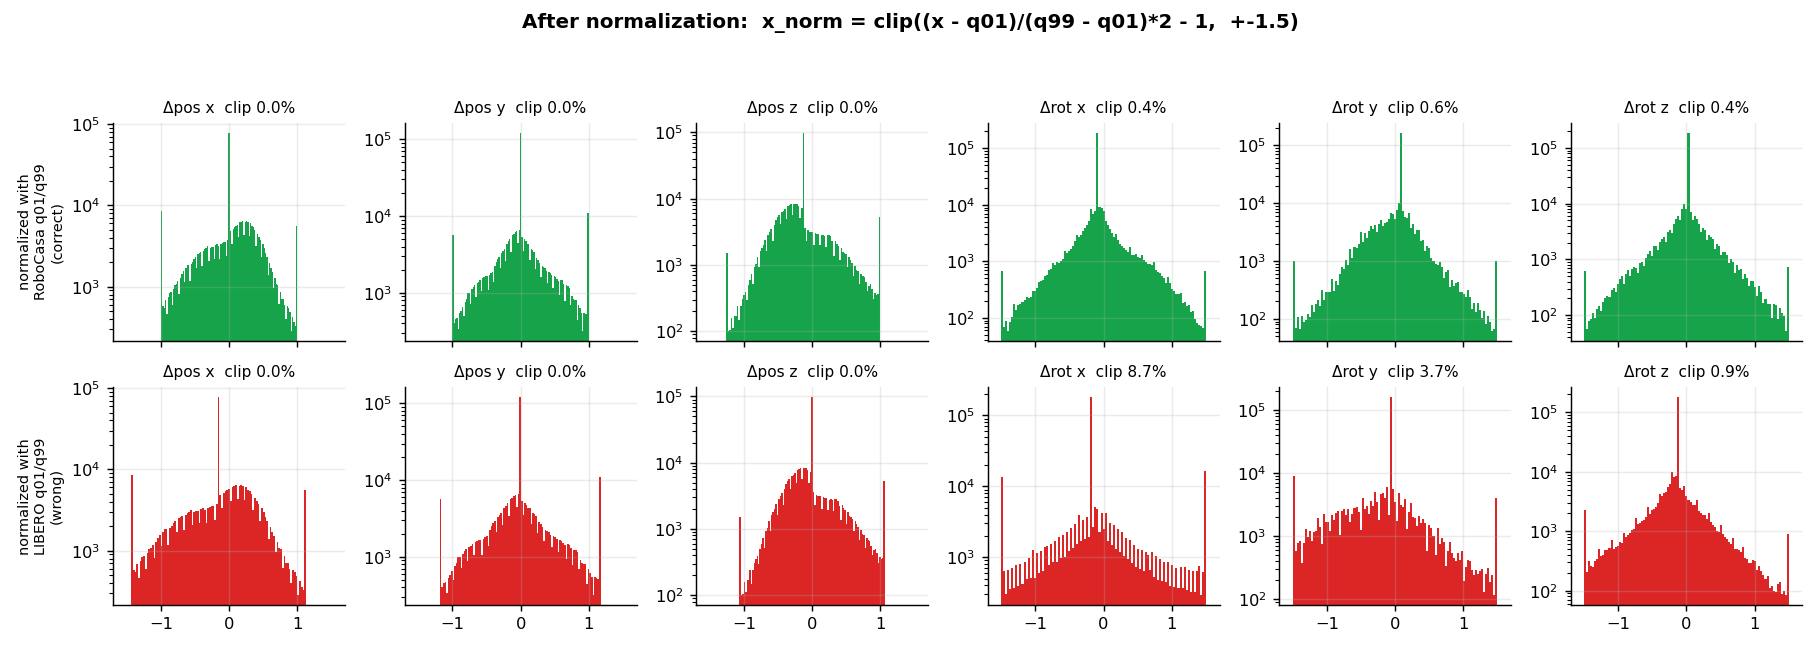
norm_stat을 그대로 쓰면 Δrot x의 8.7%, Δrot y의 3.7%가 clip된다. RoboCasa 실측값으로 갈면 0.4~0.6%. - 실전 함정 RoboTwin식
get_relative_pose를 RoboCasa에 그대로 쓰면 위험. 세그먼트 시작 대비 회전이 median 60.6°, p95 169°라서 relative quat의 11.4%가 w<0 — 사원수 double-cover 불연속. - 바로 붙여넣을 수 있는 Option A / Option B
norm_stat실측값을 §8에 정리. - 재조사 정정 이후 데이터 재조사에서 779 GB RoboCasa v0.1 원본(human 1,437 eps + MimicGen 70,513 eps)을 발견. 이 리포트의 3가지 결론이 바뀝니다 — §0 참조.
0 재조사 정정 — 이 리포트가 놓쳤던 것
이 리포트를 쓴 뒤 데이터를 다시 조사해 779 GB RoboCasa v0.1 원본을 찾았습니다. 위치는 /home/nas_main/minhopark/datasets/robot/robocasa/v0.1 (다른 사용자 홈, read-only). 아래 결론들이 바뀝니다.
발견 — 사용 가능한 데이터가 58배 더 있었다
| 종류 | 파일 | 데모 | 프레임 | 크기 | 해상도 · 카메라 |
|---|---|---|---|---|---|
| v0.1 Human (gentex) | 26 | 1,437 | 535,665 | 20 GB | 128×128 · 3 cam |
| v0.1 MimicGen (gentex) | 24 | 70,513 | 19,636,669 | 816 GB | 128×128 · 3 cam |
| (참고) X-WAM-RoboCasa | — | 1,235 | 341,017 | 5.2 GB | 256×256 · 3 cam |
카메라 키는 robot0_agentview_left_image / robot0_agentview_right_image / robot0_eye_in_hand_image로, robocasa_human_lerobot의 3개 이미지 키와 정확히 대응합니다. MimicGen은 태스크당 3,000 데모 / 파일당 ~35 GB.
정정 1 — actions_abs는 v0.5부터가 아니라 v0.1에도 있다
§2에서 "v0.5부터 actions_abs가 별도 존재"라고 썼는데 틀렸습니다. 제가 확인한 건 state-only demo.hdf5였고, 렌더링된 gentex 파일에는 v0.1부터 들어 있습니다.
정정 2 — actions_abs와 X-WAM left_ee_pos는 의미가 다르다
| 표현 | 검증 | 의미 |
|---|---|---|
X-WAM actions.left_ee_pos[t] | == proprios.left_ee_pos[t+1], 오차 0 | 실제 도달한 상태 |
RoboCasa actions_abs[:, :3] | base_to_eef_pos[t]와 최대 편차 정확히 0.0500 = OSC output_max | 명령된 목표 pose (현재 + delta×0.05) |
두 표현을 혼용하면 안 됩니다. RoboCasa 원본으로 Option B를 구성한다면 actions_abs(명령)가 아니라 obs.robot0_base_to_eef_pos/quat(실제 상태)를 써야 X-WAM과 같은 의미가 됩니다.
정정 3 — rot_6d가 이미 들어 있어 §8의 사원수 문제가 사라진다
§8에서 Option B의 결정적 위험으로 "relative quat의 11.4%가 w<0 → double-cover 불연속"을 지적했습니다. 그런데 RoboCasa action_dict가 이미 이렇게 저장하고 있습니다:
get_relative_pose를 quat 대신 rot_6d 기반으로 다시 쓰면 double-cover 문제가 원천적으로 사라집니다. 차원은 pos 3 + rot_6d 6 + grip 1 = 10. Option B의 유일한 기술적 장애물이 데이터 안에서 이미 해결돼 있었습니다.정정 4 — §5의 "0 스파이크"는 human 텔레옵 아티팩트일 뿐이다
같은 태스크(PnPCounterToCab)에서 human 54 demo와 MimicGen 200 demo를 비교했습니다.
| 소스 | 정확히 0 (Δpos x/y/z) | 정확히 0 (Δrot x/y/z) | ±1 포화 (Δpos) | ||||
|---|---|---|---|---|---|---|---|
| Human | 22.6% | 45.0% | 15.6% | 58.9% | 41.0% | 53.6% | 5.6 / 0.1 / 4.1% |
| MimicGen | 0% | 0% | 0% | 0% | 0% | 0% | 3.3 / 2.6 / 3.2% |
부수 발견 — 216×384+depth 리렌더 결과물은 삭제되었다
robocasa/claude/context.md에 "sealed 24/24 완료", 출력 ~/Datasets/robocasa/v0.1_216x384_depth{,_sealed}/로 기록돼 있으나 해당 디렉토리가 존재하지 않습니다. ~/recovered_logs/ADMIN_SNAPSHOT_RECOVERY_REQUEST.md에 따르면 2026-06-06 20:05–21:17 UTC rm -rf 사고로 12 TB가 삭제되어 GPFS 스냅샷 복구를 요청한 상태이고, 제안된 _restore 경로도 없습니다. 재생성 파이프라인(scripts/run_preprocess.sh, dataset_states_to_obs_depth.py, utils/seal_arena.py)은 남아 있습니다.
robocasa/claude/context.md)를 먼저 읽는 것이 빠르고 정확했습니다. 원본 경로와 출력 경로가 그 한 파일에 다 적혀 있었습니다.1 무엇을 어디까지 봤나
보유 RoboCasa 데이터 5곳을 전부 열고, 학습 신호가 될 액션을 샘플링 없이 전수로 뽑아 분포·표현·정규화 영향까지 계산했습니다.
| 경로 | 크기 | 포맷 | 에피소드 | 프레임 | 이 분석에서 |
|---|---|---|---|---|---|
~/Datasets/X-WAM-RoboCasa | 5.2G | X-WAM json+mp4 | 1,235 | 341,017 | 주 분석 대상 (액션 339,782행 전수) |
~/Dataset/robocasa_human_lerobot | 6.4G | LeRobot v2.0 | 410 /1,382 | 118,113 | 액션 12-dim + state 25-dim 전수 (교차 검증) |
~/Datasets/robocasa_xwam | 1.6G | X-WAM json+mp4 | 1,320 | 365,201 | 길이 분포 비교 |
~/Datasets/robocasa_lerobot_cams | 690M | npz | — | — | 카메라 T/K. 액션 없음 — 제외 |
~/repos/Robotics/robocasa/datasets/v0.1 | 2.3G | 원본 hdf5 | 31 파일 | — | 액션 규격 정본 확인용 (state-only) |
/home/nas_main/minhopark/.../robocasa/v0.1 | 779G | gentex hdf5 | 1,437 + 70,513 | 536K + 19.6M | §0에서 뒤늦게 발견 — 이 §5~§8 분석에는 미포함 |
norm_stat과 분포 분석을 해당 데이터로 다시 뽑아야 합니다.robocasa_human_lerobot은 meta가 1,382 에피를 선언하는데 디스크엔 410개만 있습니다. X-WAM은 1,235개 완전본에 256×256 mp4, 그리고 델타·절대 pose 두 표현을 모두 갖고 있습니다.2 표현 체계 총람 — 같은 궤적을 표현하는 4가지 방법
RoboCasa 계열 데이터에는 같은 로봇 움직임에 대한 서로 다른 4가지 수치 표현이 들어 있습니다. 무엇을 학습 타깃으로 삼느냐에 따라 값의 성질이 완전히 달라집니다.
| 표현 | 어디에 | 차원 | abs / rel | 기준 | 실측 범위 | 성질 |
|---|---|---|---|---|---|---|
① 정규화 델타raw_actions | X-WAM actions.raw_actionshdf5 actions[:, :7] | 7 | relative | base frame | [-1, 1] 고정 | bang-bang, 0 스파이크, 고주파 |
② 절대 EE poseleft_ee_pos/rotm | X-WAM proprios / actions | 3 + 9 | absolute | base frame | pos q01 [-0.259, -0.607, 0.073] q99 [0.730, 0.587, 0.972] (m) | 매끄러움, 씬 의존 |
③ 세그먼트 상대 poseget_relative_pose | ②에서 계산 (RoboTwin 경로) | 3 + 4 | rel-to-start | 세그먼트 첫 프레임 | pos q01 [-0.506, -0.603, -0.524] q99 [0.483, 0.591, 0.376] (m) | 매끄러움, 0 시작. quat 부호 불연속 |
④ 원본 12-dimactions | hdf5 / human_lerobot | 12 | ①+base/torso/mode | base frame | [-1, 1] | 7:12는 98~100% 무효 |
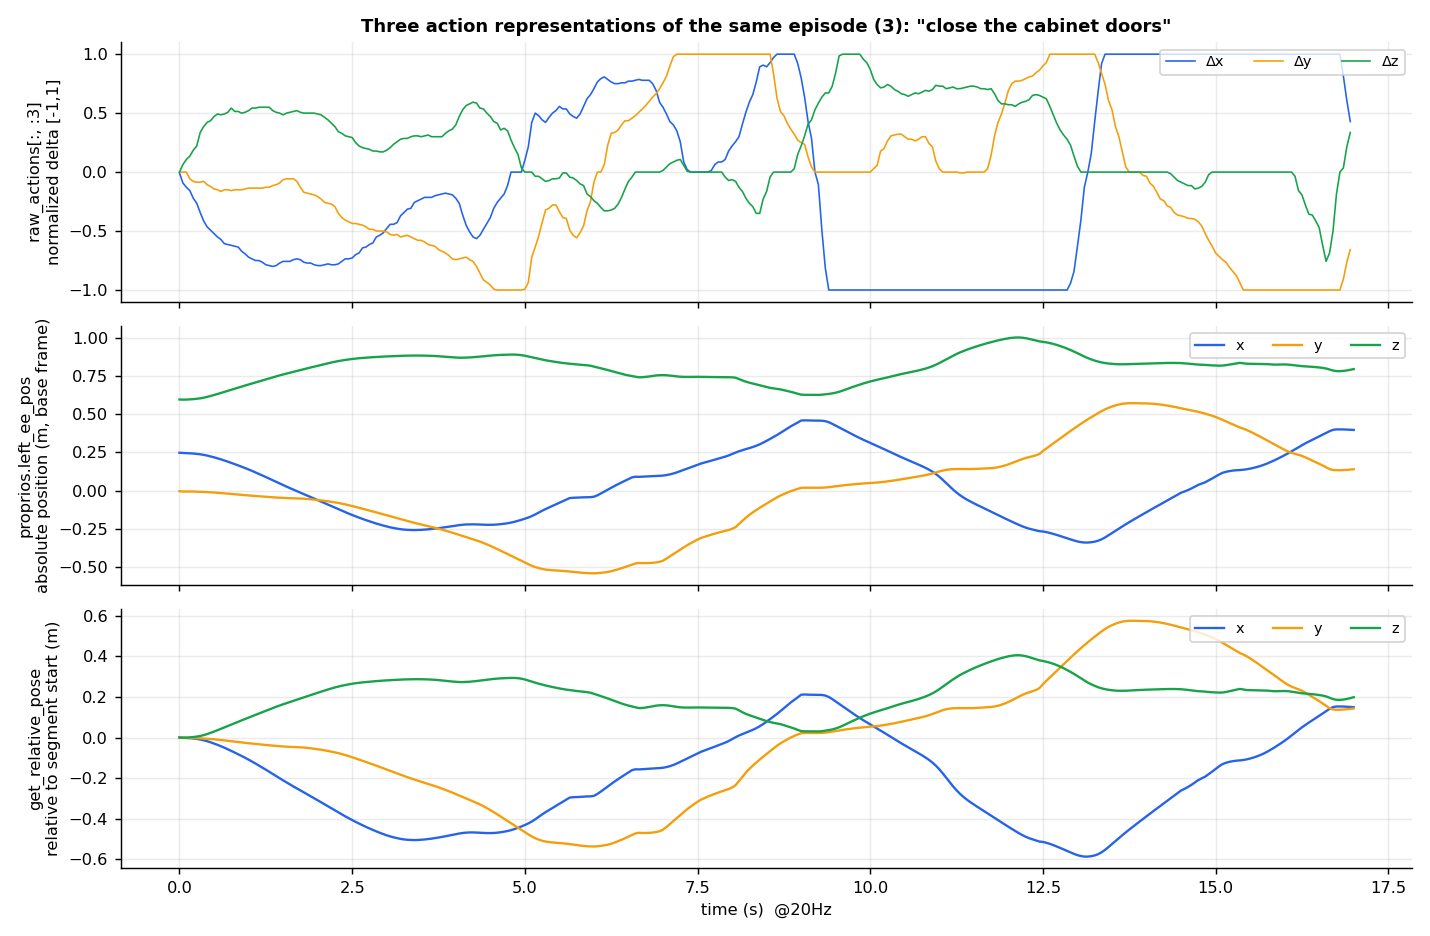
X-WAM의 ②는 특이한 성질이 있습니다 — actions.left_ee_pos[t]가 proprios.left_ee_pos[t+1]과 오차 0으로 일치합니다. 즉 "다음 프레임의 절대 pose"를 액션으로 정의한 것이고, 이는 명령이 아니라 실제로 도달한 상태입니다. ①(명령)과 ②(결과)의 관계가 §5의 실현율 0.22입니다.
3 액션 12-dim 정본 규격
인덱스 정본은 robocasa/utils/lerobot_utils.py:65-69의 ACTION_KEY_ORDERING_HDF5, 물리 스케일은 robosuite/controllers/config/robots/default_pandaomron.json입니다.
| idx | 내용 | abs / rel | 기준 프레임 | 정규화 | 실물 환산 | X-WAM 존재 |
|---|---|---|---|---|---|---|
| 0:3 | EEF position | delta | base | [-1, 1] | × 0.05 m | ✅ |
| 3:6 | EEF rotation (axis-angle) | delta | base | [-1, 1] | × 0.5 rad | ✅ |
| 6 | gripper_close | 명령 | — | ±1 이진 | +1 닫기 / −1 열기 | ✅ |
| 7:10 | base x / y / yaw | 속도 | base | [-1, 1] | × 0.5 rad/s | ❌ |
| 10 | torso | 관절 위치 | — | [-1, 1] | × 0.05 | ❌ |
| 11 | control_mode | 플래그 | — | ±1 | +1 = base 모드 | ❌ |
part_controller_config dict 조립 순서(right → torso → base → right_gripper)대로면 torso가 idx 6이어야 하는데, 실제 데이터는 idx 6이 gripper입니다. 위 표는 데이터 기준으로 재확정한 것입니다 (§4 근거).4 각 채널을 수치로 어떻게 확정했나
| dim | 검증 방법 | 결과 | 결론 |
|---|---|---|---|
| 6 | gripper_qpos 평균 비교 (5프레임 지연 포함) | +1 → 0.0208 / −1 → 0.0387 (Panda 개방 최대 0.04) | gripper |
| 7 / 8 / 9 | base frame Δx / Δy / Δyaw 상관 | +0.899 / +0.931 / +0.991 | forward / lateral / yaw |
| 7:11 | dim11(mode)과 동시발생 | non-zero 프레임의 100%가 mode == +1 | base 모드 전용 |
| 10 | 희소성 + 값 분포 | 118,113 중 0.07%만 non-zero, 값 −0.5~−0.67 연속 | torso |
| state 11:18 | q_base⁻¹ ⊗ q_eef_world 손계산 | 소수점 4자리까지 일치 | base_to_eef pose |
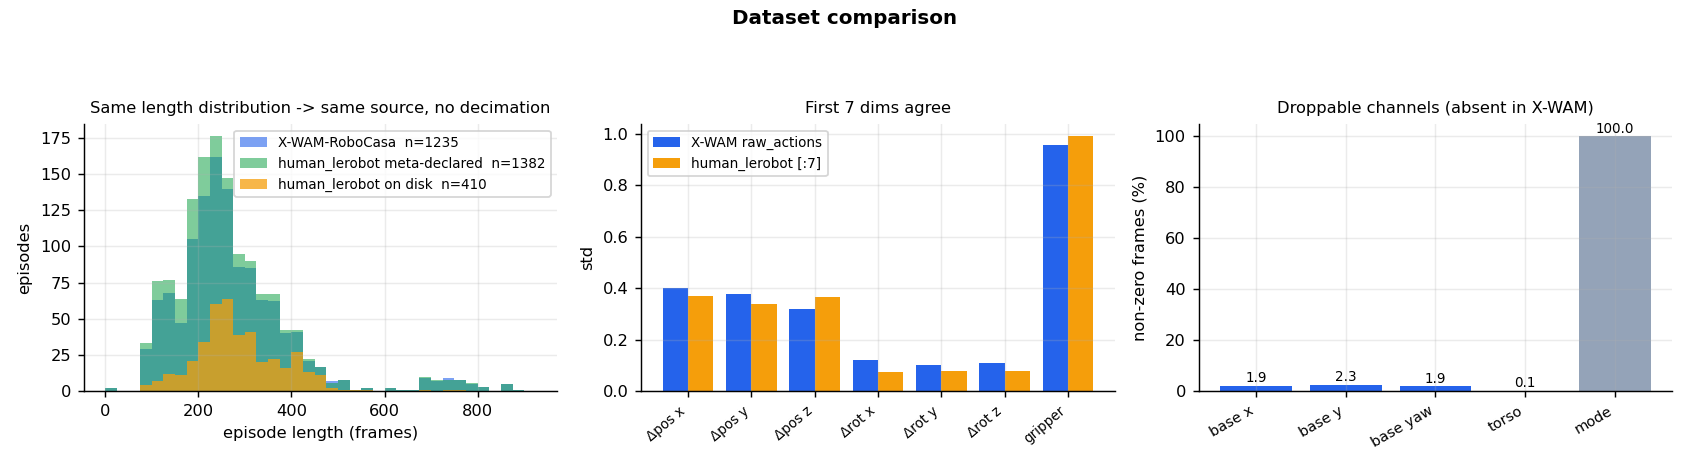
human_lerobot의 meta 선언(1,382)과 X-WAM(1,235)의 길이 분포가 겹친다 — 같은 원본 demo pool, 데시메이션 없음. 디스크의 410개(주황)는 그 부분집합. 가운데: 앞 7-dim 표준편차 비교 — Δpos는 거의 동일하나 Δrot은 X-WAM이 1.4배 크다(task 구성 차이). 오른쪽: base 3축은 프레임의 1.9~2.3%, torso는 0.07%만 non-zero — 버려도 되는 채널이고, X-WAM엔 아예 없다.norm_stat은 실제 학습에 쓸 데이터셋에서 다시 뽑아야 하고, 두 세트를 섞을 거면 합쳐서 계산해야 합니다.5 실측 값 분포 — X-WAM raw_actions 전수 339,782 프레임
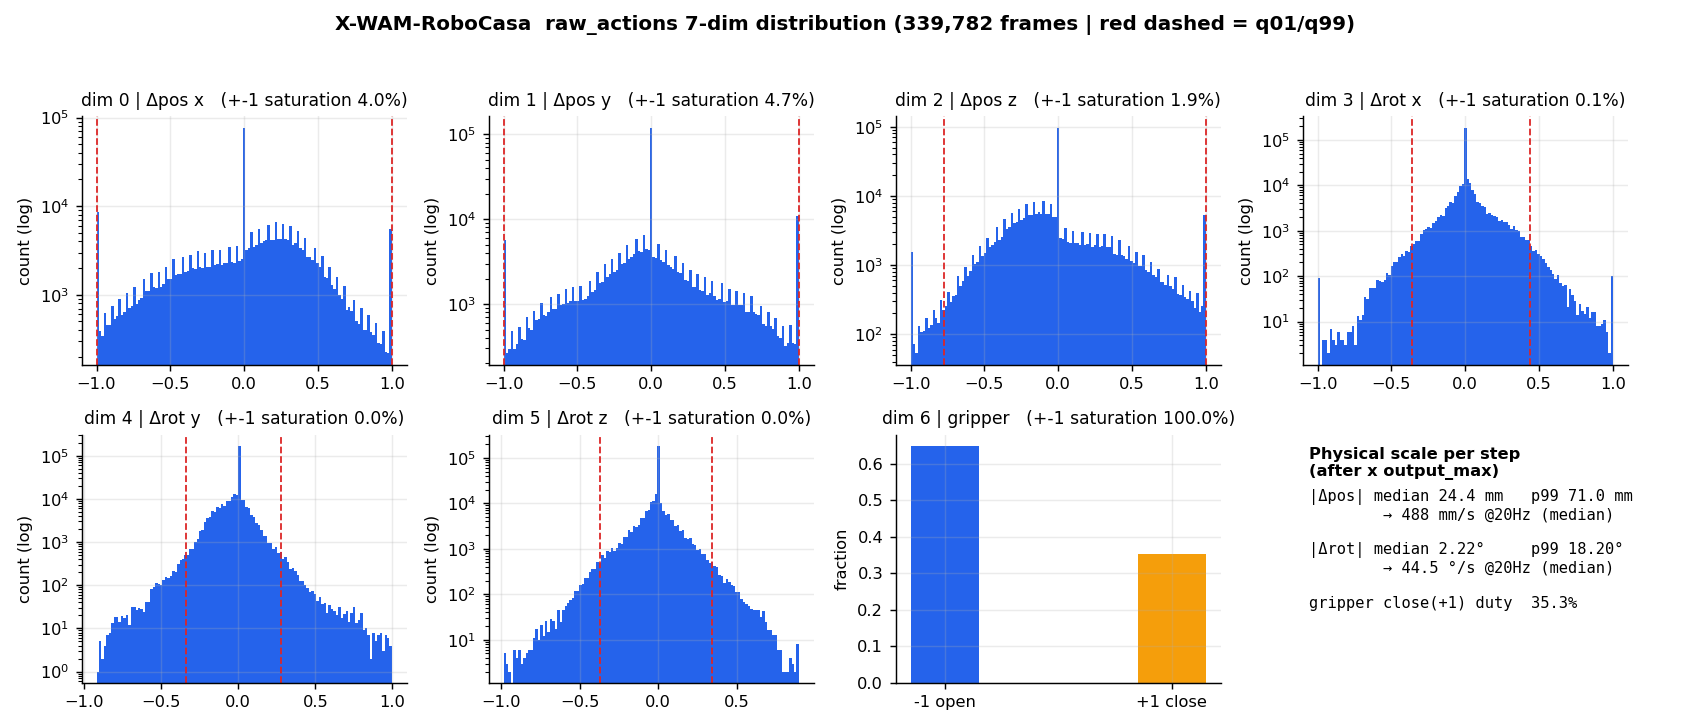
| d | 이름 | min | q01 | q05 | q25 | q50 | q75 | q95 | q99 | max | mean | std | 정확히 0 | ±1 포화 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | Δpos x | -1.000 | -1.000 | -0.757 | -0.150 | -0.000 | 0.271 | 0.643 | 1.000 | 1.000 | 0.022 | 0.400 | 21.8% | 3.97% |
| 1 | Δpos y | -1.000 | -1.000 | -0.671 | -0.114 | -0.000 | 0.093 | 0.779 | 1.000 | 1.000 | 0.007 | 0.376 | 34.1% | 4.75% |
| 2 | Δpos z | -1.000 | -0.771 | -0.500 | -0.200 | -0.000 | 0.021 | 0.607 | 1.000 | 1.000 | -0.022 | 0.320 | 27.5% | 1.94% |
| 3 | Δrot x | -1.000 | -0.360 | -0.163 | 0.000 | -0.000 | 0.006 | 0.237 | 0.440 | 1.000 | 0.010 | 0.123 | 52.3% | 0.05% |
| 4 | Δrot y | -0.920 | -0.337 | -0.194 | -0.037 | -0.000 | -0.000 | 0.114 | 0.280 | 0.997 | -0.019 | 0.102 | 46.5% | 0.00% |
| 5 | Δrot z | -0.986 | -0.371 | -0.186 | -0.011 | -0.000 | -0.000 | 0.157 | 0.343 | 0.897 | -0.006 | 0.108 | 51.5% | 0.00% |
| 6 | gripper | -1.000 | -1.000 | -1.000 | -1.000 | -1.000 | 1.000 | 1.000 | 1.000 | 1.000 | -0.295 | 0.956 | 0.0% | 100% |
이 분포가 학습에 갖는 의미 — 3가지
① 0 스파이크 (데드존)
Δpos 21.8~34.1%, Δrot 46.5~52.3%가 정확히 0. 스페이스마우스 텔레옵의 데드존 때문. 연속 분포가 아니라 이산 원자(atom) + 연속 꼬리의 혼합이다. flow-matching으로 이런 원자를 재현하는 건 원래 어렵고, 정규화가 0을 정확히 0으로 보내지 않으면 더 어려워진다.
② ±1 포화 (bang-bang)
Δpos가 프레임의 2~5%에서 정확히 ±1. Figure 1 위 패널을 보면 수 초 동안 ±1에 붙어 있는 구간이 있다. 즉 시연자가 최대 속도로 밀고 있었다는 뜻이고, 이 구간에서 액션은 정보량이 낮다(포화됨).
③ 그리퍼는 거의 정보가 없다
항상 ±1이고, 에피소드당 부호 전환이 평균 1.39회뿐. 닫힘(+1) 듀티 35.3%. 채널 하나가 사실상 에피소드당 1~2비트만 나른다 — 하지만 그 1~2비트가 태스크 성공을 좌우한다.
물리 단위 환산
|Δpos| median 24.4 mm/step, p99 71.0 mm → 20 Hz에서 median 488 mm/s 명령.|Δrot| median 2.22°/step, p99 18.2° → median 44.5 °/s.
실현치는 여기에 ×0.22 (§6).
6 명령 vs 실현 — 델타를 적분하면 안 되는 이유
raw_actions[:, :3] × 0.05(명령 변위)와 실제 left_ee_pos 프레임 간 변위를 회귀했습니다.
7 시간 구조 — frame_stride를 얼마로 둘 것인가
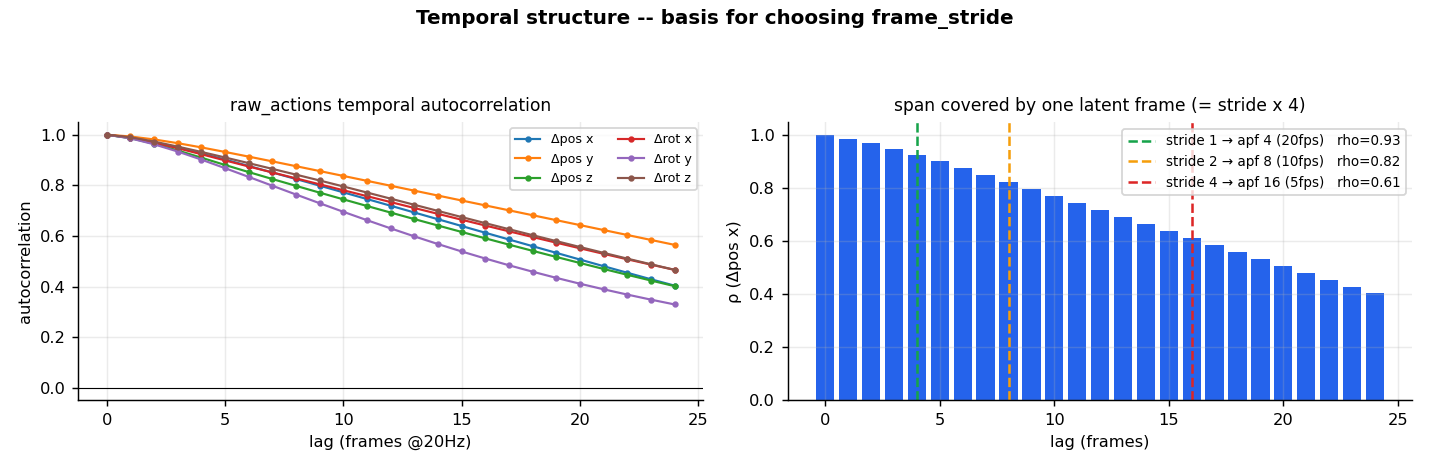
LingBot에서 action_per_frame = frame_stride × 4이고, latent frame 하나가 원본 stride×4 프레임을 덮습니다. 그 간격에서 액션이 얼마나 상관을 유지하는지 봤습니다.
| stride | 영상 fps | action_per_frame | latent frame 간 ρ | 대응 LingBot cfg | 평가 |
|---|---|---|---|---|---|
| 1 | 20 | 4 | 0.93 | va_libero_cfg | README 권장(5–15fps) 초과, 시퀀스 2배 |
| 2 | 10 | 8 | 0.82 | va_demo_cfg | 권장 — 권장 범위 중앙, 정보 손실 미미 |
| 4 | 5 | 16 | 0.61 | va_robotwin_cfg | 시퀀스 최단이나 동작 디테일 손실 우려 |
_action_post_process는 액션 배열에 stride를 적용하지 않습니다(required_action_num = latent_frame_num × frame_stride × 4). 영상만 2배 다운샘플되고 액션은 20 Hz 전량이 들어갑니다.8 정규화가 값에 하는 일 — 가장 실전적인 부분
LingBot은 lerobot_latent_dataset.py:279-281에서 이렇게 정규화합니다:
즉 norm_stat이 틀리면 값이 조용히 잘려나갑니다. LIBERO의 norm_stat을 그대로 두고 RoboCasa를 학습시키면 어떻게 되는지 실제로 계산했습니다.
| 채널 | RoboCasa stat 사용 시 clip | LIBERO stat 사용 시 clip | 배수 |
|---|---|---|---|
| Δpos x / y / z | 0.0% / 0.0% / 0.0% | 0.0% / 0.0% / 0.0% | — (스케일만 어긋남) |
| Δrot x | 0.36% | 8.74% | 24× |
| Δrot y | 0.55% | 3.71% | 6.7× |
| Δrot z | 0.35% | 0.86% | 2.5× |
Option A — LIBERO 경로 (raw_actions[:, :7] 그대로)
가장 단순합니다. env_type='none', 코드 변경 없음. 아래는 X-WAM 1,235 에피 전수 실측값입니다.
Option B — RoboTwin 경로 (get_relative_pose)
raw action을 [rel_pos(3), rel_quat(4), gripper(1)] 8열로 만들고 get_relative_pose를 태우는 방식. RoboTwin 관례대로 quat 채널은 ±1 고정, pos만 데이터 분위수를 씁니다.
- 세그먼트 시작 대비 회전각이 median 60.6°, p95 169.4°, max 180°로 매우 큽니다.
- 그 결과 relative quat의 11.4%에서 w < 0이 됩니다.
q와−q는 같은 회전인데 네트워크에는 정반대 벡터로 보입니다. get_relative_pose(lerobot_latent_dataset.py:55-68)는 부호 정규화를 하지 않습니다. RoboTwin은 세그먼트가 짧아 문제가 드러나지 않았을 가능성이 큽니다.- Option B로 간다면
relative_quat *= np.sign(relative_quat[:, 3:4])같은 canonicalization을 반드시 넣거나, 세그먼트를 짧게 쪼개야 합니다.
lingbot-va-posttrain-libero-long 체크포인트와 액션 레이아웃이 동일해 warm start도 가능합니다. Option B는 Figure 1에서 보듯 신호가 훨씬 매끄러워 장기 시퀀스에 유리하지만, quat 부호 문제를 먼저 해결해야 합니다.9 robocasa_human_lerobot 원본 12-dim & state 25-dim
액션 12-dim 전수 실측 (118,113 프레임)
| d | 이름 | min | q01 | q50 | q99 | max | std | 정확히 0 |
|---|---|---|---|---|---|---|---|---|
| 0 | Δpos x | -1.000 | -1.000 | 0.000 | 0.914 | 1.000 | 0.371 | 27.3% |
| 1 | Δpos y | -1.000 | -1.000 | 0.000 | 1.000 | 1.000 | 0.339 | 37.4% |
| 2 | Δpos z | -1.000 | -0.771 | 0.000 | 1.000 | 1.000 | 0.366 | 22.5% |
| 3 | Δrot x | -1.000 | -0.257 | 0.000 | 0.243 | 1.000 | 0.076 | 64.5% |
| 4 | Δrot y | -0.806 | -0.260 | 0.000 | 0.249 | 0.963 | 0.081 | 54.6% |
| 5 | Δrot z | -0.797 | -0.257 | 0.000 | 0.271 | 0.786 | 0.080 | 57.1% |
| 6 | gripper | -1.000 | -1.000 | -1.000 | 1.000 | 1.000 | 0.989 | 0.0% |
| 7 | base x | -1.000 | 0.000 | 0.000 | 0.171 | 1.000 | 0.071 | 98.1% |
| 8 | base y | -1.000 | -0.300 | 0.000 | -0.000 | 0.893 | 0.089 | 97.7% |
| 9 | base yaw | -0.843 | 0.000 | 0.000 | 0.003 | 0.529 | 0.048 | 98.1% |
| 10 | torso | -0.671 | 0.000 | 0.000 | 0.000 | 0.000 | 0.012 | 99.9% |
| 11 | mode | -1.000 | -1.000 | -1.000 | 1.000 | 1.000 | 0.334 | 0.0% |
회색 행(7:12)은 버려도 되는 채널입니다 — 97.7~99.9%가 0이고, X-WAM엔 아예 없습니다.
state 25-dim (문서 없음 → 사원수 역산으로 확정)
검증: q_base⁻¹ ⊗ q_eef_world를 손계산해 dims 14:18과 소수점 4자리까지 일치, R_baseT(p_eef − p_base) = dims 11:14 일치. LingBot-VA는 state를 전혀 사용하지 않습니다 — 절대 pose를 재구성해 Option B로 갈 때만 필요합니다.
메타데이터 오류 fps: 10은 틀렸습니다 — 실제 20 Hz
| # | 증거 | 수치 |
|---|---|---|
| 1 | Δgripper_qpos / gripper_qvel | 0.04875 → dt = 1/20.51 s (상관 0.922). timestamp가 주장하는 0.1 s 아님 |
| 2 | 명령↔실현 기울기를 X-WAM(공식 20 fps)과 비교 | 0.22 vs 0.21 — 동일 → 행 1개 = 컨트롤 스텝 1개, 데시메이션 없음 |
| 3 | 에피소드 길이 분포 비교 (meta 선언 1,382 vs X-WAM 1,235) | min 12 / median 245 vs 250 / max 889 vs 889 |
10 Takeaway
의미
메타데이터도 소스 코드도 이 데이터에 대해 한 번씩 틀렸습니다. fps 필드가 실제의 절반을 가리켰고, robosuite의 컨트롤러 조립 순서는 gripper와 torso를 뒤바꿔 놓았습니다. 둘 다 학습은 정상적으로 돌면서 결과만 조용히 나빠지는 종류의 오류입니다. 값을 직접 열어보는 것 외에 방법이 없었습니다.
이 액션 신호는 다루기 쉬운 신호가 아닙니다. 절반 가까이가 정확히 0인 원자, 2~5%의 ±1 포화, 실현율 0.22 — 정규분포를 가정한 어떤 처리도 이 구조를 깨뜨립니다. 다행히 LingBot의 quantile 정규화 + ±1.5 clip은 이 분포에 적절히 맞고, 올바른 norm_stat만 넣으면 손실이 0.6% 이하로 유지됩니다.
표현 선택이 곧 난이도 선택입니다. Figure 1이 그 요약입니다 — 같은 궤적인데 델타는 bang-bang 고주파, 상대 pose는 매끄러운 저주파입니다. 다만 상대 pose는 RoboCasa의 큰 회전(median 60.6°) 때문에 사원수 부호 불연속이라는 새 문제를 들여옵니다. 공짜 점심은 없습니다.
11 Next Steps
즉시 반영 가능
va_robocasa_cfg.py를va_demo_cfg(256×256, apf 8) 베이스로 생성 — §8의 Option A 블록을 그대로 복사- 학습 데이터를 X-WAM-RoboCasa로 확정 (1,235 eps 완전본, 256×256 mp4)
결정 필요
- Option A vs B — A 권장(무변경 + warm start 가능). B는 quat canonicalization 선행 필요
- 세그먼트 분할 — median 250 / p95 496 / max 889 frames @20Hz. stride 2여도 latent frame 최대 111, 카메라 3개면 latent width 48. Option B로 간다면 세그먼트를 짧게 쪼개는 것이 회전각 문제도 같이 완화한다
- 카메라 2개 vs 3개 —
latent_width = width//16 × len(obs_cam_keys)
남은 blocker (변함없음)
- latent 추출 스크립트 — 레포에 없음.
wan_va_server.py:325-373_encode_obs를 역산해 작성..pth당 13필드 +empty_emb.pt robbyant/lingbot-va-base다운로드 — 공유 캐시에 없음lingbotenv에lerobot==0.3.3 scipy wandb --no-deps설치