2026-10-08 03:29 UTC — Analysis
사람 데모 생성 파이프라인 테스트 (RoboDojo build_tower)
agent_icl | Zero-WAM/tmp/demo_gen 방식을 RoboDojo 장면 하나에 적용
TL;DR
- 시작 프레임: 로봇 장면을 사람 책상 장면으로 바꾸는 단계는 물체 배치를 그대로 유지하며 잘 됨
- 끝 프레임: 완성된 탑을 그리게 하면 나무판과 블록을 지어냄. VLM 검수 3회 모두 탈락
- 영상: 2개 모두 부적합. 하나는 블록 하나만 들고 끝나고, 하나는 탑이 통째로 나타남
1/1
시작 프레임
0/3
끝 프레임 검수
0/2
쓸 만한 영상
1배경/목적
RoboDojo 태스크에는 사람 데모 영상이 없다. Zero-WAM 논문의 HumanGen 방식을 재현해 둔 Zero-WAM/tmp/demo_gen 파이프라인으로 RoboDojo용 사람 영상을 만들 수 있는지 장면 하나로 확인했다.
2작업 내용
입력은 build_tower 레이아웃 0의 로봇 head-cam 첫 프레임. 지시문은 "Build a tower using the wooden blocks and wooden boards.".
- 물체 식별과 검수:
gemini-3.1-pro-preview(Letsur 게이트웨이) - 이미지 편집: Nano Banana
gemini-3.1-flash-image(Letsur 게이트웨이), 한 손만 보이는 버전 - 영상: Wan2.1-I2V-14B, 첫·끝 프레임 지정, 81프레임 16 fps, seed 0과 1 (job 178992)
VLM이 읽은 물체: 4 white blocks, 2 long wooden boards
3결과
프레임
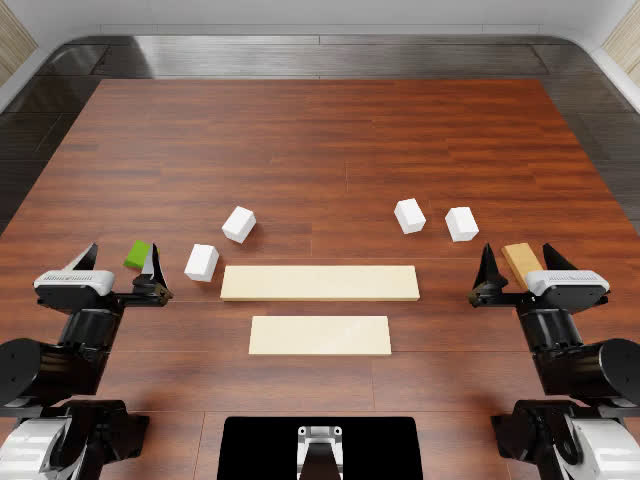
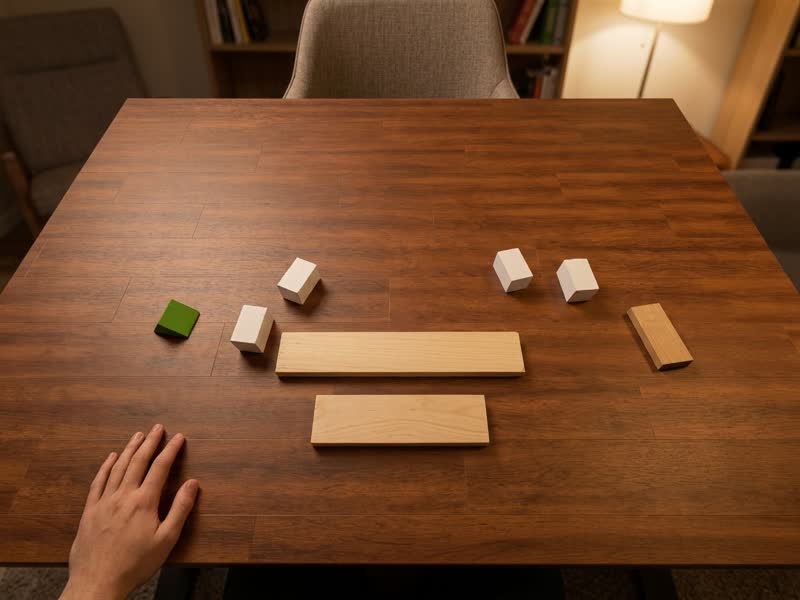
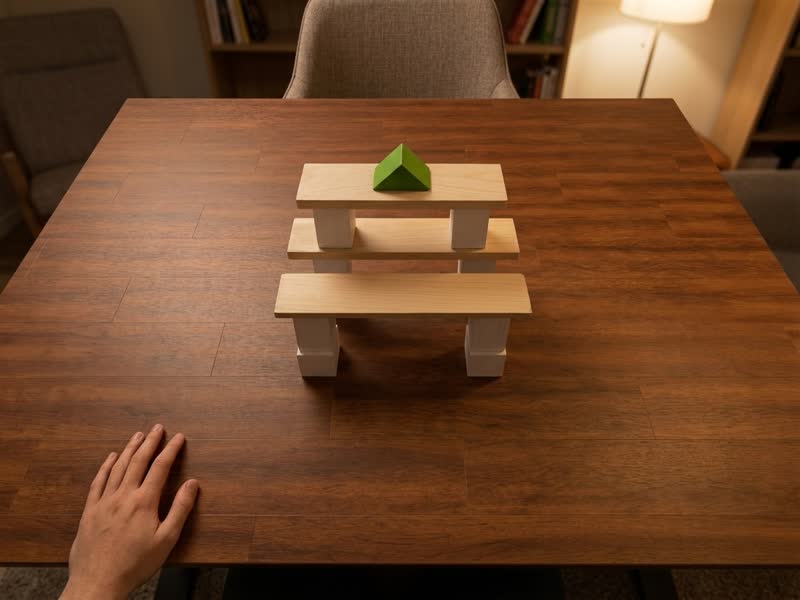
끝 프레임 검수 의견 (마지막 시도): Objects were altered (an extra board was added, the small wooden block removed, and pillar blocks changed). The tower uses three board floors instead of the two specified.
영상
10프레임 간격 요약 (위 seed 0, 아래 seed 1):


4Takeaway
이 파이프라인은 첫·끝 두 프레임 사이를 5초로 잇는 구조라 물체 하나를 옮기는 태스크용이다. 블록 4개와 판 2개를 차례로 쌓는 다단계 태스크는 한 영상에 담기지 않아, 모델이 과정을 건너뛰거나 결과를 순간이동시킨다. 이미지 편집도 복잡한 끝 상태에서는 물체 수를 지키지 못한다.
5Next
- 단계를 쪼개 한 동작씩 시작·끝 프레임과 영상을 만들고 이어 붙이기 (build_tower면 6~7구간, 하루 이상)
- 한 번 옮기면 끝나는 RoboDojo 태스크로 바꾸기 (다만 데모 효과가 안 보일 가능성)
- 사람 영상 비교는 RoboTwin 결과(4태스크 × 10 에피소드)로 답하기
frames scripts/humangen_frames_test.py (Letsur: image edit 4, VLM 4 calls)
video scripts/humangen_video_test.py (1 GPU, ~12 min)
files agent_icl/tmp/humangen_test/