T2-Z 조건에서 Long-WAM 재시도 정책 비교
TL;DR
- T2-Z와 같은 정보량(탐색 밀기 2번 + 시도 1번)에서 우리 모델은 87.3%(step 2000), 78.2%(step 3000)를 기록했다. T2-Z 논문 수치는 72.0%, 표준 월드 모델은 32.0%다.
- 탐색 밀기 없이 스스로 재시도하면 history on이 6번 안에 96.4%(53/55)를 푼다. 운 기준(history off, 매 시도 seed 변경)은 56.4%다. 첫 실패를 본 뒤 2번째 시도 성공률은 74% vs 15%다.
- 평가 중 문제를 하나 찾아 고쳤다. 밀기 전 접근을 정책이 직접 하면 그리퍼가 1cm 높게 서서 상자가 3.5배 멀리 미끄러진다(4/55). T2-Z처럼 프레임 65 전까지는 스크립트 접근을 쓰도록 바꿨다.
1 배경/목적
앞선 실험(우리가 만든 push 세팅)에서는 history on 0.84 vs 운 0.35였다. 하지만 장면, μ 범위, 행동 공간이 T2-Z와 달라 논문 수치와 직접 비교할 수 없었다. 그래서 사용자 결정(A안)대로 우리 방법을 T2-Z 조건에서 평가했다. 목표는 T2-Z 화면에 보이는 대로, 테이블 위 초록 마커로 준다.
2 세팅
| 항목 | T2-Z | 우리 |
|---|---|---|
| 장면 / 시작 / 카메라 | FrictionSimulator | 같은 코드 (import), 목표 영역만 초록 마커로 표시 |
| μ | 80-값 schedule (테스트 μ 비공개, 90 query) | 80-값 schedule × {short, medium, long} 중 T2-Z 후보로 reachable한 55개 |
| 채점 | RGB appearance tracker, 마지막 5 프레임 중앙값이 사각형 안 | 같은 코드 호출 |
| 정보량 | support action 0, 4 → 후보 10개 중 선택 | support 0, 4를 history로 보여준 뒤 1번 시도 (연속 행동) |
| 프레임 0~64 | 스크립트 접근 | 스크립트 접근 (정책은 관찰만), 65부터 정책 |
| 학습 | 35 env × 10 episode | 교사 재시도 에피소드 2000개 (30%는 support로 시작), Long-WAM libero-idm에서 3000 step |
3 결과
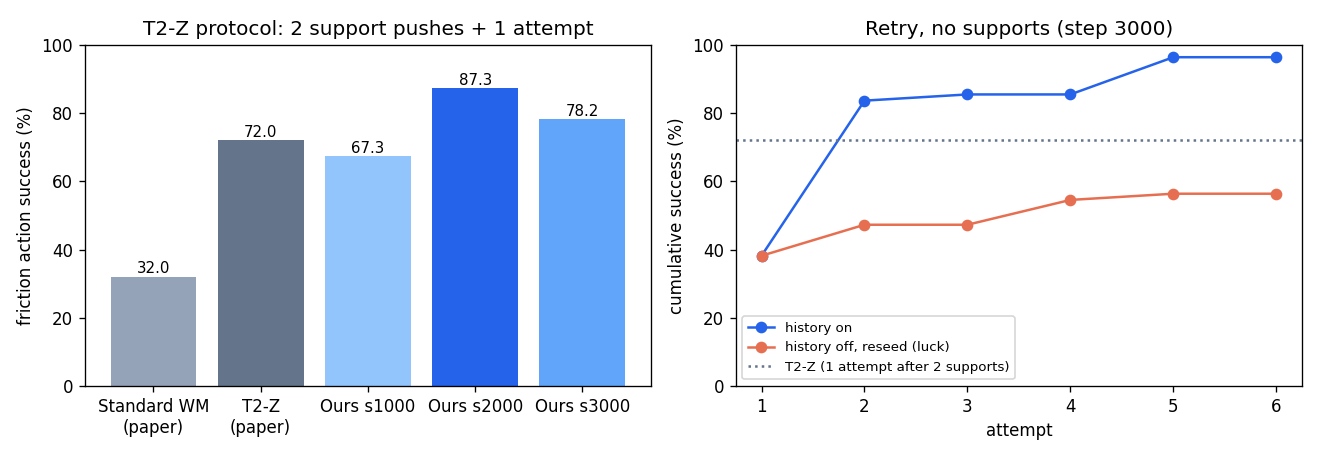
3.1 T2-Z 방식 (support 2 + 1 attempt)
| 모델 | 전체 | short (33) | medium (18) | long (4) |
|---|---|---|---|---|
| Standard WM (논문) | 32.0% | — | ||
| T2-Z (논문) | 72.0% | — | ||
| Ours step 1000 | 67.3% (37) | 27 | 6 | 4 |
| Ours step 2000 | 87.3% (48) | 31 | 13 | 4 |
| Ours step 3000 | 78.2% (43) | 28 | 11 | 4 |
3.2 재시도 (support 없음, K=6, step 3000)
| 시도 k | history on: 조건부 성공 (그 전까지 실패한 것 중) | 운 기준 |
|---|---|---|
| 1 | 21/55 (38%) | 21/55 (38%) |
| 2 | 25/34 (74%) | 5/34 (15%) |
| 3 | 1/9 | 0/29 |
| 4 | 0/8 | 4/29 |
| 5 | 6/8 | 1/25 |
| 6 | 0/2 | 0/24 |
| 6회 내 누적 | 53/55 (96.4%) | 31/55 (56.4%) |
target별 (on / 운): short 33/33 vs 16/33, medium 16/18 vs 11/18, long 4/4 vs 4/4.
3.3 평가 중 발견한 문제: 밀기 전 접근 자세
처음 평가(step 1000, 정책이 0~105 전부 제어)는 4/55였고, 55개 전부 상자가 화면 밖으로 나갔다. 원인을 단계별로 좁혔다.
- 정책 행동을 그대로 재생하면 같은 결과(0.51 m)가 나온다. 교사가 A 0.29로 밀면 −0.05 m에서 멈춘다.
- 구간을 바꿔 끼워 보면, 교사 행동에 정책의 [0:65]를 넣었을 때 0.557 m가 나오고 [65:106]을 넣었을 때 −0.129 m가 나온다. 정책의 z 축만 넣어도 0.466 m다.
- t=65 시점에 정책 쪽 그리퍼가 1 cm 높고(z 0.9327 vs 0.9228) 0.6 cm 앞에 있다. 이 차이로 접촉 형태가 바뀌어 상자가 0.78 m 미끄러진다(교사는 0.22 m).
T2-Z도 65 이전은 항상 스크립트 접근이고, 모델의 결정은 65 이후 후보 선택뿐이다. 그래서 같은 조건(--approach scripted)으로 맞췄다. 수정 후 step 1000은 37/55가 됐다.
4 Takeaway
(1) T2-Z와 같은 장면, 같은 채점기, 같은 정보량에서 AD 방식 Long-WAM이 논문 T2-Z 수치(72.0%)보다 높은 78~87%를 냈다. 다만 T2-Z 수치는 재현이 아니라 인용이고(가중치 비공개), 우리는 목표를 화면에 표시해 주며 학습 데이터도 다르다. 그래서 "엄밀한 재현 비교"가 아니라 "같은 조건에서의 성공률 비교"다. (2) 탐색 밀기 없이 스스로 재시도할 때가 우리 방법의 본래 설정이다. 첫 실패를 본 뒤 2번째 시도 성공률이 운 기준의 5배(74% vs 15%)로, 앞선 push 세팅 결과(0.56 vs 0.08)와 같은 방향이다. (3) step 2000 → 3000에서 T2-Z 방식 성공률이 87 → 78%로 내려갔다. 1개 seed, 55개 결정이라 차이는 ±5~6%p 수준의 잡음일 수 있다.
5 Next
- step 2000 / 3000 차이 확인: seed 2~3개 반복, step 2500 평가
- history on 3~4번째 시도가 약하다(1/9, 0/8). 앞선 세팅에서도 3번째 이후가 교사보다 약했다. 실패 영상을 확인해야 한다.
APPROACH=policy수치를 따로 보고. 접근 정밀도는 별도 과제로 다룬다.- T2-Z 방식에서 support를 history로 쓰는 효과: support 없이 1번 시도한 결과(38%)와 대비된다.