T2-Z push-box(마찰) 재시도 테스트베드: 환경 구축과 smoke
TL;DR
- T2-Z 시뮬(TTT4dynamics + LIBERO, 핀 커밋)을
~/repos/Robotics/T2-z-sim/에 설치했고, 로그인 노드 EGL 렌더링까지 동작한다. - 목표 원판을 보이게 바꿔도(
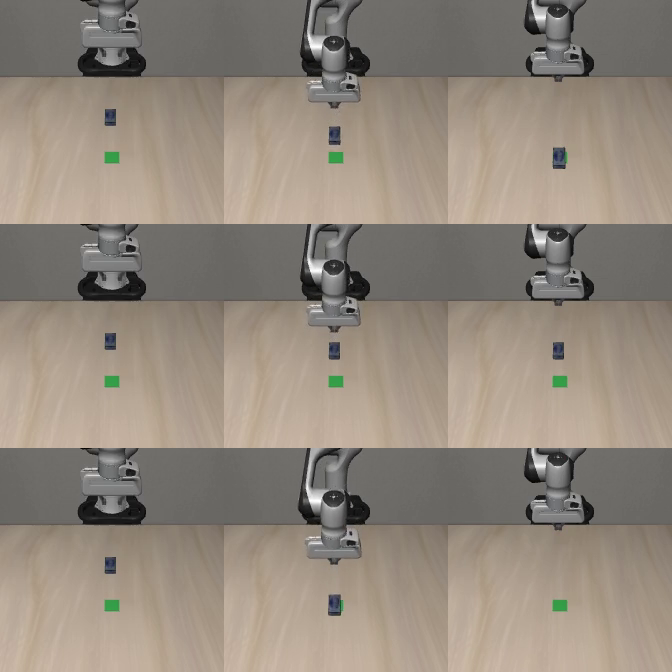
target_rgba) 정상 렌더링된다. 같은 밀기(0.12)에서 μ 0.01이면 0.185m(성공), μ 0.1이면 0.026m. 숨은 변수 효과가 크다. - 실패 방향(모자람/지나침)이 영상에 그대로 보여서 reward 없이 수정 방향을 읽을 수 있는 과제다.
1 배경
one_leg의 ε_bias는 정책 믿음 오차라 환경 숨은 변수가 아니었다. 인스턴스에 고정되고 영상으로 드러나는 숨은 변수를 갖춘 T2-Z 마찰 과제를 재시도 정책 실험의 보조 테스트베드로 쓴다.
2 구축
3 결과
| μ | push | 이동 | 목표까지 | 성공 |
|---|---|---|---|---|
| 0.01 | 0.12 | 0.185 m | 0.010 m | O |
| 0.01 | 0.20 | 0.555 m | 0.379 m | X 지나침 |
| 0.10 | 0.12 | 0.026 m | 0.150 m | X 모자람 |
| 0.10 | 0.20 | 0.079 m | 0.097 m | X 모자람 |
4 Takeaway
환경 숨은 변수, 목표 표시, 영상으로 드러나는 실패 방향이 모두 갖춰져 재시도 정책 실험의 전제가 성립한다. 다만 정면 224px에서 상자가 작아서 입력 해상도나 크롭을 검토해야 한다.
5 Next
6 업데이트: 보정 sweep과 기억의 최대 이득
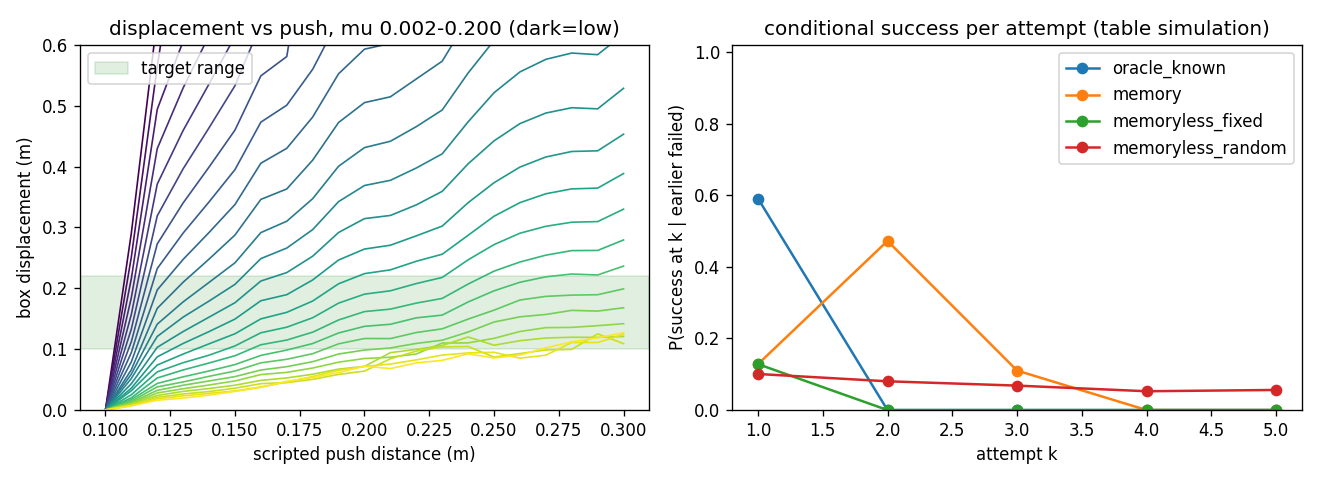
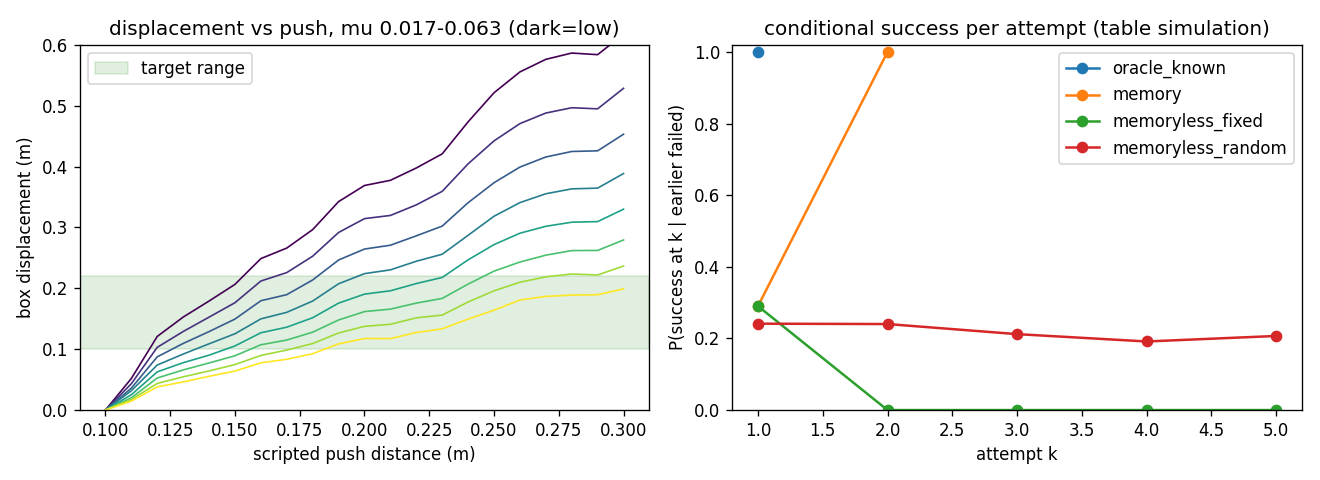
μ 25단계 × 밀기 21단계 = 525회(job 196025, 4분 53초). 표만으로 K=5 재시도를 4000 인스턴스에서 계산했다. memory는 μ를 모르는 교사로, 관측 이동 거리와 맞는 μ만 남긴다.
| μ 0.016~0.064 | k=1 | k=2 (1회 실패 후) | 누적 k=5 |
|---|---|---|---|
| oracle_known (μ 앎) | 1.00 | - | 1.00 |
| memory (교사) | 0.29 | 1.00 | 1.00 |
| memoryless_random (운) | 0.24 | 0.24 | 0.71 |
| memoryless_fixed (반복) | 0.29 | 0.00 | 0.29 |
7 업데이트: 카메라 / 교사 관측 노이즈
Long-WAM LIBERO-IDM은 agentview + wrist(512 렌더 → 224, 가로 연결 224×448, 180° 뒤집기)를 쓴다. push 환경은 같은 LIBERO agentview 자세라 기본 카메라 유지. 상자는 정면에서 약 12px(약 3px/cm), wrist는 밀기 후 상자를 잃으므로 히스토리에 정면 마지막 프레임이 필수.
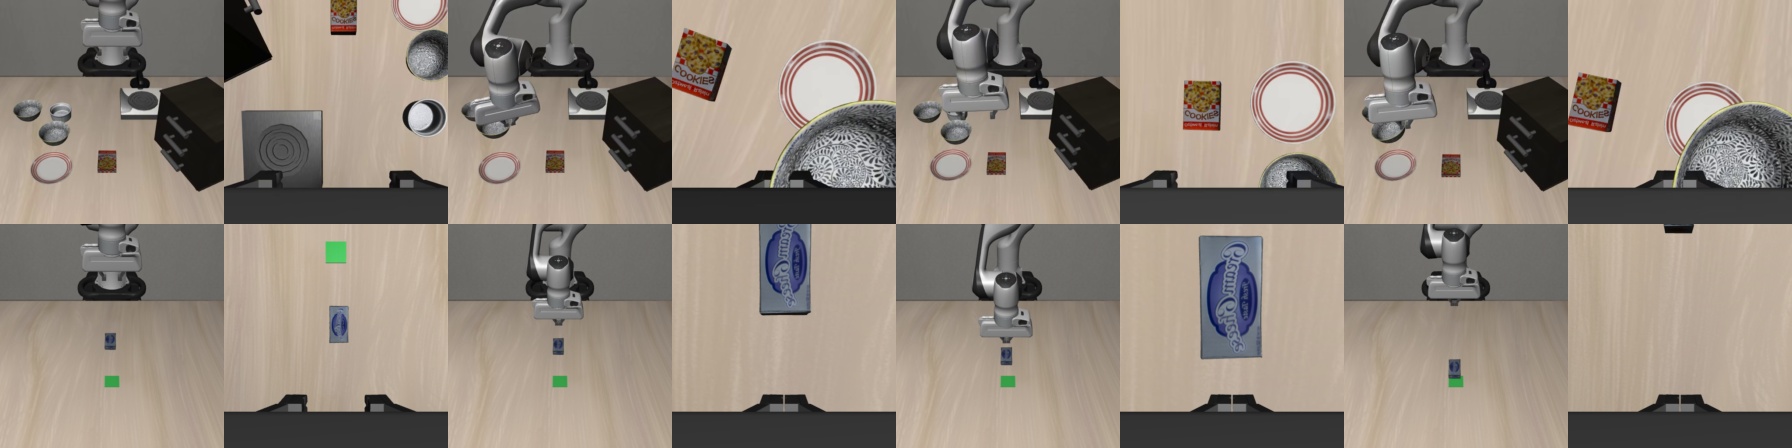
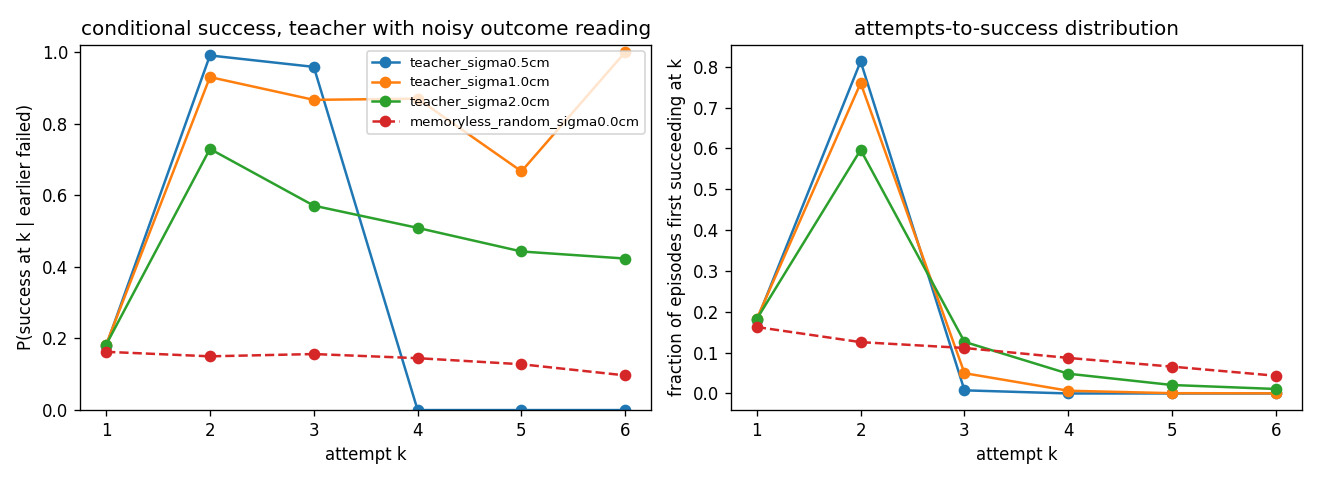
결정론 + 정확한 관측이면 1회 실패 후 바로 성공해서 히스토리가 1개뿐이다. 교사가 이동 거리를 N(0,σ) 노이즈로 본다고 두고 표 시뮬(3000 인스턴스, K=6):
| 반경 | σ | 조건부 SR k=1..4 | 3회 이상 | 평균 시도 |
|---|---|---|---|---|
| 2.5cm | 2cm | 0.29 0.91 0.76 0.85 | 6% | 1.79 |
| 1.5cm | 2cm | 0.18 0.73 0.57 0.51 | 22% | 2.15 |
| 1.0cm | 2cm | 0.11 0.54 0.40 0.35 | 42% | 2.52 |
| 1.5cm 기억 없음 | - | 0.16 0.15 0.16 0.14 | - | 2.83 (실패 40%) |
8 업데이트: 재시도 에피소드 생성기
| 문제 | 원인 | 수정 | 검증 |
|---|---|---|---|
| 같은 action이 단계마다 다른 움직임 | env가 밀기 때만 OSC 출력 배율 1→4 | 배율 4 고정, action = a·s(t)/4 | 원래 env와 이동 소수 4자리 동일, max|a| 0.45 |
| 같은 밀기인데 결과가 다름(0.131 vs 0.123) | LIBERO sampler가 reset마다 상자를 ±2.5cm 이동 | reset 후 상자를 (init_x, 0)에 고정 | seed 무관 이동 0.1349 반복 |
| 옛 보정 표 예측 0.171 vs 실제 0.135 | 옛 표는 시작 x −0.146 | 재보정 1230회(job 196384, 11분) | 정지 step ≤119 → 시도 144 step, μ 0.0166~0.0577 |
| 교사가 같은 밀기 반복(24개 중 3개) | argmax가 성공 구간 가장자리를 고름 + 이동이 밀기에 대해 계단형 | 목표 중앙 쪽 동점 처리, 원판 앞/뒤 방향을 정확히 관측, 실패 밀기 금지 | 반복 0건 |
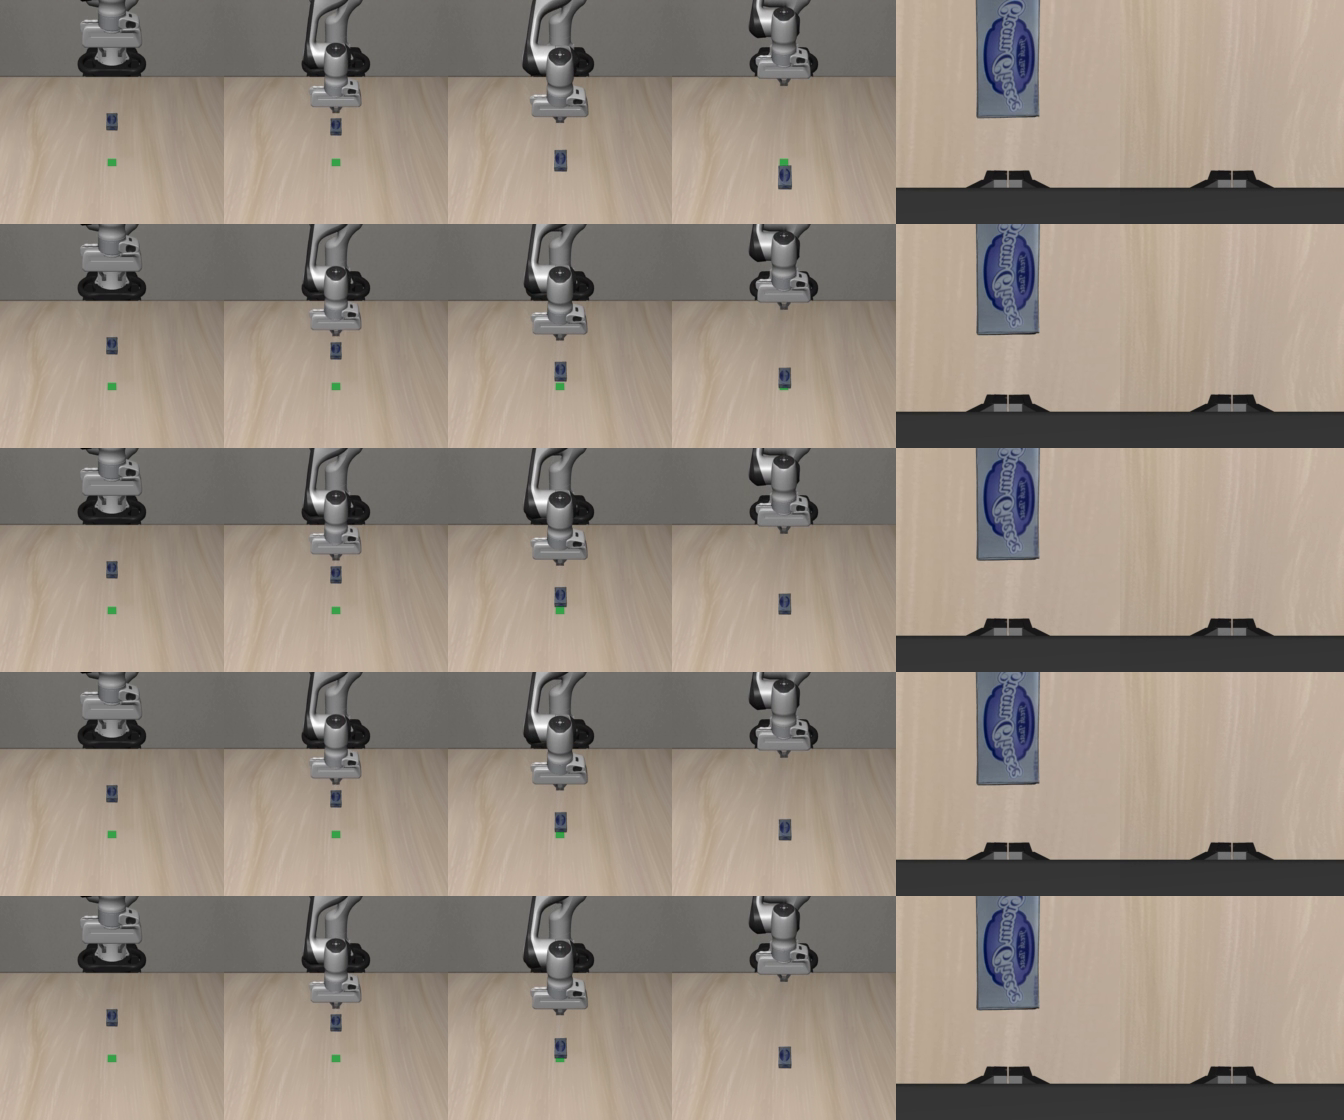
Next: 변환 → Long-WAM smoke → p768 AD 학습 → 평가(조건부 SR, 기억 없는 기준선, 히스토리 셔플/전이).
9 업데이트: 대량 생성 · 변환 · 학습 제출
| 성공 시도 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 에피소드 수 | 369 | 1157 | 428 | 45 | 1 |
| 조건부 성공률 | 0.18 | 0.71 | 0.90 | 0.98 | 1.00 |
10 업데이트: 첫 평가 — history on 0.84 vs off 0.21
학습 196441은 /dev/shm Bus error(p768 × batch 8)로 죽음 → 197098 재제출. 설정은 batch 2 / 글로벌 64 / 3000 step, sbmr로 선점 후 자동 재개. 평가 동작 확인 중 회전 액션 버그 발견: 학습 데이터에서 범위가 0인 차원은 정규화기가 모델 출력을 그대로 통과시켜 팔이 꺾임 → 평가 때 회전 0, 그리퍼 +1로 고정.
| run | 누적@1 | @2 | @3 | @6 | cond k=2 | cond k=3 | 방향 맞는 재시도 |
|---|---|---|---|---|---|---|---|
| 교사 (학습 데이터) | 0.18 | 0.76 | 0.98 | 1.00 | 0.71 | 0.90 | – |
| s1000 on | 0.14 | 0.32 | 0.42 | 0.42 | 0.21 | 0.15 | 0.44 |
| s2000 on | 0.25 | 0.55 | 0.70 | 0.77 | 0.40 | 0.33 | 0.63 |
| s3000 on | 0.21 | 0.65 | 0.75 | 0.84 | 0.56 | 0.29 | 0.70 |
| s3000 off (고정 노이즈) | 0.21 | 0.21 | 0.21 | 0.21 | 0.00 | 0.00 | 0.00 |
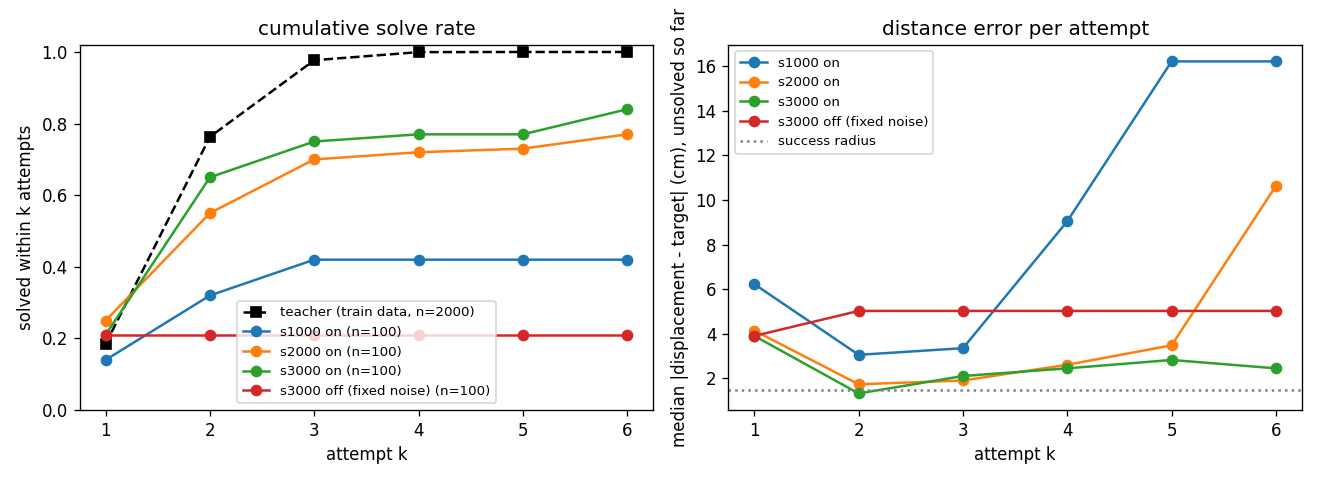
보지 못한 인스턴스에서도 Long-WAM이 자기 이전 시도 영상을 보고 방향을 맞게 교정한다. 시도 1은 on/off가 100/100 동일하므로 개선은 전부 history에서 온다. 3번째 시도부터 계속 다듬는 능력은 교사보다 많이 약하다. 다음: 운 기준(199907), history shuffle, 3회 이상 에피소드 가중 / 추가 학습, 768 창 처리.
11 업데이트: 운 기준 — history on 0.84 vs 운 0.35
| run | 누적@1 | @2 | @3 | @6 | cond k=2 | cond k=3 | 오차 중앙값 시도 1/2/3 |
|---|---|---|---|---|---|---|---|
| s3000 on | 0.21 | 0.65 | 0.75 | 0.84 | 0.56 | 0.29 | 3.9 / 1.3 / 2.1 cm |
| s3000 off, seed 변경 (운) | 0.21 | 0.27 | 0.29 | 0.35 | 0.08 | 0.03 | 3.9 / 4.7 / 5.0 cm |
| s3000 off, 고정 노이즈 | 0.21 | 0.21 | 0.21 | 0.21 | 0.00 | 0.00 | 3.9 / 5.0 / 5.0 cm |
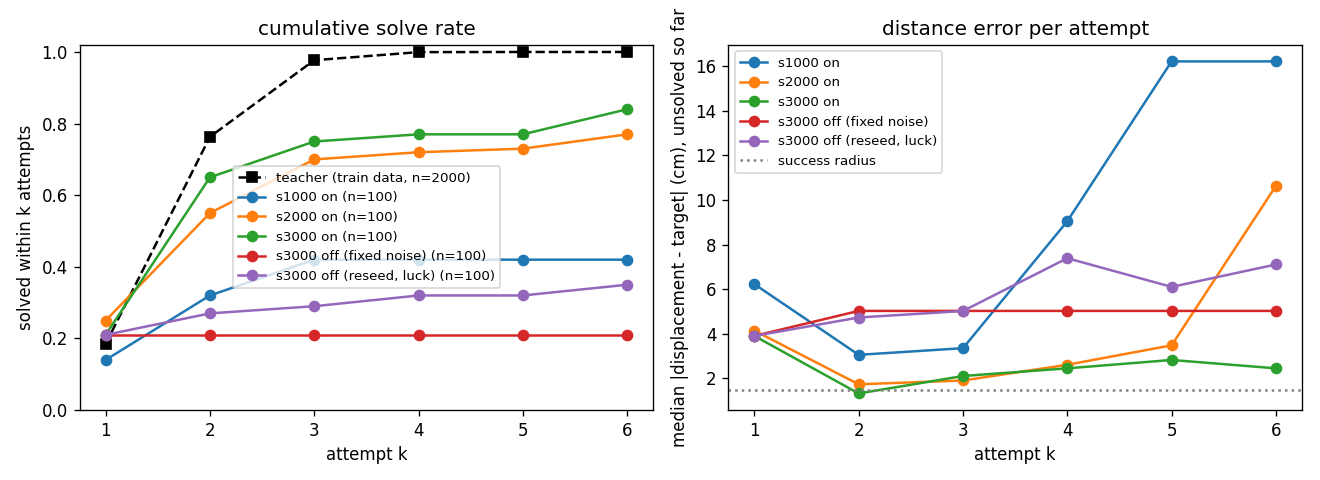
자기 이전 시도 영상을 보고 하는 재시도 개선은 운을 크게 넘어선다(조건부 k=2 7배, 오차 3.9→1.3cm vs 3.9→4.7cm). 남은 간격은 교사(k=3까지 0.98)와의 3번째 시도 이후 차이. 다음: history shuffle(영상 내용에서 μ를 읽는지), 3회 이상 에피소드 가중, 768 창 처리, 실행 노이즈 강건성.
12 영상: rollout과 모델이 예측한 미래
모든 영상은 학습한 Long-WAM(step 3000)이 직접 민 rollout입니다. 교사(expert) 영상은 없습니다. 평가 seed는 101000~101099로 학습 seed(1000~2999)와 겹치지 않습니다. 2배속.
12.1 기억 있음 vs 운 기준 (같은 가중치, 같은 상황)
12.2 기억 있음, 오래 걸린 경우와 실패한 경우
12.3 실제 vs 모델이 상상한 미래
생성: scripts/t2z/make_rollout_clip.py, scripts/t2z/make_imagine_clip.py, 예측 덤프 serve_longwam.py --dump-imagine (DUMP_IMAGINE=dir).
13 상상한 미래는 실제로 맞나? (빠른 갱신 효과와 분리)
질문: 12.3 영상에서 상상한 미래가 짧게 가는지 길게 가는지까지 맞히는 것처럼 보이는데, 진짜 예측인가, 0.5초마다 갱신돼서 그렇게 보이는 것인가?
방법: 상자가 맞기 전(시도 내 step 60, 밀기 시작 약 70)에 한 예측만 골라, 32 step 뒤(t=92, 최종 이동의 약 95% 지점) 상자 위치를 같은 시점 실제 프레임과 비교했다. 맞은 직후(step 70 → t=102)도 같이 표시. 상자 위치는 정면 영상의 파란 픽셀 중심을 cm로 환산(0.461 cm/행, 최대 오차 0.6cm).
| 인스턴스 · 시도 | 맞기 전 예측 t=92 (예측 / 실제) | 맞은 직후 예측 t=102 (예측 / 실제) | 목표 |
|---|---|---|---|
| 101002 · 1 | 8.2 / 7.7 | 12.3 / 7.7 | 11.2 |
| 101002 · 2 | 10.9 / 9.5 | 11.1 / 9.8 | 11.2 |
| 101027 · 1 | 19.7 / 25.9 | 35.8 / 42.1 | 20.0 |
| 101027 · 2 | 13.4 / 12.9 | 19.4 / 18.9 | 20.0 |
| 101012 · 1 | 13.2 / 11.0 | 13.5 / 10.8 | 14.1 |
| 101012 · 2~5 | 12.2~12.8 / 10.1~12.0 | 12.3~13.2 / 10.1~12.1 | 14.1 |
| 101012 · 6 (768 창 초과) | 12.0 / 6.8 | 11.5 / 6.8 | 14.1 |
(1) 빠른 갱신 효과는 맞다. 영상의 예측은 최대 0.5초 전 것이라, 상자가 움직이기 시작하면 속도를 보고 바로 고친다. (2) 그래도 맞기 전 예측만 보면, 1번째 시도는 마찰과 무관하게 목표 근처에 멈춘다고 상상하고(마찰 정보가 없으니 목표를 그림), 실패를 한 번 본 뒤에는 실제와 약 1cm 안으로 들어온다. 이전 시도 영상이 동역학 예측을 바꾼다는 정성 증거다. (3) 여전히 낙관적이다. 101012에서는 12~13cm를 상상하지만 실제는 10~12cm라, 거의 된다고 믿고 같은 밀기를 반복하는 정체 실패와 맞아떨어진다.
13.1 30개 인스턴스 on / off 비교 (job 200844 / 200845)
같은 30개 인스턴스(s101000~101029)를 history on과 off(매 시도 seed 변경 = 운 기준)로 돌렸다. 시도마다 맞기 전 시점(step 50 / 60 / 70) 3개의 예측을 골라, 32 step 뒤의 상자 이동을 실제 프레임과 비교했다. 픽셀→cm 환산은 시도 223개로 다시 맞췄다(0.410 cm/행). 1번째 시도는 on과 off의 seed가 같아서 결과가 완전히 같다(검증용). 그래서 1번째에 실패한 24개 인스턴스는 2번째 시도에서 정확히 같은 집합으로 비교된다.
| 시도 | on: |예측−실제| 평균 / 중앙 (n) | off: 평균 / 중앙 (n) |
|---|---|---|
| 1 | 2.70 / 0.98 (90) | 2.70 / 0.98 (90) |
| 2 (같은 24개) | 0.73 / 0.54 (72) | 2.33 / 1.01 (72) |
| 3 | 0.88 / 0.65 (36) | 2.15 / 0.99 (66) |
| 4 | 0.80 / 0.66 (27) | 2.28 / 1.01 (63) |
| 5 | 1.13 / 1.04 (24) | 2.18 / 1.11 (60) |
| 6 (on은 768 창 초과) | 2.30 / 1.39 (24) | 2.10 / 0.86 (60) |
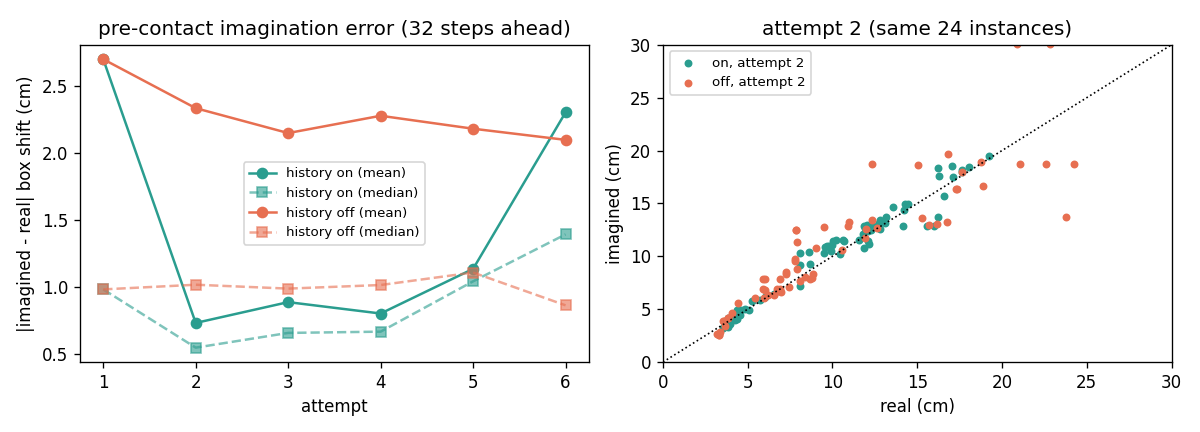
(1) 직접 증거가 나왔다. 같은 인스턴스, 같은 2번째 시도에서 이전 시도 영상이 context에 있으면 맞기 전 예측 오차가 2.33 → 0.73cm(평균), 1.01 → 0.54cm(중앙)로 줄어든다. off는 6번을 해도 줄지 않는다. 빠른 closed-loop 갱신은 on/off에 똑같이 있으므로, 이 차이는 history 때문이다. (2) 평균과 중앙값의 차이가 큰 것은 off에서 가끔 크게 빗나가는 예측 때문이다. 마찰이 극단(아주 미끄럽거나 아주 뻑뻑)일 때 기본값을 그대로 상상한다. (3) on의 6번째 시도에서 오차가 다시 커지는 것은 768 프레임 창(약 5.3 시도)을 넘어 1번째 시도가 잘려나가기 때문으로 보인다. 앞서 101012·6에서 본 현상과 같다.