2026-10-14 — Experiment
Video expert 상상 vs 시뮬레이터 실제 미래
Long-WAM | RoboTwin closed-loop rollout, 공개 체크포인트 vs 우리 step 5000
TL;DR
- 공개 체크포인트: 상상한 32 step 미래가 실제와 PSNR 25.5 dB. 현재 프레임 유지(15.8) 대비 +9.7 dB, 움직인 영역은 +10.7 dB. VAE 상한은 38.8 dB.
- step 5000: 16.9 dB로 현재 프레임 유지(16.6)와 거의 같음. 같은 태스크·같은 seed·둘 다 5/5 성공인 adjust_bottle에서도 24.3 vs 15.9 dB.
- σ0.9 추정 ≈ 완전 디노이즈: action expert가 실제로 보는 상태가 끝까지 디노이즈한 결과와 같거나 0.2 dB 더 나음.
25.5
공개 상상 PSNR
16.9
s5k 상상 PSNR
15.8
static (공개 run)
38.8
VAE 상한
1 배경 / 목적
Long-WAM은 매 추론마다 video expert가 미래 2 latent(+4…+32 step)를 σ=0.9까지 4 step만 디노이즈해 상상하고, action expert가 이를 attend해 action chunk를 냅니다(VAE decode 없음). 실제 rollout 중 이 상상이 시뮬레이터가 보여준 미래와 얼마나 다른지 측정합니다.
2 작업 내용
probe: src/longwam/runtime/imagine_probe.py (LONGWAM_IMAGINE_DUMP 설정 시에만 활성)
_imagine_future_latents 출력을 잡아 σ0.9→0 10 step 이어 디노이즈(future_full)
+ σ0.9 one-step x0 추정(x0_at_sigma) + 4 step 간격 관측 프레임 저장
analysis: scripts/robotwin2/analyze_imagination.py
실제 창(anchor-48..+32, stride 4) VAE encode → gt, 같은 clean history로 decode 후 미래 8 프레임 비교
비교군: future_full / x0_at_sigma / static(현재 프레임 고정) / vae_recon(상한)
driver: scripts/robotwin2/imagine_vs_sim_b200.sh
jobs: 192318 공개 robotwin2_idm, 192319 step 5000 — demo_clean, lift_pot/click_bell/adjust_bottle x 5 ep, 같은 seed
3 결과
성공률: 공개 15/15, step 5000 8/15(adjust_bottle 5/5, click_bell 3/5, lift_pot 0/5).
| 방법 | 공개 PSNR | 공개 moving | 공개 NMSE | s5k PSNR | s5k moving | s5k NMSE |
|---|---|---|---|---|---|---|
| future_full (완전 디노이즈) | 25.5 | 19.7 | 0.086 | 16.9 | 11.2 | 0.315 |
| x0@σ0.9 (정책이 본 상태) | 25.7 | 19.9 | 0.077 | 17.3 | 11.5 | 0.266 |
| static (현재 프레임 유지) | 15.8 | 9.0 | 0.446 | 16.6 | 9.5 | 0.445 |
| vae_recon (상한) | 38.8 | 33.2 | 0 | 38.3 | 32.4 | 0 |
미래 거리별 PSNR (future_full / static)
| offset | +4 | +8 | +16 | +24 | +32 |
|---|---|---|---|---|---|
| 공개 | 29.4 / 22.7 | 26.8 / 18.2 | 25.5 / 15.3 | 24.6 / 13.3 | 22.8 / 12.8 |
| step 5000 | 18.9 / 18.8 | 18.0 / 17.9 | 17.3 / 16.8 | 16.4 / 16.0 | 14.5 / 14.5 |
태스크 × 성공 여부 (future_full PSNR, 괄호는 static)
| 그룹 | 공개 | step 5000 |
|---|---|---|
| adjust_bottle / 성공 | 24.3 (14.6) | 15.9 (14.0) |
| click_bell / 성공 | 28.6 (16.9) | 22.0 (19.0) |
| click_bell / 실패 | — | 20.2 (21.2) |
| lift_pot / 성공 | 25.1 (16.6) | — |
| lift_pot / 실패 | — | 15.5 (15.2) |
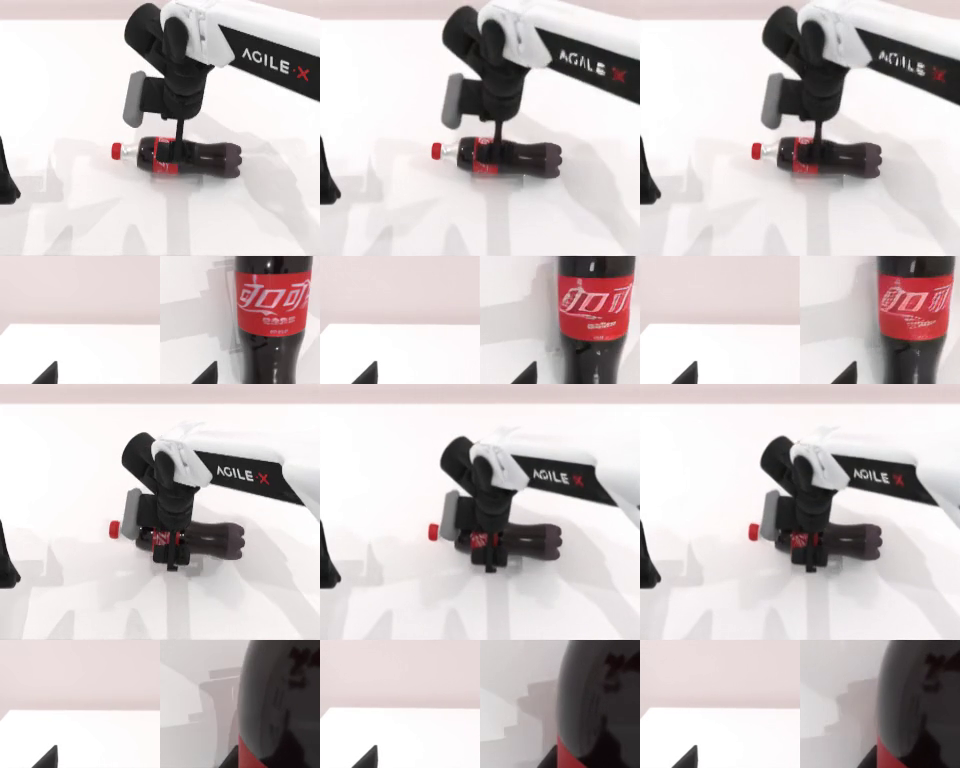
공개, adjust_bottle ep0, +32 step. 왼쪽부터 실제 / 완전 디노이즈 / σ0.9 추정
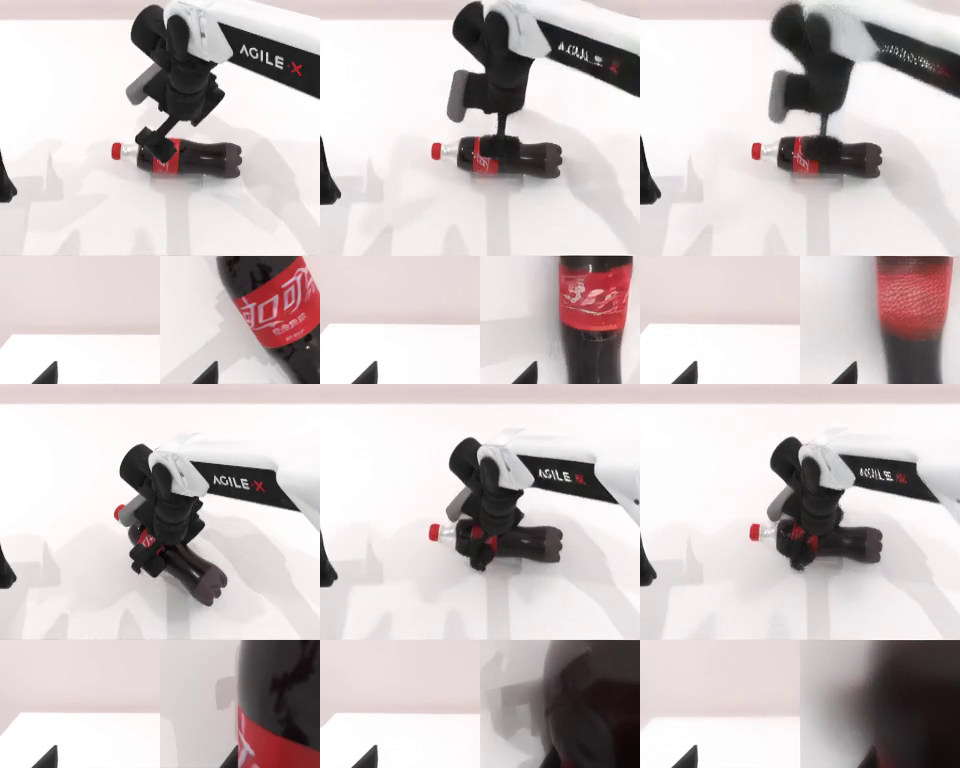
step 5000, 같은 seed. 팔 자세가 틀리고 wrist 뷰가 흐림
4 Takeaway
공개 video expert는 closed-loop에서도 실제 미래를 꽤 맞힘. 상상 이득은 먼 미래일수록 커짐(+4에서 +6.7 dB, +32에서 +10.1 dB). VAE 상한까지 13 dB 남은 차이는 VAE가 아니라 예측 오차.
σ0.9 one-step 추정이 완전 디노이즈와 같거나 약간 나음. 현재 4 step / σ0.9 설정에서 추가 디노이즈로 action expert가 얻을 정보는 없음.
step 5000 video expert는 아직 RoboTwin 3-view composite에 적응하지 못해 상상이 static 수준. 그럼에도 adjust_bottle 5/5 성공 → 쉬운 태스크는 clean history만으로 풀림. lift_pot 0/5와 낮은 상상 품질이 같이 나타나지만 인과는 미확정.
해석
짧은 스케줄로 재학습할 경우 video expert의 도메인 적응 속도가 병목이 될 가능성이 큼. 상상이 action에 실제로 얼마나 쓰이는지는 개입 실험으로 확인해야 함.5 Next
- 개입 실험: 공개 체크포인트에서 상상 latent를 static/노이즈로 바꿔치기 → 성공률 하락 여부
- 교차 실험: step 5000 action expert + 공개 video expert 상상
- 공개 체크포인트가 실패하는 어려운 태스크에서 상상 오차와 실패의 관계 측정
- 학습 재개 시 step별 상상 품질 곡선