FurnitureBench | 실패 에피소드 30개 + 액션 전처리 추적 | 이전 "부정 전이" 결론 철회
TL;DR
원인은 모델이 아니라 전처리다.lerobot_latent_dataset.py:281이 정규화된 학습 타깃을 clip(±1.5)로 자르고, 추론은 역변환만 한다. 그래서 모델이 낼 수 있는 손목 회전의 물리 최대값이 고정된다.
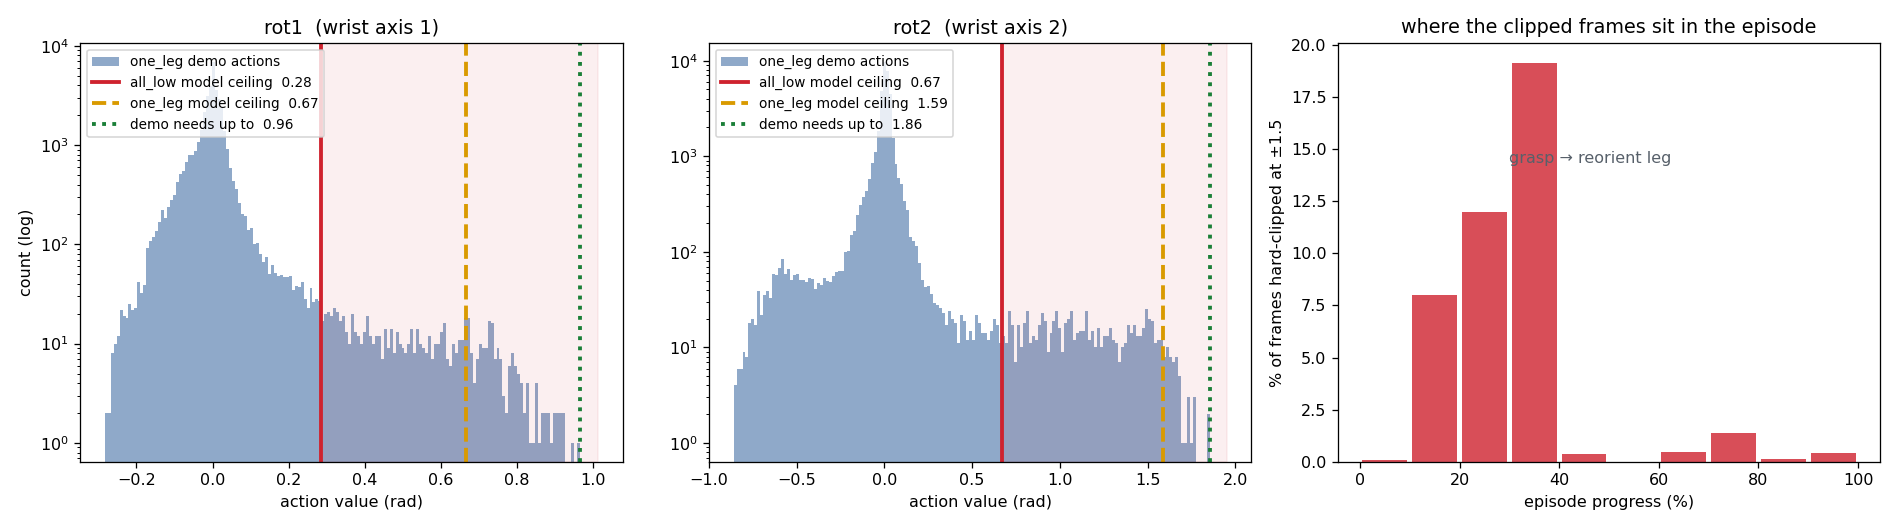
4가구를 합치자 회전 범위가 오히려 좁아졌다. 회전 축은 꼬리가 두꺼워 pooled q99(rot1 0.195)가 실제 최대(1.310)의 1/6이다. 실행 천장 rot1 0.284 / rot2 0.670 vs 데모 요구 0.965 / 1.773 → 3.4배 / 2.65배 부족.
부족 배수와 성공률이 대응한다. one_leg 단독 통계는 1.45배 부족 → 성공 0.157. all_low 통계는 3.4배 부족 → 성공 0.
모델은 잘 배웠다. teacher-forcing 물리 단위 MAE는 rot1 0.020인데, 예측 |최대|가 0.275/0.667로 천장 0.284/0.670에 정확히 붙어 있다. 타깃 자체에 필요한 회전이 없었다.
pi0.5가 멀쩡했던 이유: 같은 분위수 통계를 쓰지만 openpi는 클리핑을 하지 않는다(transforms.py:145).
결과 (재학습 후): one_leg 0/30 → 4/30 = 0.133 (클립본 누적 0/80 대비 p=0.0048), one_leg 단독 모델 4/30과 p=1.0으로 동등. cabinet phase 2.80→3.50. 남은 격차는 pi0.5 0.36 vs 0.133.
3.4×
rot1 실행 천장 부족
0.302
rot1 예측 최대 (천장 0.284)
19%
30-40% 구간 클립 프레임
86.6%
rot2 총 회전량 잔존
0.133
수정 후 one_leg (0 → 4/30)
p=0.005
클립본 0/80 대비
1무엇을 못 했나 — 실패 30 에피소드
실패 유형
비율
지표 근거
다리를 base 근처까지 가져갔으나 삽입 실패 (phase 3 정체)
20/30
leg_lift 0.11±0.10, leg_base_dist_min 0.12±0.06
다리를 아예 집지 못함
6/30
leg_lift ≤ 0.03 m
다리를 과도하게 튕겨냄
ep9 등
leg_lift 0.546 m = 데모 최대(0.17 m)의 3.2배
성공
0/30
전 에피소드 1000 step timeout
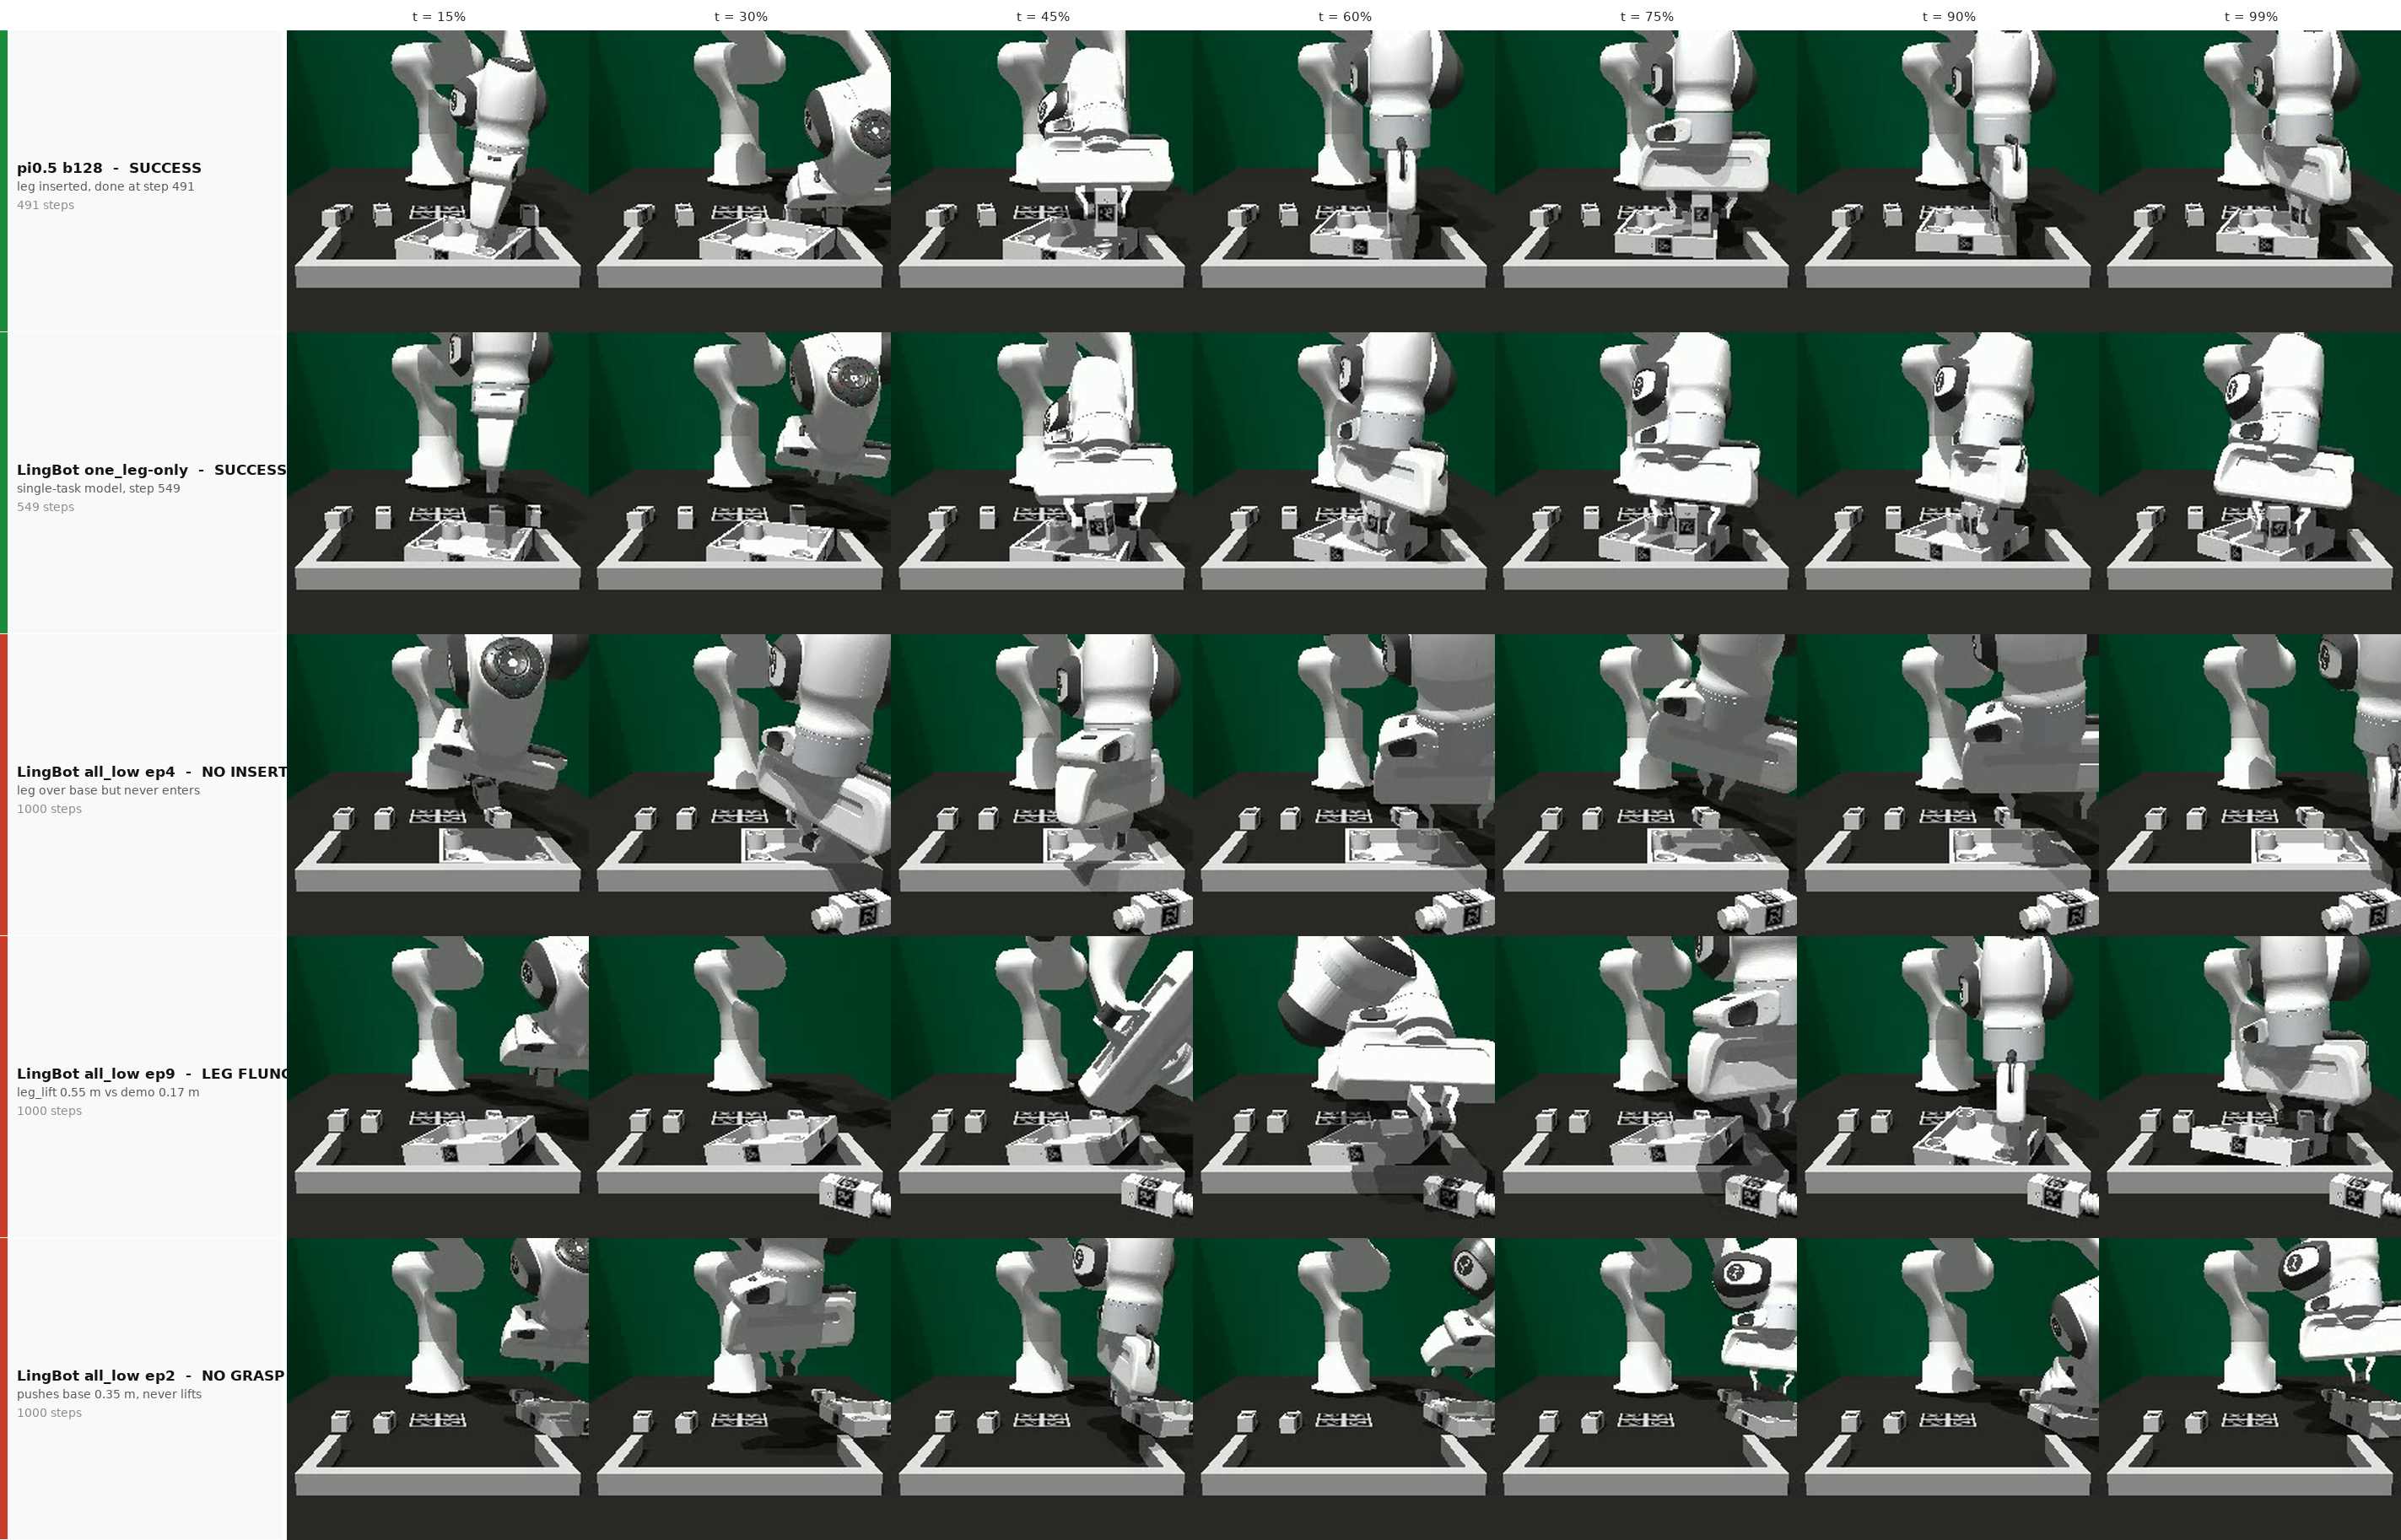
정면 카메라, 에피소드 진행 15~99%. 위 2행은 성공(pi0.5 491 step, LingBot one_leg 단독 549 step) — t=45~60%에서 다리를 수직으로 세워 base 구멍 위에 정렬하는 장면이 뚜렷하다. 아래 3행은 all_low 실패 — 이 "다리 세우기"가 없고, 그리퍼가 다리를 박스 밖으로 쳐낸 뒤 빈 손으로 base 위를 배회한다.
pi0.5 b128 — 성공 491 step에 삽입 완료. 4배속.all_low ep4 — 삽입 실패 base 위까지 가지만 다리가 서지 않아 들어가지 않는다.all_low ep9 — 다리 튕김 leg_lift 0.55 m. 팔이 데모에 없는 각도로 꺾인다.all_low ep2 — 못 집음 base만 0.35 m 밀고 다리는 한 번도 들지 못한다.
공통점: 실패는 "엉뚱한 곳으로 간다"가 아니라 "다리를 세우는 회전이 안 나온다"에 가깝다. 그리고 전 에피소드가 1000 step timeout — 방향이 아니라 크기의 문제라는 신호였다.
2왜 못 했나 — 액션 정규화 클리핑
wan_va/dataset/lerobot_latent_dataset.py:279-281 (학습)
action_norm = (a - q01) / (q99 - q01) * 2 - 1
action_norm = np.clip(action_norm, -1.5, 1.5) # <- 학습 타깃이 여기서 잘린다
wan_va/wan_va_server.py:247 (추론, 역변환만)
a = (n + 1) / 2 * (q99 - q01) + q01
=> 모델이 낼 수 있는 물리 최대값 = 정규화 1.5에 대응하는 값으로 고정
회전 축은 분포 꼬리가 두껍다. all_low 354,849 프레임 기준으로 병진 축은 q99가 실제 최대와 거의 같은데, 회전 축은 q99가 실제 최대의 1/6~1/4밖에 담지 못한다. 대부분의 스텝은 회전이 0 근처이고 조립 구간에서만 큰 회전이 나오기 때문이다.
축
q01 / q99 (현재 사용)
q0.1 / q99.9
실제 min / max
dx / dy / dz
±0.11 ~ 0.11
±0.12
±0.12
rot1
−0.162 / 0.195
−0.338 / 0.628
−0.655 / 1.310
rot2
−0.424 / 0.451
−0.900 / 1.384
−1.273 / 1.832
좌·중: one_leg 데모의 회전 분포(로그 스케일)와 각 정규화가 만드는 실행 천장. 붉은 영역이 물리적으로 낼 수 없는 구간. 우: 클립된 프레임의 에피소드 내 위치 — 30~40% 구간에서 19%로, 정확히 "다리를 잡아 세우는" 동작 구간이다.
정규화 통계
rot1 천장
rot2 천장
데모 요구
부족 배수
타깃 클립 비율
one_leg 성공률
one_leg 단독
0.666
1.588
0.965 / 1.773
1.45× / 1.12×
0.9% / 1.0%
0.157
all_low (4가구 pooled)
0.284
0.670
0.965 / 1.773
3.40× / 2.65×
2.1% / 2.9%
0
데이터를 늘렸더니 필요한 회전이 잘려나갔다. 4가구를 합치면 one_leg의 큰 회전이 pooled 분포의 상위 0.25%로 희석돼 q99가 더 좁아진다. 왕복 검사(정규화→클립→역정규화)에서 에피소드 총 회전량은 one_leg 통계로는 99.1% 보존되지만 all_low 통계로는 86.6~89.1%만 남는다.
3결정적 확인 — 모델 출력이 천장에 붙어 있다
scripts/lingbot/diagnose_action_head.py(신규)로 teacher-forcing에서 flow matching을 역산해(x0 = x_t − σ·v) 모델이 만드는 물리 단위 액션을 직접 측정했다. job 113061/113062, 각 20 에피소드, σ=0.5. 먼저 all_low 3000 checkpoint:
측정
dx
dy
dz
rot1
rot2
rot3
grip
물리 단위 MAE
0.008
0.007
0.006
0.020
0.029
0.137
0.059
모델 예측 |최대|
0.122
0.122
0.085
0.302
0.706
1.851
1.068
실행 천장 (clip 1.5)
0.169
0.169
0.117
0.284
0.670
2.628
1.500
데모 요구 최대
0.120
0.120
0.080
0.965
1.773
1.673
1.000
두 모델 비교 — 같은 one_leg 에피소드, 각자의 정규화
모델
rot1 예측최대 / 천장
rot2 예측최대 / 천장
rot1 MAE
rot2 MAE
타깃 클립 비율
one_leg 성공률
all_low 3000 (pooled q01/q99)
0.302 / 0.284
0.706 / 0.670
0.0139
0.0228
2.11% / 2.79%
0 / 30
one_leg 5000 (자체 q01/q99)
0.677 / 0.666
1.652 / 1.588
0.0167
0.0310
0.39% / 0.12%
0.157
one_leg 데모가 요구하는 값
0.965
1.773
—
—
—
1.0
두 모델 모두 자기 천장에 붙어 포화한다. 그런데 one_leg 모델은 all_low 모델보다 rot1을 2.2배, rot2를 2.3배 크게 낼 수 있다. 반면 MAE는 사실상 같다(rot1 0.014 vs 0.017) — 학습 품질 차이가 아니라 표현 가능한 범위의 차이만 존재한다. 성공률 0 vs 0.157의 차이가 여기서 나온다.
학습은 정상이었다. 물리 단위 MAE가 rot1 0.020으로 작다 — 모델은 주어진 타깃을 정확히 맞춘다. 그런데 예측 최대치가 천장에 소수점 셋째 자리까지 붙어 있다. 과제에 필요한 회전이 애초에 학습 타깃에 없었다.
4왜 pi0.5는 멀쩡했나
pi0.5(openpi)도 같은 분위수 통계를 쓴다 — assets/pi05_furniture_all_low_b128/.../norm_stats.json의 q99 rot1 = 0.1944로 우리 값 0.1947과 사실상 같다. 차이는 클리핑 유무 하나다.
그래서 같은 데이터가 정반대 결과를 냈다. pi0.5는 one_leg 0.24 → 0.36으로 좋아졌고, LingBot은 0.157 → 0이 됐다. 멀티태스크 학습의 문제가 아니라, 두 파이프라인 중 하나만 꼬리를 자른 결과다.
4.5수정과 검증 — one_leg 0 → 0.133
수정: 분위수는 q1/q99 그대로 두고(openpi/pi0.5와 동일) 클립만 제거했다. lerobot_latent_dataset.py의 무조건 np.clip(±1.5)를 action_clip 설정 기반으로 바꾸고 furniture 계열에 None을 지정(libero/robotwin은 기존 1.5 유지). 클립 제거해도 정규화 RMS는 0.319→0.362로 거의 변하지 않는다(|n|>5는 0.005%). 재학습 113262(own QOS 8 GPU, 6 h 45 m, 3000→4000).
단계
rot1 예측 최대
rot2 예측 최대
rot1 MAE
클립본 3000
0.302 (천장 0.284)
0.706 (천장 0.670)
0.0139
수정본 3100 (교정 100 step)
0.918
1.741
0.0148
데모 요구
0.965
1.773
—
교정 100 step 만에 회전 범위가 95~98% 복원됐고 MAE는 그대로다. 정확도를 잃지 않고 잘려 있던 구간만 되살아났다 — 진단이 옳았다는 직접 증거.
최종 평가 (checkpoint 4000)
모델
one_leg 성공
phase
leg_lift
클립본 all_low 3000
0/30
2.53
0.108±0.096 (최대 0.546)
수정본 all_low 4000
4/30 = 0.133
3.03
0.128±0.044
one_leg 단독 5000
4/30 = 0.133
2.83
0.132±0.071
pi0.5 b128 40k
18/50 = 0.36
3.32
0.141±0.031
Fisher exact (양측)
p
해석
수정본 4/30 vs 클립본 all_low one_leg 누적 0/80
0.0048
유의 — 수정이 성공을 만들었다
수정본 4/30 vs 클립본 3000 단일 0/30
0.112
단일 비교는 검정력 부족
수정본 4/30 vs one_leg 단독 4/30
1.0
통합 모델 = 단독 모델 (동등)
수정본 4/30 vs pi0.5 18/50
0.038
pi0.5가 여전히 우위
다른 가구
가구
클립본 3000
수정본 4000
부품 조립
cabinet
phase 2.80 (1:1, 2:4, 3:1, 4:4)
phase 3.50 (3:5, 4:5)
4 → 6개
lamp
phase 2.90
phase 3.00
0 → 1개
round_table
phase 3.20
phase 3.00
2 → 0개
완전 조립 성공은 one_leg에서만 나왔다. 다부품 가구는 max_steps 1000이 데모 길이와 비슷해 두 번째 부품까지 갈 시간이 없다 — 1500으로 올린 재평가가 필요하다. cabinet은 phase 1~2 구간이 사라지고 절반이 부품을 조립해 실질 개선이 뚜렷하다.
5Takeaway
이전 결론을 철회한다 — 이제 실험으로 확정됐다. "LingBot-VA는 4가구 통합에서 부정 전이가 난다"는 틀렸다. 클립을 제거하자 통합 모델이 단독 모델과 정확히 같은 성능(0.133 vs 0.133, p=1.0)을 냈다. 파이프라인 결함이었다.
n=10 평가의 함정: 참 성공률 0.13이면 10 에피소드에서 0회가 나올 확률이 24%다. 교정 중간 checkpoint(3100/3500)의 0/10을 실패로 단정하지 않고 30 에피소드로 판정한 것이 결과를 갈랐다.
통계 검정도 정정한다. 앞서 쓴 "p=0.6%"는 단독 모델 성공률 0.157을 참값으로 가정한 값이라 과장이었다. 정확한 값은 Fisher exact 0/30 vs 8/51 → p = 0.023이고, 같은 런의 4/30과만 비교하면 p = 0.112로 유의하지 않다.
일반화할 교훈: 회전처럼 꼬리가 두꺼운 액션 축에 q01/q99 + 좁은 고정 클립을 쓰면 정밀 조작 구간이 통째로 사라진다. 병진 축만 보고 정규화를 검증하면 절대 못 잡는다. 데이터를 합칠 때 분위수가 좁아질 수 있다는 점도 함께.
6수정안과 다음 단계
방안
내용
효과 / 비용
A (권장)
norm_stat을 q0.1/q99.9로 재계산 + 클립 1.5 → 3.0
rot1 천장 1.74 / rot2 3.9 → 데모 전 구간 커버. latent 재추출 불필요, 액션 정규화만 바뀜
B
클립만 상향
현재 q01/q99 유지 시 rot1은 8 이상 필요 → 학습 스케일 불균형 우려
C
가구별 정규화
구조 변경 크고 태스크 임베딩 필요
정식 진단 job 113061 / 113062 — 완료. 위 3절 표 참조.
수정안 A로 one_leg 단독 재학습(4 GPU, 5000 step ≈ 10 h)이 가장 싼 검증 — 0.157 대비 개선이 나오면 원인 확정.
이어서 all_low 재학습(8 GPU, 유효 128, 3000 step ≈ 20 h) → one_leg 30 ep 재평가.