FurnitureSim(Isaac Gym Preview 4) B200 구동 가능성 점검 및 bring-up
TL;DR
- PhysX GPU는 B200에서 됨:
libPhysXGpu_64.so에 SASS sm_50–80 + PTX compute_86(전 63 모듈) → 드라이버 JIT. 포럼의 "PTX 없음" 주장은 오류. - Vulkan 렌더링 실패의 원인은 GPU가 아니라 pod: NVIDIA ICD가 glvnd
libEGL.so.1을 dlopen하는데 미설치 → conda-forgelibegl libgl libglvnd+LD_LIBRARY_PATH=$CONDA_PREFIX/lib로 해결 (8장 모두 Vulkan 1.4.312 인식). - 진짜 병목은 torch: Isaac Gym 바인딩은 py≤3.8, py3.8 최신 torch 2.4.1+cu124는 sm_90까지·PTX 없음 → B200에서 "no kernel image". opt-in 패치
FURNITURE_SIM_CPU_TENSORS=1(PhysX GPU 유지, 텐서 CPU, 카메라.cpu())로 우회. - 결과: one_leg headless zero-action 30 step 6.8 step/s, scripted agent 100 step 16.1 step/s, 224×224 카메라 정상.
1 배경 / 목적
FurnitureBench(RSS 2023)의 시뮬레이터 FurnitureSim을 클러스터에서 돌리기 위한 사전 점검. FurnitureSim은 NVIDIA가 deprecated한 Isaac Gym Preview 4(2022) 기반으로 공식 요구사항이 Ubuntu 20.04 / Python 3.8 / RTX GPU / torch 1.12+cu113이다.
2 작업 내용
2.1 자료 확보
clvrai/furniture-bench 클론(main a87960a, 2024-11-17) + gh-pages 문서 + isaacsim-raytrace 브랜치 확인(오프라인 ray-trace 렌더 스크립트 1개, 시뮬 포트 아님). Isaac Gym Preview 4는 NVIDIA 공식 직링크에서 로그인 없이 다운로드(201 MB).
2.2 커널 아키텍처 분석
2.3 환경 구성
2.4 Vulkan 원인 추적
카메라를 켜면 create_sim에서 segfault(exit 139). vulkaninfo: "Could not get 'vkCreateInstance' via 'vk_icdGetInstanceProcAddr' for ICD libGLX_nvidia.so.0". 시스템 python(RPATH 없음)으로 ICD를 직접 호출하면 negotiate가 -3을 반환하고, LD_DEBUG=libs에서 ICD가 libEGL.so.1을 찾는 것이 보임. pod에는 NVIDIA 벤더 lib만 주입되고 glvnd(libglvnd0)가 없음 → conda glvnd를 LD_LIBRARY_PATH에 올리면 negotiate 0, vkCreateInstance 반환.
2.5 FurnitureSim opt-in 패치 (16줄)
3 결과
| 테스트 (로그인 노드 GPU 1) | 결과 | 수치 |
|---|---|---|
| torch 2.4.1+cu124 matmul on B200 | 실패 | arch list sm_50–sm_90, "no kernel image is available" |
| Isaac Gym GPU PhysX, 카메라 off (CPU/GPU 파이프라인) | OK | 40 frame 0.11 s |
| Isaac Gym + 카메라, glvnd 없음 | segfault | exit 139 at create_sim |
| Isaac Gym + 카메라, conda glvnd | OK | GPU pipeline 60 frame 1.65 s, 카메라 텐서 cuda:1 → .cpu() 정상 |
| vulkaninfo / EGL | OK | B200 ×8 Vulkan 1.4.312; OpenGL 4.6.0 컨텍스트 |
| FurnitureSim 원본 (GPU 텐서) | 실패 | create_envs의 첫 torch.zeros(cuda)에서 no kernel image (Isaac Gym init·SDF cooking은 통과) |
| FurnitureSim + CPU_TENSORS, zero-action | OK | env 생성 14.5 s, 30 step 4.4 s (6.8 step/s), obs (1,224,224,3) uint8 cpu |
| FurnitureSim + CPU_TENSORS, scripted one_leg | OK | 100 step 6.2 s (16.1 step/s), reach→pick→push→release→go_up, skills_done=2 |
4 Takeaway
의미
FurnitureSim을 이 클러스터에서 쓸 수 있는 경로가 확보됐다. CPU 텐서 파이프라인이지만 1 env 기준 6.8–16 step/s로 데모 replay·scripted 데이터 수집·정책 평가에는 충분하다. 정책 네트워크는 py3.10+ 별도 프로세스(또는 CPU)로 분리하는 구조가 필요하다.
5 Next Steps
worker pod 검증
conda activate furniture-bench && sbm "bash scripts/run_scripted_one_leg.sh" --gres=gpu:1 -c 8 --mem 200GB --qos=extra --time 1:00:00 — 로그의 [env] vulkan ICD / dri 줄로 worker 이미지의 /etc/vulkan/icd.d, /dev/dri 주입 여부 확인. 없으면 admin에게 graphics capability 요청.
처리량 / 데이터
num_envs별 step/s 측정(문서상 multi-env 미최적화). 공식 sim 데모 다운로드 후 run_sim_env --file-path replay 검증.
대안 검토
py3.8 torch를 sm_100 포함 소스 빌드하면 GPU 파이프라인 복원 가능하나 비용이 큼. 비-Blackwell GPU 머신이 있으면 원본 그대로 실행 가능.
6 업데이트 — scripted 데모 수집 디버깅 (low vs med)
pi0.5용 sim 데모를 공식 scripted agent로 만들기 전에, 로그인 노드 디버깅 범위(≤5분, GPU 1장)에서 med 동작 여부·에피소드 비용·성공률 대략치를 확인했다. collect_data.py --scripted --is-sim --headless --pkl-only --resize-sim-img --save-failure --num-demos 1, timeout 300 s.
| 레벨 | 에피소드 | 성공 | 길이 | skill 완료 step (4개) | 비고 |
|---|---|---|---|---|---|
| low | 3 (2 min) | 1 (515 step) | 실패 2건 601 = timeout | ~35 / ~70 / 140~160 / 226~289 | 5번째 phase(insert+screw)에서 timeout |
| med | 7 (5 min) | 0 | 전부 601 = timeout | ~35 / ~70 / 114~173 / 201~291 | 앞 4 skill은 low와 동일, insert/screw 전부 timeout |
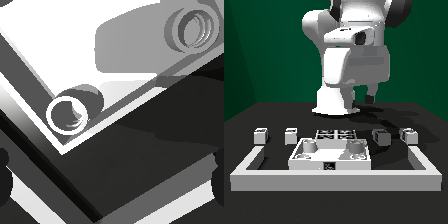
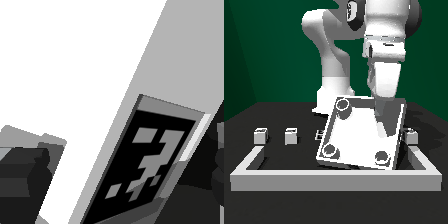
수집 에피소드 영상 (손목 | 전면, 20 fps = 2배속)
다음
sbatch로 low/med 각 20~30 에피소드를 timeout 600 vs 1000으로 비교해 성공률 확정. med가 timeout을 늘려도 0%에 가까우면 insert/screw 스크립트의 med 대응 수정 필요.
7 업데이트 — worker pod 수집 calibration (성공 20개씩 × 4 설정)
sbmr(extra, 1 GPU)로 제출. 1차는 worker 이미지에 libgomp/glib가 없어, 2차는 C++ 컴파일러가 없어(gymtorch JIT 빌드) 즉시 실패 → conda-forge libgomp glib xorg-libx11 libxcb gxx_linux-64 libxcrypt + opencv-python-headless + CPATH로 해결(venv-only 정책 유지). 3차(107994~107997)가 정상 완료.
| 설정 | 에피소드 | 성공률 | 성공 길이 mean(max) | 실패 | 소요 | 성공 1개당 |
|---|---|---|---|---|---|---|
| low, t600 | 44 | 0.45 | 482 (542) | 24 (전부 timeout) | 23:44 | 71 s |
| low, t1000 | 38 | 0.53 | 511 (662) | 18 (전부 timeout) | 27:20 | 82 s |
| med, t600 | 54 | 0.37 | 483 (567) | 34 (전부 timeout) | 33:23 | 100 s |
| med, t1000 | 39 | 0.51 | 536 (735) | 19 (전부 timeout) | 31:56 | 96 s |
OMP_NUM_THREADS=2가 본 수집의 기본 구성.8 업데이트 — 가구 4종 300개 수집, pkl→LeRobot 변환기, pi0.5 학습/평가 파이프라인
8.1 가구별 scripted calibration (low, 성공 20개, 공식 timeout)
| 가구 | 에피소드 | 성공률 | 평균 길이 | 성공 1개당 (GPU당) | 300개 GPU·h | 본 수집 분할 |
|---|---|---|---|---|---|---|
| one_leg | 44 | 0.45 | 547 | 70 s | 6 | 2 × 150 (4proc) |
| lamp | 29 | 0.69 | 755 | 89 s | 7.4 | 2 × 150 |
| round_table | 41 | 0.49 | 1199 | 159 s | 13 | 3 × 100 |
| cabinet | 79 | 0.25 | 1356 | 306 s | 28 | 5 × 60 |
acos 입력이 float32 오차로 1을 넘어 NaN → CPU eigh 크래시 → clamp 패치.8.2 파이프라인 (수집 완료 후 실행)
~/.local/bin/gsutil이 깨진 shim이라 PATH에서 제거(익명 gcsfs 폴백); Isaac Gym graphics_device_id는 Vulkan 인덱스라 클라이언트는 CUDA_VISIBLE_DEVICES 없이 물리 GPU 지정; 로그인 포트 8000 점유 → free port.8.3 one_leg 학습 제출
9 업데이트 — pi0.5 학습 진행·첫 평가, LingBot-VA 트랙
9.1 pi0.5 one_leg (run yhc0752v)
| step | loss | grad_norm | 비고 |
|---|---|---|---|
| 0 | 0.108 | 1.28 | pi05_base 초기화 |
| 2000 | 0.016 | 0.10 | 1k step ≈ 18 min |
| 5000 | 0.013 | — | 체크포인트 직후 PREEMPTED → 108562로 재개(--resume) |
9.1b step 5k vs 10k (20 ep, timeout 1000, phase proxy)
| 지표 | 5k | 10k |
|---|---|---|
| 평균 phase (0~4) | 1.60 | 2.45 |
| phase 분포 | 1:10 / 2:8 / 3:2 | 1:1 / 2:9 / 3:10 |
| 다리 들기 >3 cm | 9/20 | 19/20 |
| 테이블탑 8 cm 이내 | 3/20 | 10/20 |
| 3 cm 이내(삽입 직전) | 1/20 | 5/20 |
| 테이블탑 20 cm+ 밀어냄 | 7/20 | 2/20 |
| 성공 | 0 | 0 |
| 체크포인트 (replan 10, 20 ep) | 성공 | 다리 들기 | 접근 <12 cm | <3 cm |
|---|---|---|---|---|
| 10k | 2/20 | 13 | 14 | 2 |
| 20k | 1/20 (518 step) | 17 | 15 | 6 |
9.2 LingBot-VA (video-action world model) 트랙
단일팔 지원 확인(30-D canonical action의 왼팔 슬롯; LIBERO config = Franka 단일팔·2뷰·10 Hz·7-D → FurnitureSim과 동일). 학습은 FlexAttention이라 flash-attn 불필요. lingbot-va-base 24.4 GB 캐시, env lingbot-b200(torch 2.9.0+cu128 sm_100, lerobot 0.3.3).