EgoX long video: prefix 조건 LoRA pilot
TL;DR
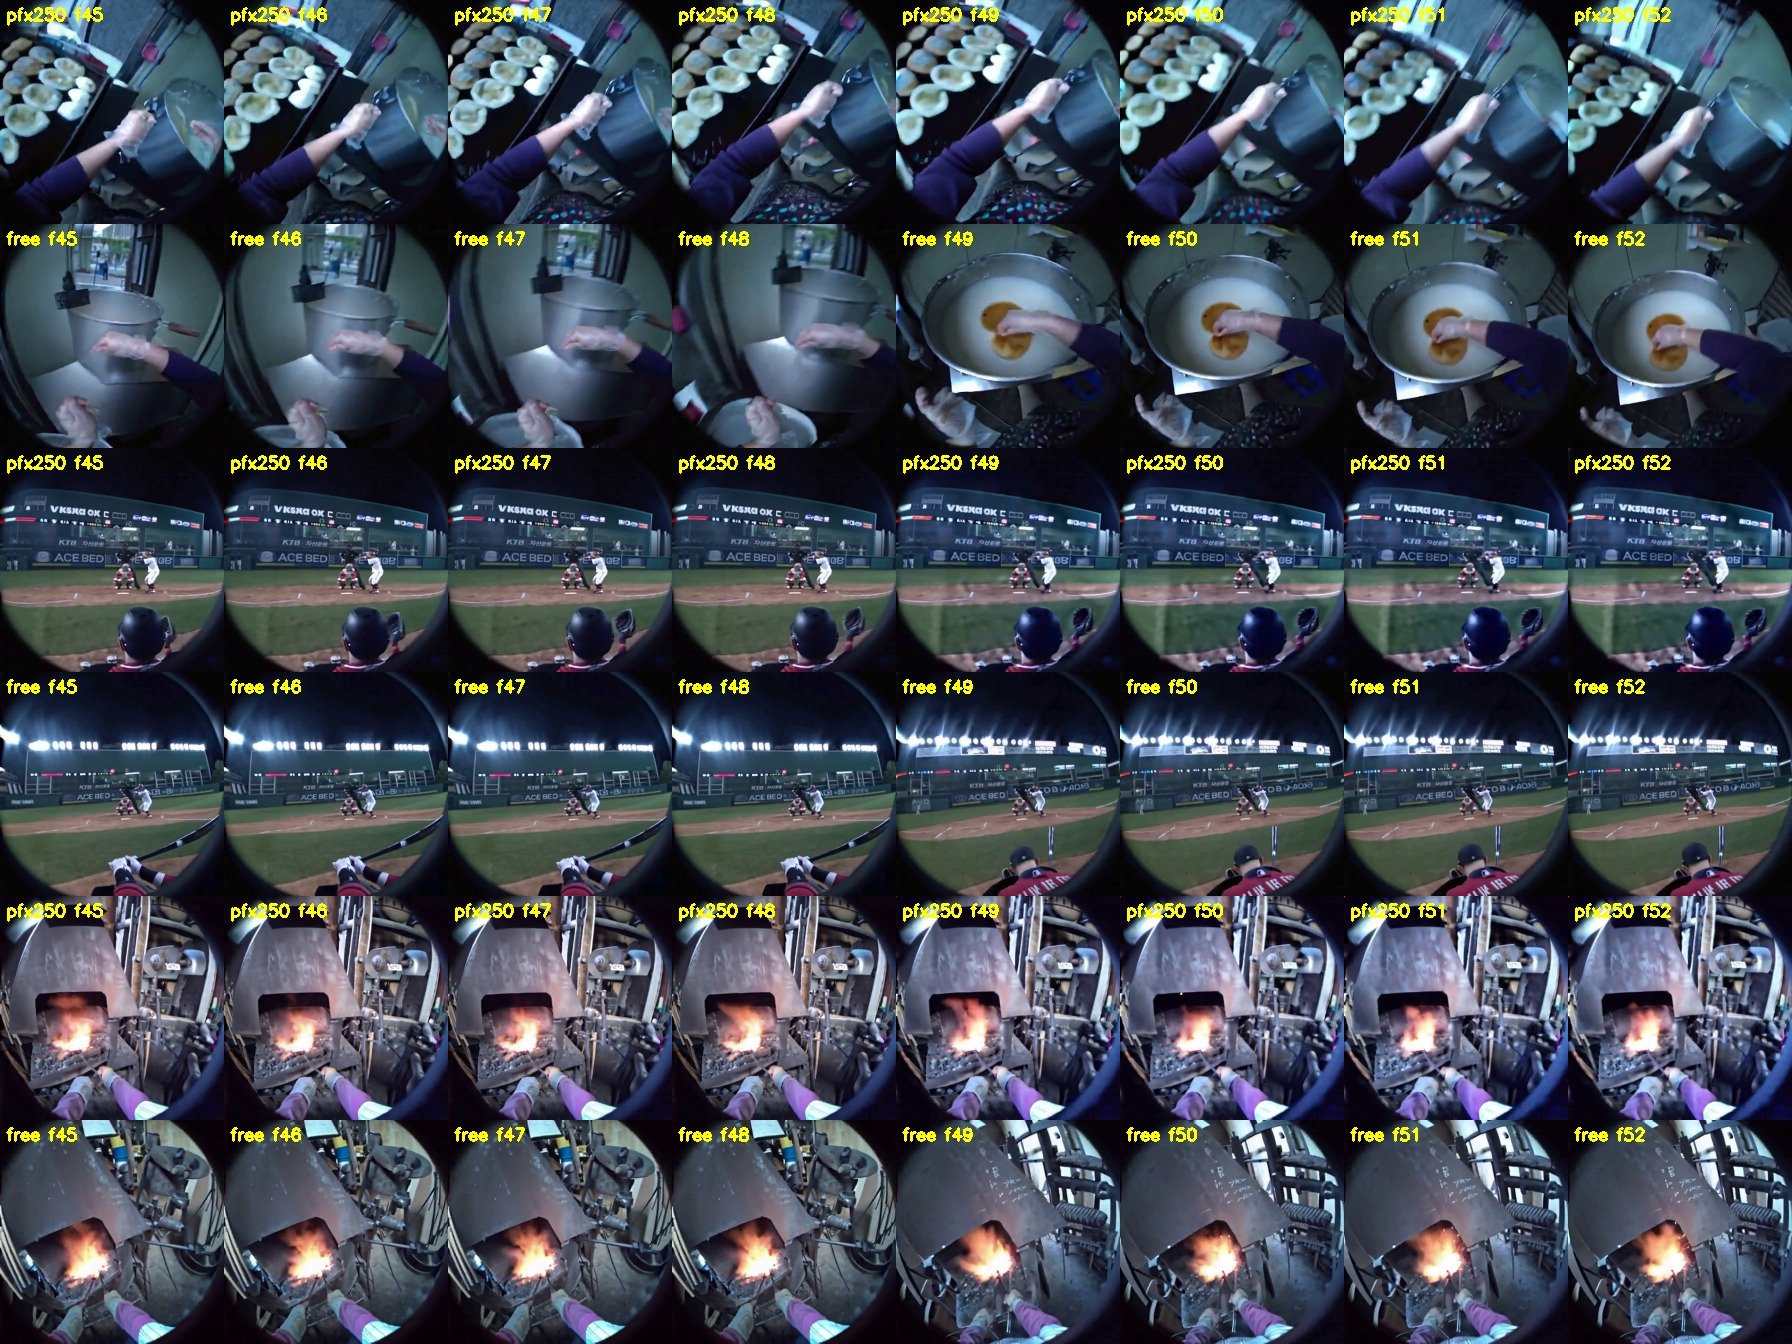
- 경계가 이어진다: 경계 프레임 차이가 chunk 내부 중앙값의 3.5–5.3배에서 0.9–2.7배로 줄었고, 세 클립 모두 장면과 구도가 유지된다. 250 step부터 나타난다.
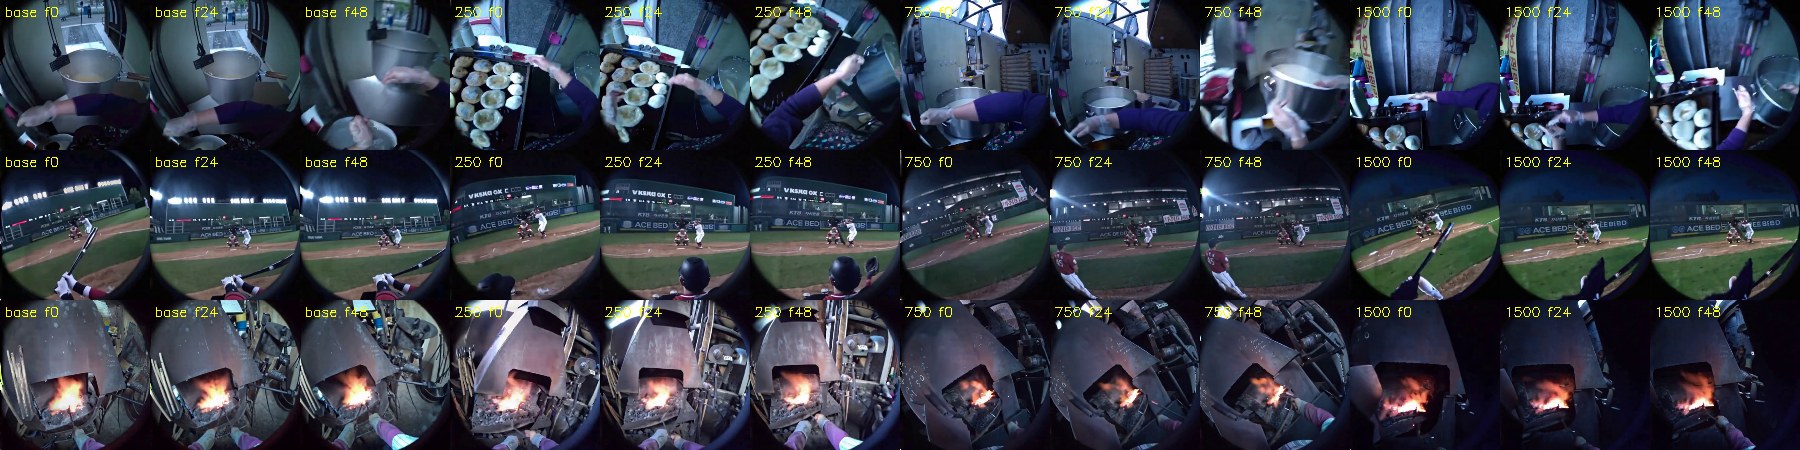
- 오래 학습하면 화질이 무너진다: 처음부터 생성한 첫 chunk의 밝기가 대장간 클립에서 75.2 → 29.0 (step 1,500).
- 판정: 방법은 유효하나 본학습은 불가. 3,510클립으로 늘려도 step 1,500에서 같은 붕괴가 나서, 원인은 데이터 양이 아니라 학습 설정이다.
1 배경 / 목적
학습 없는 overlap 고정은 3클립 모두 실패했다. 모델이 고정된 앞 프레임을 이어받도록 학습된 적이 없기 때문으로 보고, ego 앞 K개 latent를 clean 조건으로 주는 미세조정을 pilot으로 먼저 검증했다.
2 작업 내용
학습 경로에서 기존 버그 3건을 고쳤다: I2V 데이터셋의 is_t2v 미설정(무한 재시도로 1시간 30분 손실), attention map 캐시가 없을 때의 미정의 변수, 학습에서 켜져 있던 kv cache.
do_kv_cache를 True에서 False로 바꿨다. cache가 리셋되지 않아 학습에서는 첫 샘플의 exo 값이 재사용되기 때문이다. checkpoint-10000의 원래 학습 설정은 확인하지 못했다.3 결과
| 경계 차이 (배수) | 학습 전 | step 250 | step 750 | step 1,500 |
|---|---|---|---|---|
| 호떡 | 31.63 (3.5x) | 14.29 (0.9x) | 27.01 (2.1x) | 17.98 (1.2x) |
| 야구장 | 18.52 (4.4x) | 8.76 (2.3x) | 5.41 (1.6x) | 8.52 (2.7x) |
| 대장간 | 33.44 (5.3x) | 14.90 (1.7x) | 7.97 (1.5x) | 4.99 (1.6x) |
| 첫 chunk 평균 밝기 | 기존 LoRA | step 250 | step 750 | step 1,500 |
|---|---|---|---|---|
| 호떡 | 62.1 | 76.3 | 75.1 | 71.0 |
| 야구장 | 59.9 | 54.7 | 52.2 | 47.6 |
| 대장간 | 75.2 | 87.9 | 50.4 | 29.0 |
3b 추가: 3,510클립 세트로 재실행
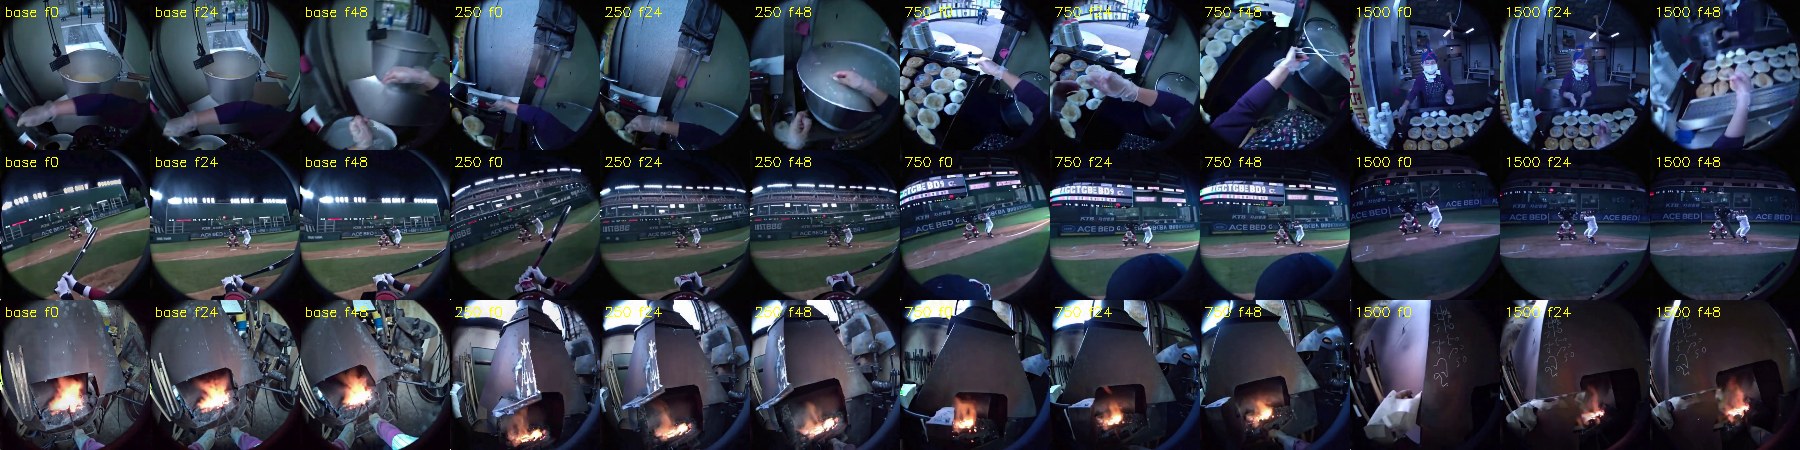
상세 캡션(captions_train.txt, 3,510줄)이 이미 있어 그대로 연결했다. 같은 설정(4 GPU, 1,500 step)으로 약 1.7 epoch 학습했다. 도중에 캐시 이름 충돌 버그(3,510클립이 1,394개 latent로 뭉개짐)를 발견해 고치고 다시 돌렸다.
| 경계 차이 (배수) | 학습 전 | step 250 | step 750 | step 1,500 |
|---|---|---|---|---|
| 호떡 | 3.5x | 3.9x | 0.9x | 2.0x |
| 야구장 | 4.4x | 1.5x | 2.2x | 2.3x |
| 대장간 | 5.3x | 1.7x | 1.5x | 1.2x |
| 첫 chunk 밝기 / 선명도 | 기존 LoRA | step 250 | step 750 | step 1,500 |
|---|---|---|---|---|
| 호떡 | 62.1 / 68 | 62.7 / 65 | 74.3 / 178 | 59.2 / 100 |
| 야구장 | 59.9 / 139 | 47.4 / 146 | 56.6 / 163 | 40.2 / 70 |
| 대장간 | 75.2 / 146 | 75.4 / 152 | 52.5 / 124 | 42.0 / 53 |
4 Takeaway
의미
prefix 조건을 학습에 넣으면 chunk 간 연속성이 생긴다는 것은 확인됐다. 문제는 데이터다. 300클립을 약 20 epoch 반복하면서 처음부터 생성하는 품질이 무너졌다. 과적합이 가장 유력하지만 학습률, kv cache 설정 변경과는 분리하지 못했다.
5 Next Steps
붕괴 원인 분리
prefix 없이(--max_prefix_latents 0) 같은 학습을 750 step 돌리는 대조 실험. 이것도 무너지면 학습 설정(kv cache, 학습률) 문제, 아니면 prefix 조건의 부작용이다. checkpoint-10000의 원래 학습 설정을 확인하는 것이 가장 빠르다.
평가 보강
seed 3개 이상, 3 chunk(129프레임) 누적 drift, 첫 chunk 품질의 정량 지표.