EgoX long video: 학습 없는 overlap 조건
TL;DR
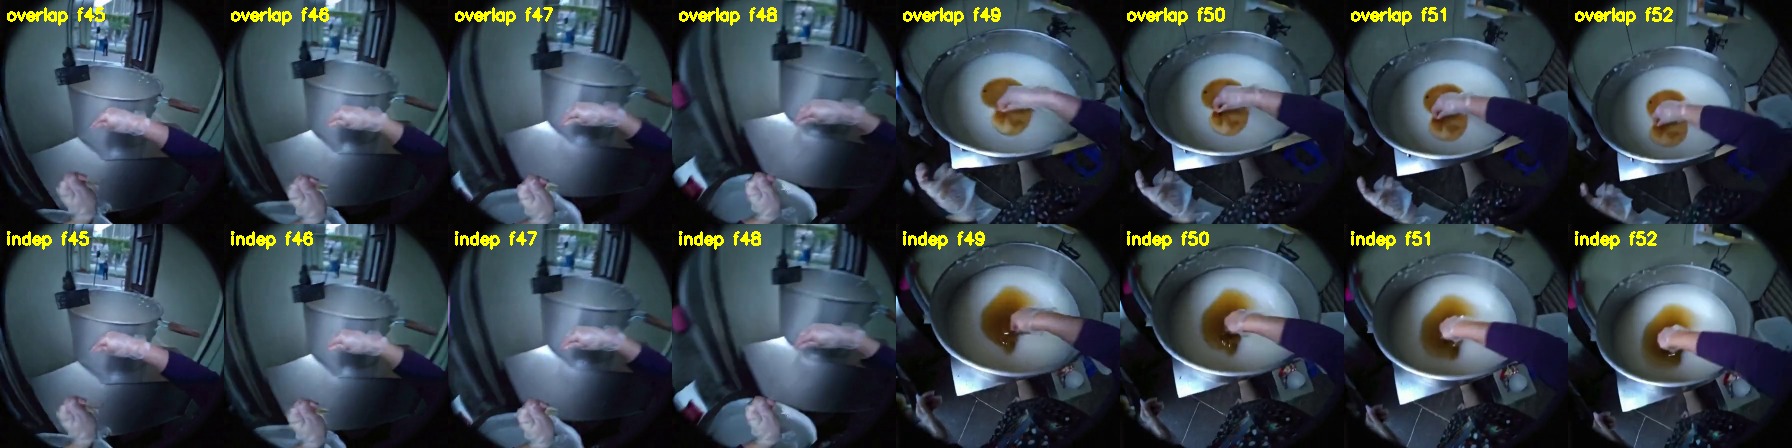
- overlap 주입은 동작: 다음 chunk의 앞 9프레임이 이전 chunk 끝과 37–39 dB로 일치 (독립 chunk는 14–15 dB).
- 모델이 이어받지 못함: 겹친 구간이 끝나자마자 다른 장면으로 튄다. 경계 프레임 차이 31.6 vs 독립 chunk 36.1, chunk 내부 중앙값 9.0.
- 49프레임 경로는 그대로: 수정 전 결과와 49프레임 전부 픽셀 단위 동일. 앞단은 89프레임에서 수정 없이 동작.
1 배경 / 목적
이 레포의 EgoX는 49프레임 고정이다. 49프레임보다 긴 ego 영상을 학습 없이 만들 수 있는지 확인했다. 이전 chunk의 끝을 다음 chunk의 앞에 고정하는 방식(B)을 골랐다.
2 작업 내용
이전 chunk의 디코딩된 ego 끝 9프레임을 VAE로 다시 인코딩해 latent 3칸을 얻고, 디노이즈 매 step마다 ego 영역 앞 3칸을 현재 noise 수준으로 섞은 값으로 덮어쓴다. 마지막에는 clean 값으로 고정한다.
3 결과
| 항목 | overlap 조건 (B) | 독립 chunk (A) |
|---|---|---|
| chunk 1 앞 9프레임 vs chunk 0 끝 9프레임 (PSNR) | 37.1–38.9 dB | 13.7–15.5 dB |
| 이어붙인 영상의 경계(48→49) 프레임 차이 | 31.63 (3.5x) | 36.10 (4.0x) |
| chunk 내부 프레임 차이 중앙값 / p95 | 9.03 / 16.23 | 9.11 / 17.27 |
| 선명도 (프레임 0–39 → 40–79) | 72 → 54 | 72 → 54 |
3b 추가: prior가 좋은 클립 2개
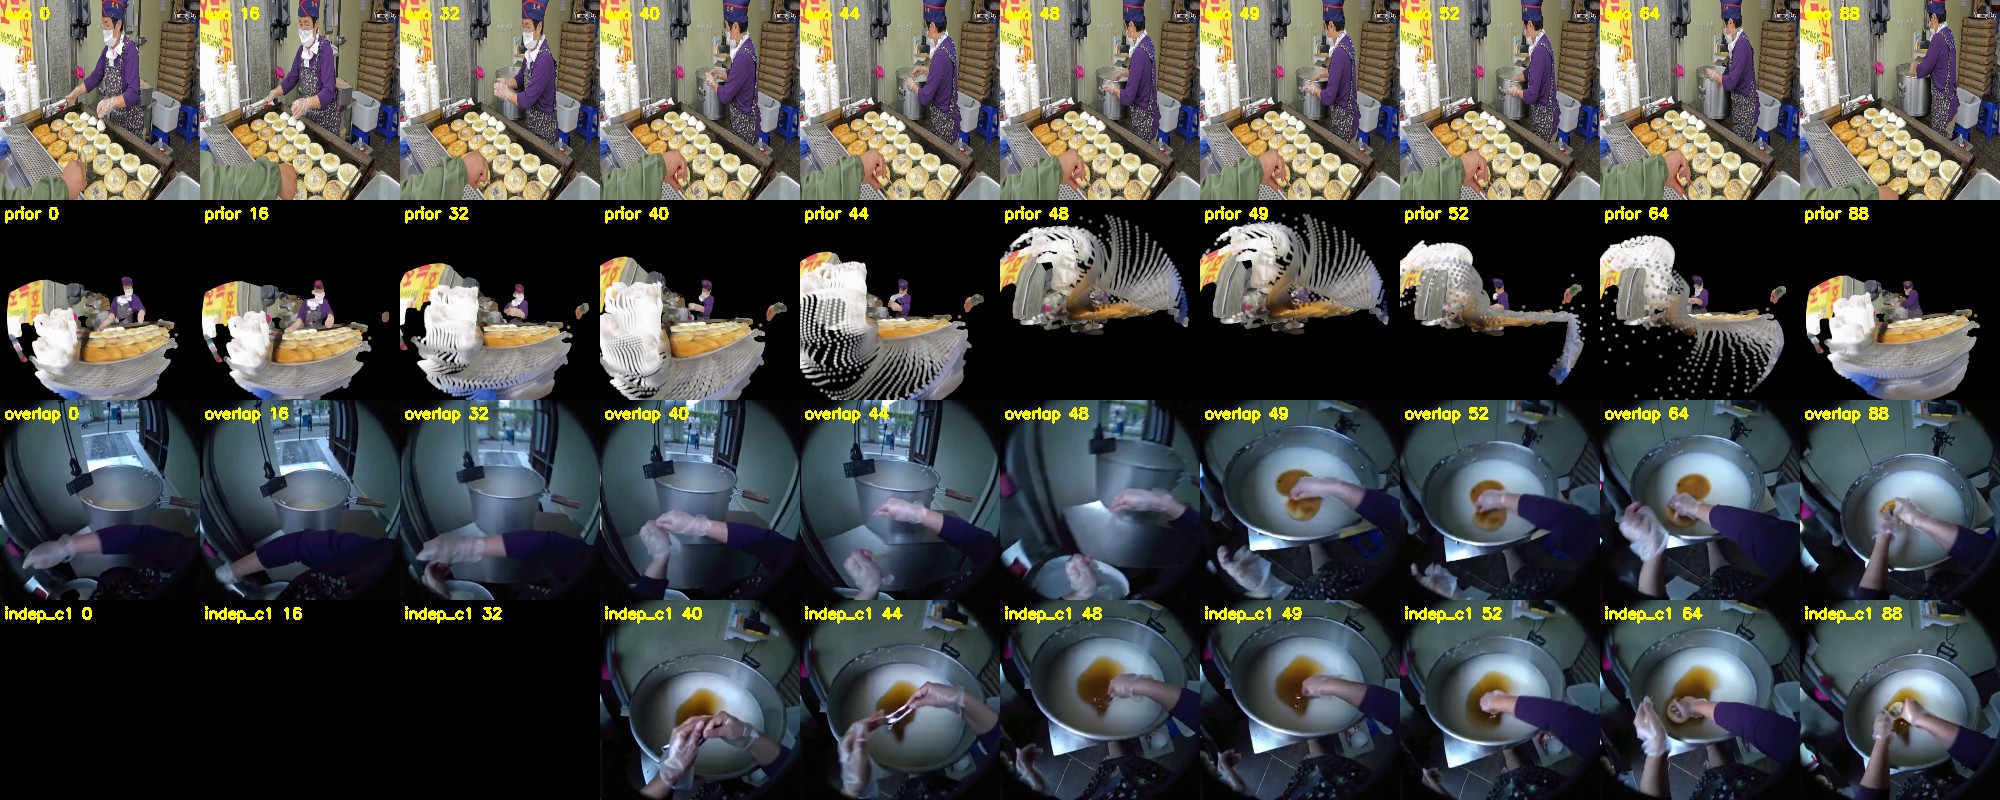
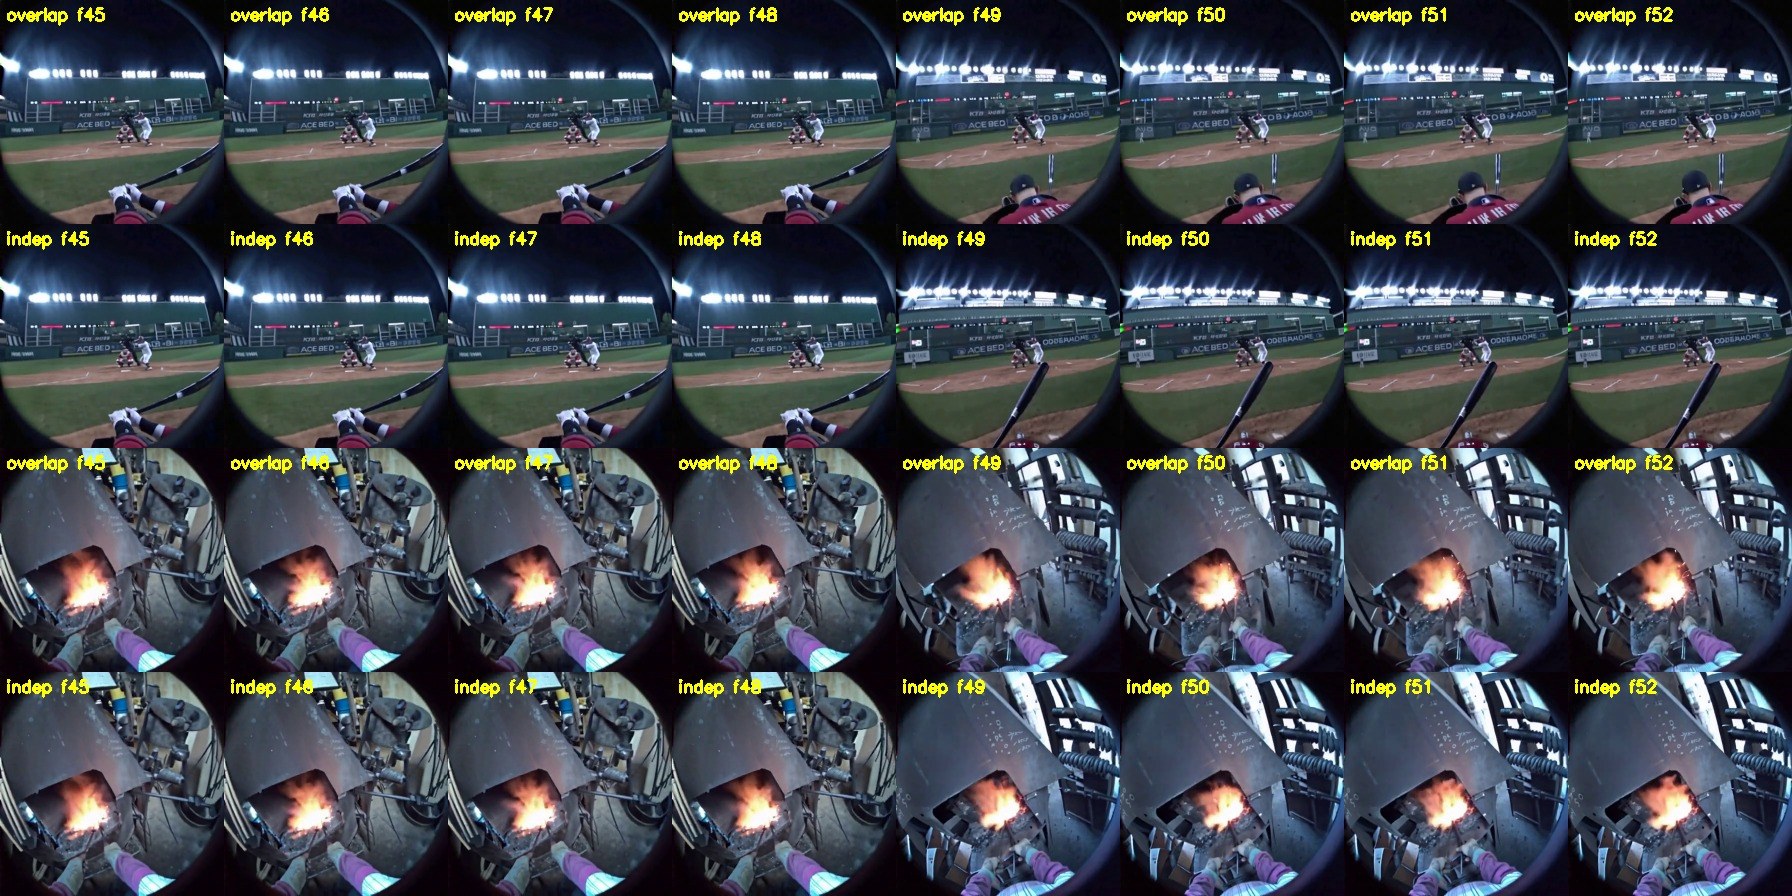
호떡 클립은 prior가 약했다(prior가 있는 픽셀의 |prior − 결과| 평균 102.0, 후보 9개 중 최악). prior가 잘 맞는 야구장(48.3), 대장간(51.7) 클립으로 같은 비교를 반복했다. 수동 pose 클립은 annotation이 49프레임까지만 있어 쓰지 못했다.
| 클립 | 방식 | 겹친 9프레임 PSNR | 경계 차이 | 내부 중앙값 | 배수 |
|---|---|---|---|---|---|
| 호떡 | overlap | 37.1–38.9 | 31.63 | 9.03 | 3.5x |
| 호떡 | 독립 | 13.7–15.5 | 36.10 | 9.11 | 4.0x |
| 야구장 | overlap | 37.1–37.7 | 18.52 | 4.24 | 4.4x |
| 야구장 | 독립 | 15.5–15.6 | 23.79 | 4.27 | 5.6x |
| 대장간 | overlap | 34.6–36.0 | 33.44 | 6.32 | 5.3x |
| 대장간 | 독립 | 12.1–12.5 | 41.62 | 6.20 | 6.7x |
4 Takeaway
의미
학습 때 ego 영역은 항상 전 프레임이 같은 noise 수준이었다. "앞은 clean, 뒤는 noise"인 상태에서 앞을 이어받도록 배운 적이 없으므로, 추론에서만 앞을 고정해도 연속성이 생기지 않는다는 것과 맞는 결과다. 3클립(seed 1개) 모두 같은 결과였고 prior 품질과 무관했다.
chunk 방식은 prior가 장면을 충분히 고정한다는 전제에 기대고 있다. prior가 약한 클립에서는 독립 chunk 방식도 쓸 수 없다.
5 Next Steps
prefix 조건 미세조정
compute_loss에서 ego 앞 K개 latent를 clean으로 두고 loss에서 빼는 LoRA 미세조정을 checkpoint-10000에서 이어서 한다. EgoX_wan2.2_long과 같은 방식이다.