B200 이전: in-the-wild 재현 + SAM3D 자동 ego pose 파이프라인
TL;DR
- in-the-wild 재현: 수동 ego pose 10클립 전부 생성 확인 (
results/261004_itw_42/). - 자동 파이프라인: exo 영상 하나 → ViPE → SAM 3D Body head pose → ego prior → 캡션 → 생성까지
scripts/auto_ego/run.sh한 줄, 워커 1 GPU에서 14분. - 캘리브레이션: 수동 annotation 11클립 대비 축 변환·스케일은 일치, 회전은 중앙값 27.3° 차이(클립별 7.4~58.6°).
1 배경 / 목적
Exo-to-Ego_Wan2.1_finetune 레포를 H200에서 B200(~/repos/EgoX_H200)으로 옮긴 뒤 두 가지가 필요했다. (1) in-the-wild 데모가 다시 나오는지 확인, (2) 리버탈 때 시도한 SAM 3D Body 기반 ego pose 추정을 영상 입력부터 생성까지 자동으로 잇기.
vipe visualize --ego_manual로 프레임마다 손으로 찍었다. 리버탈용 SAM3D 코드는 head pose json 경로가 한 클립으로 고정, 스케일 정합 없음, 렌더러는 viser 무한 대기, prior/meta 저장 단계 없음, inference_sam3d.py는 모델 로드가 꺼진 덤프 전용이었다.2 작업 내용
in-the-wild 재현
자동 ego pose 파이프라인 (scripts/auto_ego/)
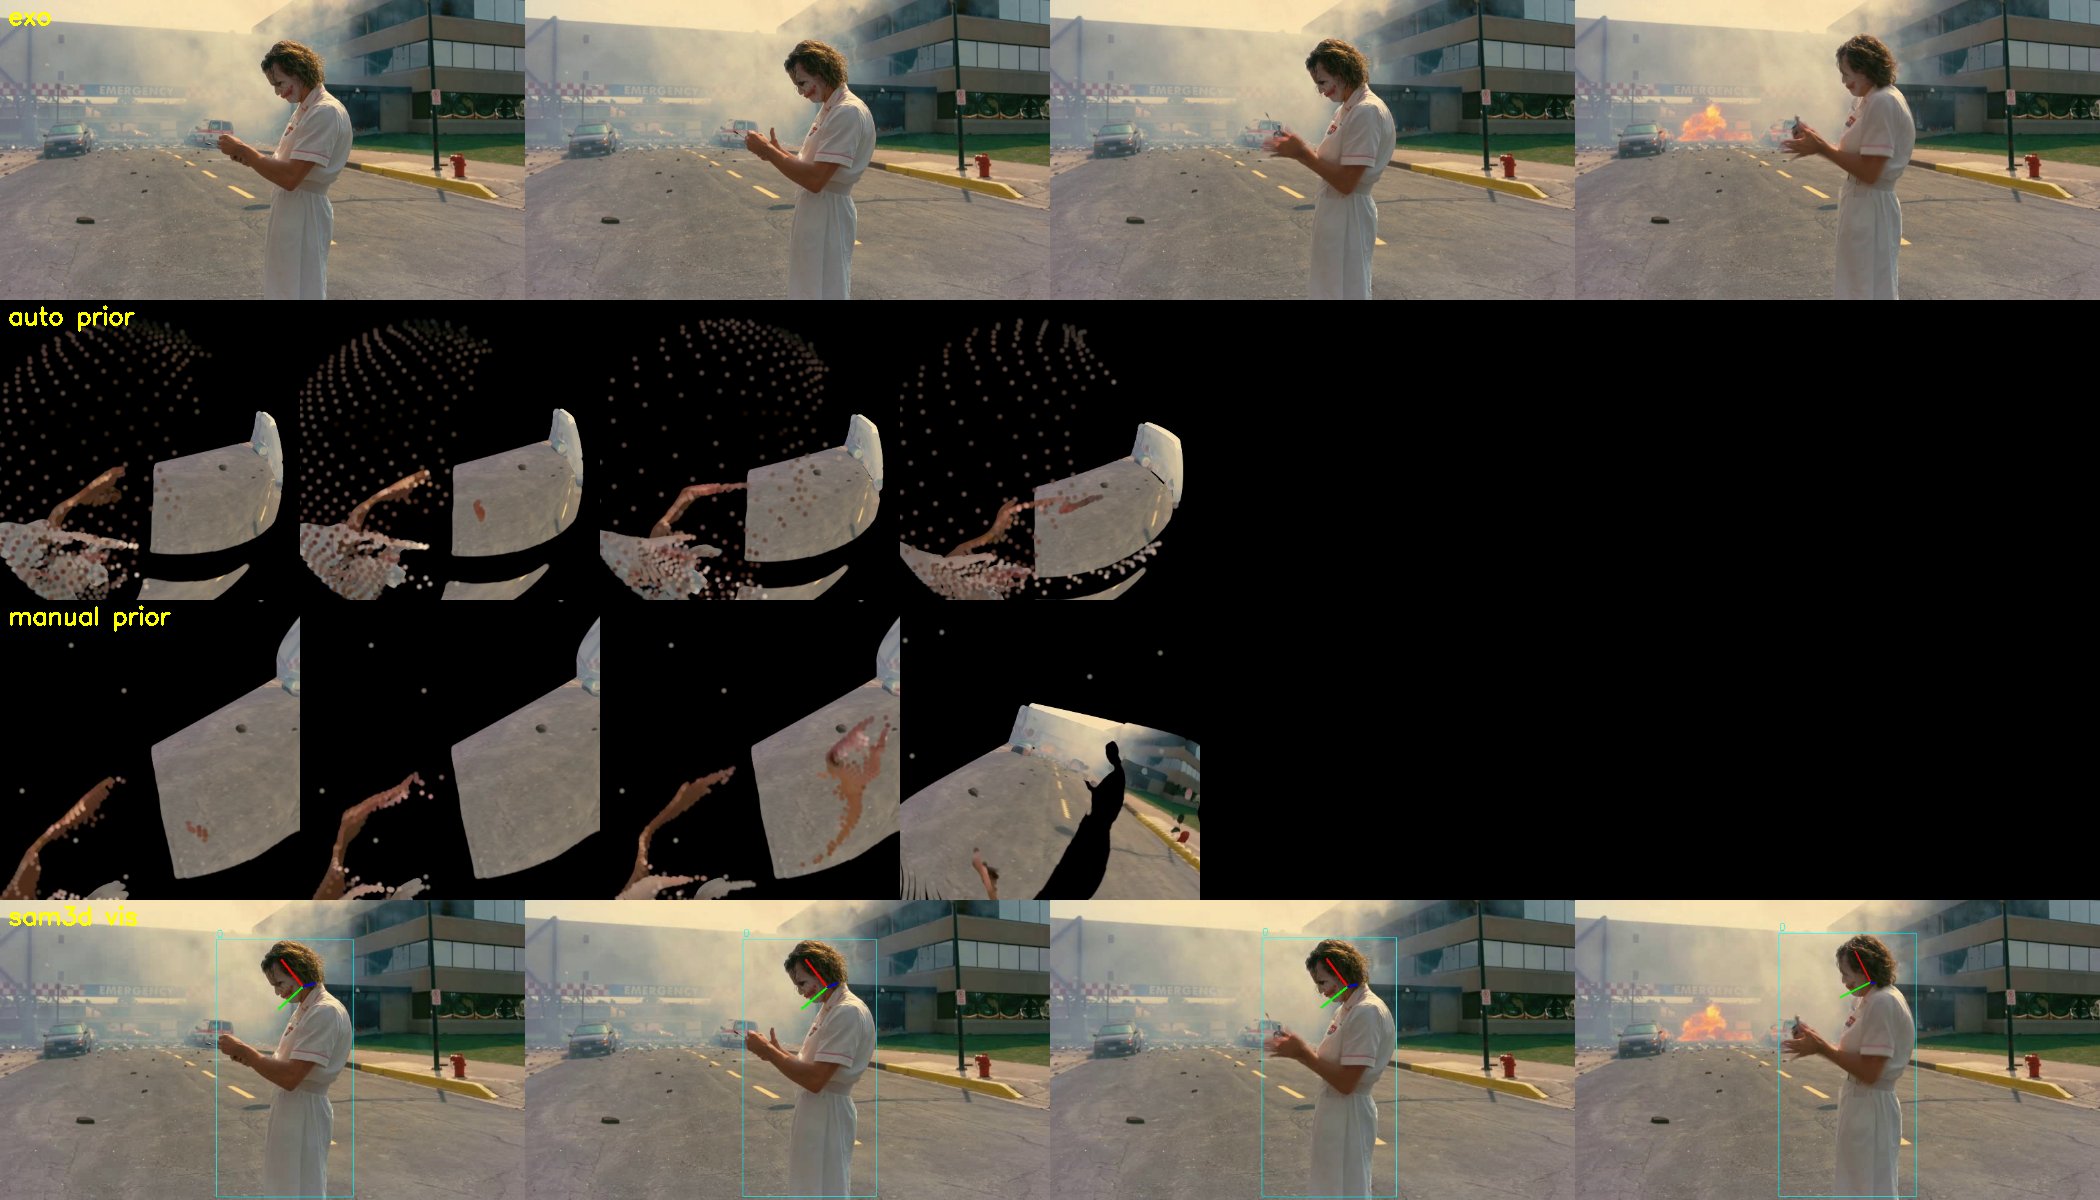
렌더러는 학습 prior와 같은 분포를 유지하려고 kdh8156/EgoX-EgoPriorRenderer를 클론해 썼다. 축 변환·눈 오프셋·스케일 방식은 수동 annotation이 있는 11클립에 SAM3D를 돌려 대조한 값으로 정했다.
3 결과
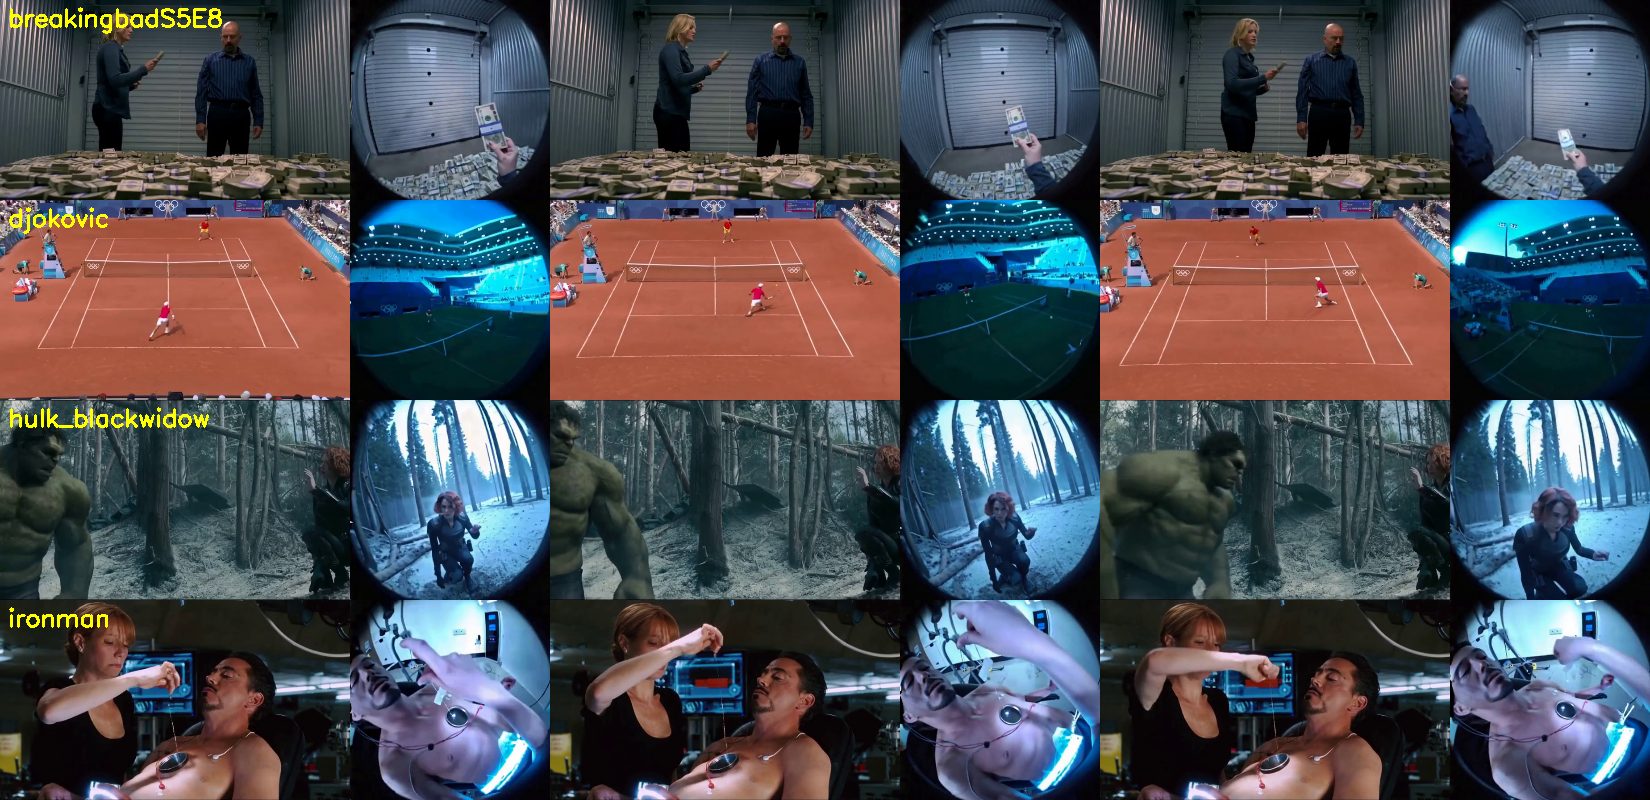
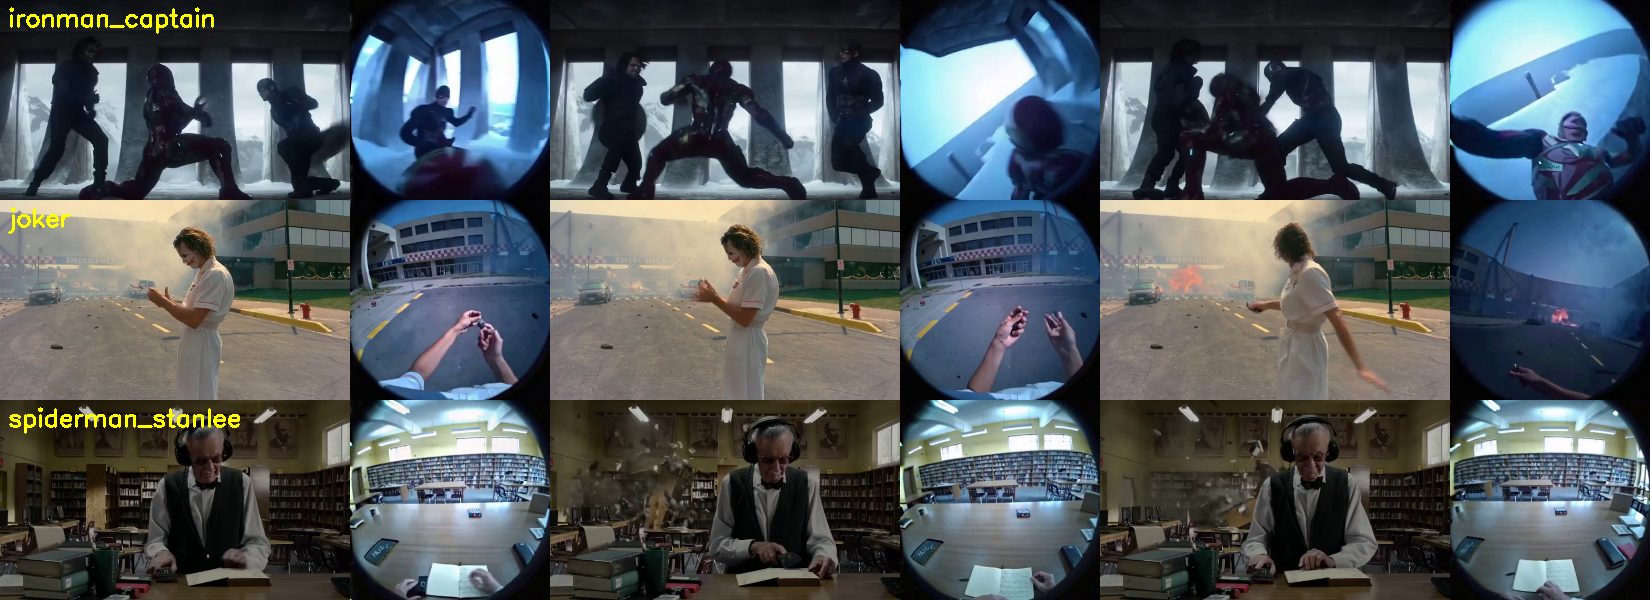
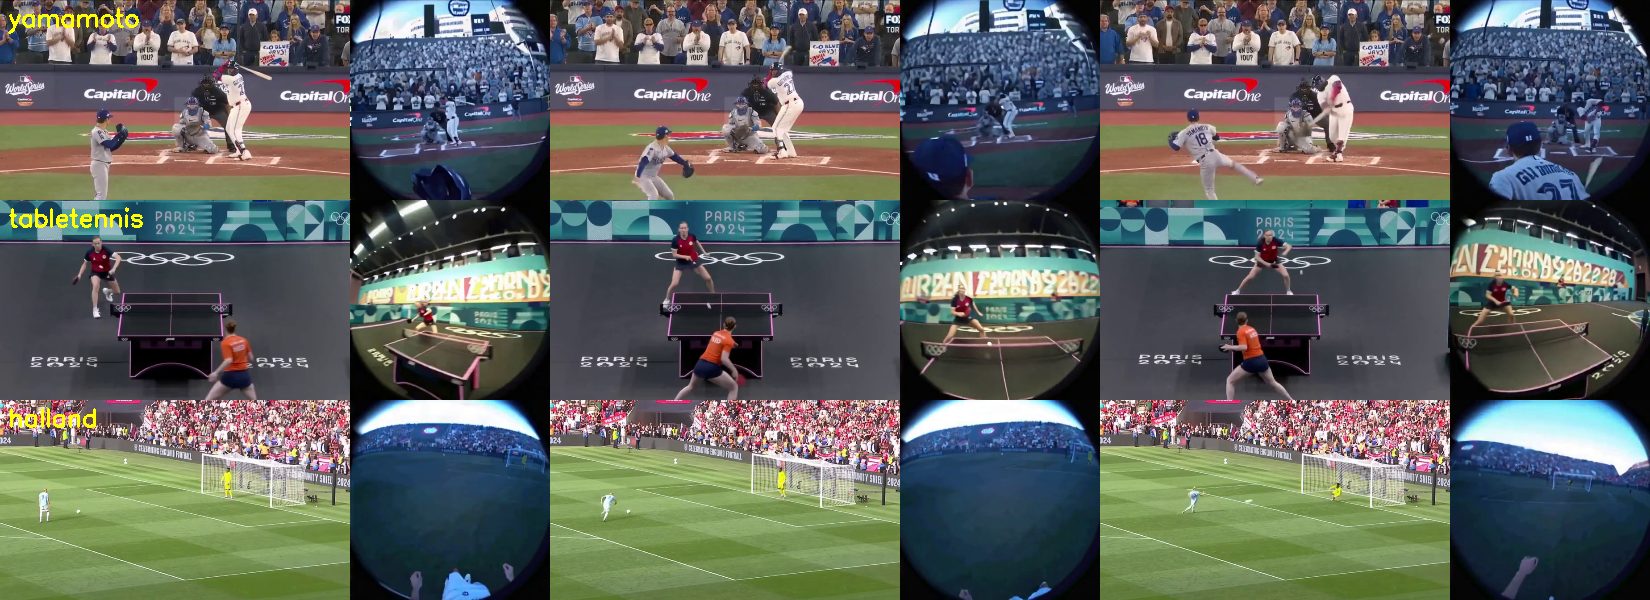
in-the-wild 재현 (수동 pose)
약 9.0 s/it × 50 step, 클립당 7.5분 (GPU 메모리 68 GiB). 10개 클립 모두 ego 시점으로 손·물체·배경이 생성됐다.
SAM3D vs 수동 annotation
| 클립 | 회전 차이 중앙값 | 수동/SAM3D 거리 비 | depth 보정 배율 |
|---|---|---|---|
| breakingbadS5E8 | 7.4° | 0.958 | 1.038 |
| joker | 13.9° | 1.272 | 1.251 |
| djokovic | 14.2° | 0.902 | 0.899 |
| halland | 15.4° | 0.911 | 0.911 |
| ironman_captain | 23.8° | 2.172 | 2.069 |
| tabletennis | 27.3° | 1.193 | 1.192 |
| ironman | 33.4° | 1.265 | 1.155 |
| spiderman_stanlee | 37.8° | 0.898 | 0.973 |
| yamamoto | 40.8° | 0.906 | 0.895 |
| hulk_blackwidow | 58.6° | 4.058 | 4.004 |
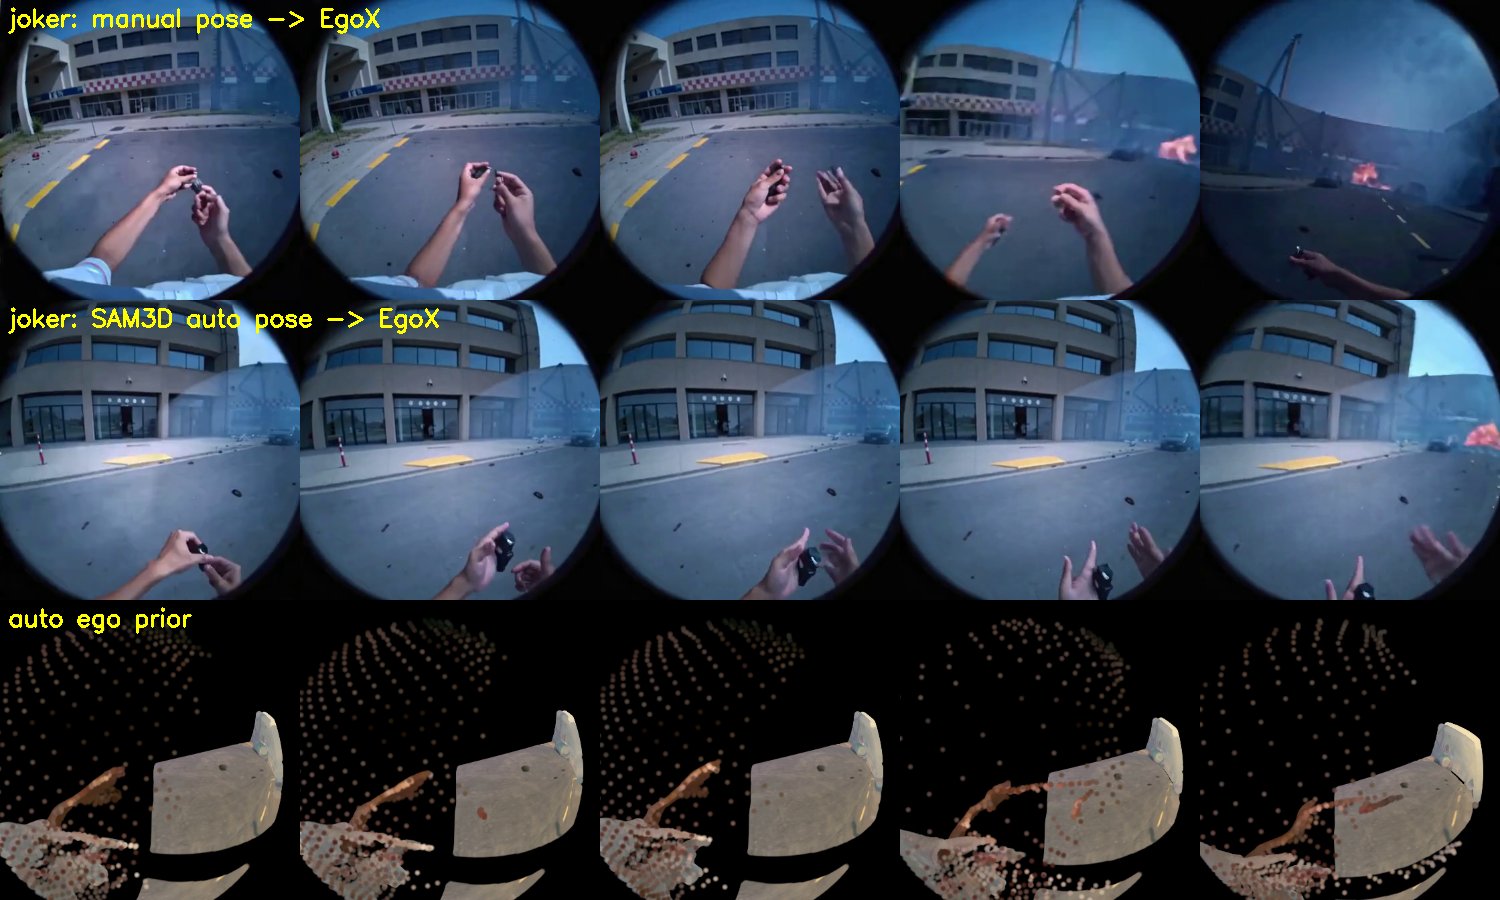
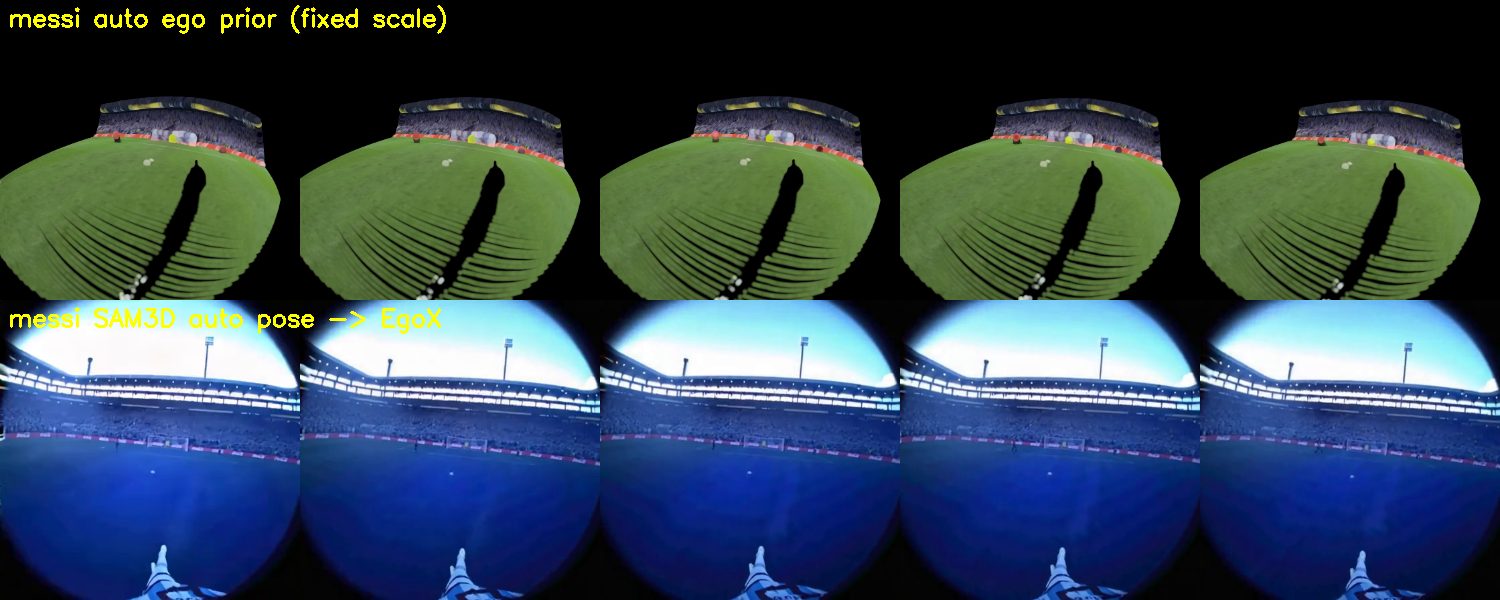
자동 파이프라인 생성 결과
4 Takeaway
의미
B200에서 데모가 재현되고, 수동 annotation 없이 exo 영상에서 ego 영상까지 한 job으로 나온다. SAM3D의 metric 위치는 그대로 쓰면 최대 4배 어긋나므로 ViPE depth 기준 스케일 보정이 필수다. 재현 실패 두 건(cos_sim 크래시, meta 순서 불일치)은 서버 이전과 무관한 코드·데이터 상태 문제였다.
~/template.sh가 inner 명령의 종료 코드를 넘기지 않아 크래시한 job도 sacct에 COMPLETED로 찍힌다.
5 Next Steps
미해결 한계
회전 차이(중앙값 27°)가 수동 annotation의 주관(시선·손 쪽으로 기울임) 때문인지 SAM3D 오차인지 구분하지 못했다. 자동 prior는 수동 prior보다 바닥을 넓게 잡고 하늘 쪽 점이 드문드문 찍히는데 렌더 설정 차이인지 미확인. 여러 사람 장면의 ego 대상 지정은 규칙 4가지뿐이다. inference_all_fast.py는 depth intrinsic을 Ego4D GT로 고정해 쓴다.
다음 작업
수동 annotation이 있는 10클립 전체에 자동 파이프라인을 돌려 결과를 나란히 비교하고, 회전 차이가 생성 품질에 주는 영향을 본 뒤 pitch 보정 옵션 여부를 결정.